The PHP Book
Voici mon monde, et vous y êtes les bienvenus.
Avant-propos
Vous allez apprendre le langage qui fait tourner le web.
Ce n’est pas une image. Une grande partie des sites que vous visitez chaque jour sont écrits en PHP : Wikipédia, d’innombrables boutiques en ligne, la plupart des blogs. WordPress, à lui seul, fait tourner plus de quatre sites sur dix. Vous n’y avez probablement jamais pensé, et c’est normal. PHP fait son travail sans se faire remarquer, depuis trente ans.
Vous en avez peut-être entendu du mal. Il y a une raison à cela. Le PHP d’il y a quinze ans était brouillon, tolérant jusqu’à l’absurde, et beaucoup de gens ont appris à le détester à cette époque. Ce qu’ils ne savent pas toujours, c’est à quel point le langage a changé depuis. Le PHP d’aujourd’hui est propre, rapide, typé, agréable à écrire. La réputation est restée sur place. Le langage, lui, est parti loin devant.
Le PHP dont on dit du mal n’existe presque plus. Le PHP que vous allez apprendre, peu de gens le connaissent vraiment.
C’est une bonne nouvelle pour vous : vous partez de zéro, sans rien à désapprendre. Et vous êtes entre de bonnes mains. J’ai passé une grande partie de ma vie avec ce langage, à l’écrire, à l’enseigner, à analyser le code des autres, et à le regarder grandir. Je sais où sont les pièges, et surtout, je sais ce qu’il faut comprendre pour passer à côté.
Ce livre ne vous demandera jamais de recopier du code sans le comprendre. Chaque idée y est expliquée une fois, mais pour de bon, avec un dessin chaque fois qu’un dessin dit mieux les choses qu’un paragraphe. Vous avancerez par petits programmes qui marchent, du premier « Hello, world! » jusqu’à un vrai site web construit de vos mains.
Il ne vous faut rien d’autre qu’un ordinateur, un peu de curiosité, et l’envie de voir ce qui se passe quand on appuie sur Entrée.
Alors ouvrez un terminal, installez PHP, et commençons.
Introduction
En ce moment même, quelque part, quelqu’un ouvre une page web. Une boutique en ligne, un blog, une encyclopédie. Derrière une bonne partie de ces pages, un petit programme vient de se réveiller, a fait son travail en quelques millisecondes, a envoyé sa réponse, puis a disparu. Il y a de fortes chances qu’il ait été écrit en PHP.
Ce rythme, se réveiller, travailler, disparaître, c’est le cœur de PHP sur le web. Autant le comprendre tout de suite : il explique une bonne partie du caractère du langage.
Imaginez un serveur de restaurant sans aucune mémoire. Un client arrive, le serveur prend la commande, la prépare, l’apporte, et oublie tout aussitôt. Le client suivant est accueilli exactement comme s’il était le premier de la journée. Rien ne traîne de la commande précédente : ni miettes, ni assiette sale, ni conversation en suspens.
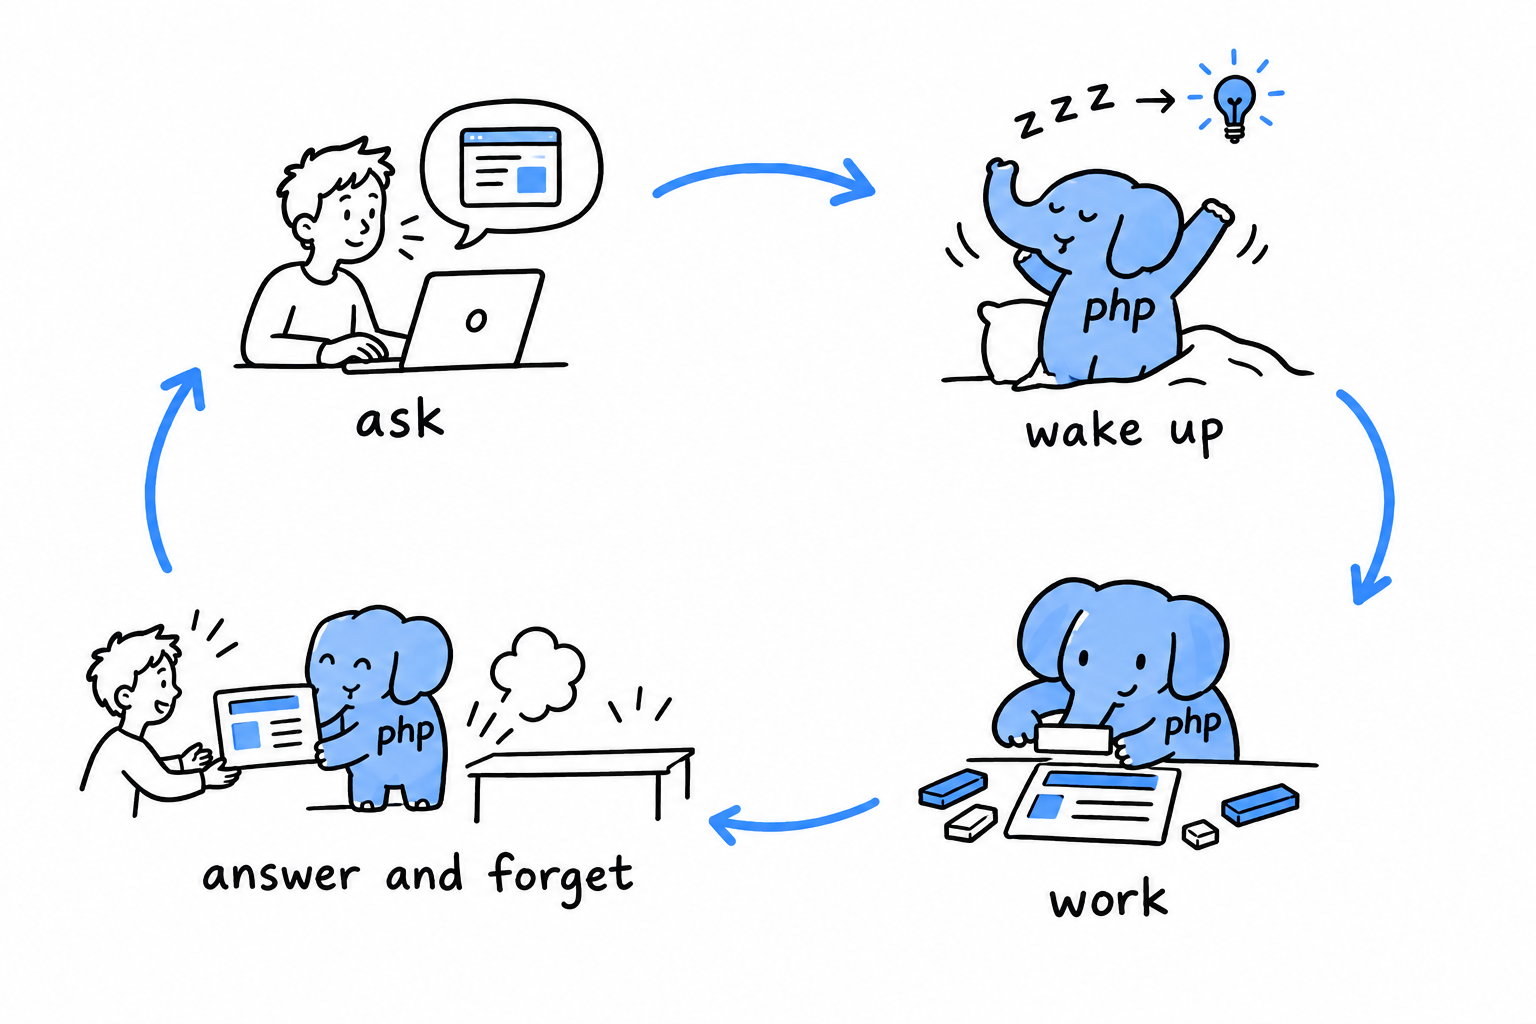
Une page PHP fonctionne exactement ainsi. À chaque visite, le programme démarre de zéro, s’exécute de haut en bas, puis tout est jeté. Dit comme ça, on dirait du gaspillage. En réalité, c’est l’une des façons les plus solides qu’on ait trouvées pour servir des millions de personnes par jour : un bug ne gâche qu’une visite au lieu de contaminer tout le serveur, et s’il faut absorber plus de monde, on ajoute des serveurs de salle.
Un programme PHP naît pour un visiteur, lui répond, puis oublie. Le suivant repart d’une page blanche.
Le web est la maison de PHP, mais PHP ne s’arrête pas là. C’est aussi un très bon langage pour les petits outils qu’on lance depuis un terminal : renommer mille fichiers, lire un export de tableur, envoyer une série de courriels, faire le ménage dans un dossier. Pas de navigateur, pas de serveur web. Un script, et son résultat.
C’est par là que ce livre commence, et ce n’est pas un hasard. Dans un terminal, vous tapez une commande et la réponse s’affiche juste en dessous. Ce retour immédiat est la façon la plus rapide d’apprendre un langage. Le web, avec ses requêtes, ses pages et ses formulaires, viendra ensuite, quand le langage vous sera devenu familier.
Pour commencer, une seule compétence est nécessaire : savoir ouvrir un terminal et y taper une commande. Si vous savez entrer dans un dossier avec cd et lancer un programme, vous avez tout ce qu’il faut.
Inutile d’avoir déjà programmé. Si vous n’avez jamais écrit une ligne de code, les premiers chapitres construisent chaque idée depuis le début, et la suite ne suppose jamais que vous avez sauté des pages. Si vous connaissez déjà un autre langage, vous reconnaîtrez les grandes formes (variables, boucles, fonctions) et vous irez plus vite, en guettant les endroits où PHP fait les choses à sa façon.
Apprendre un langage, c’est un peu comme apprendre à faire du vélo. Personne ne commence par la physique de l’équilibre. On monte, on vacille, on fait quelques mètres. Les explications deviennent lumineuses une fois qu’on a senti la machine bouger. Ce livre suit le même ordre.
D’abord on roule. Ensuite on comprend pourquoi le vélo tient debout.
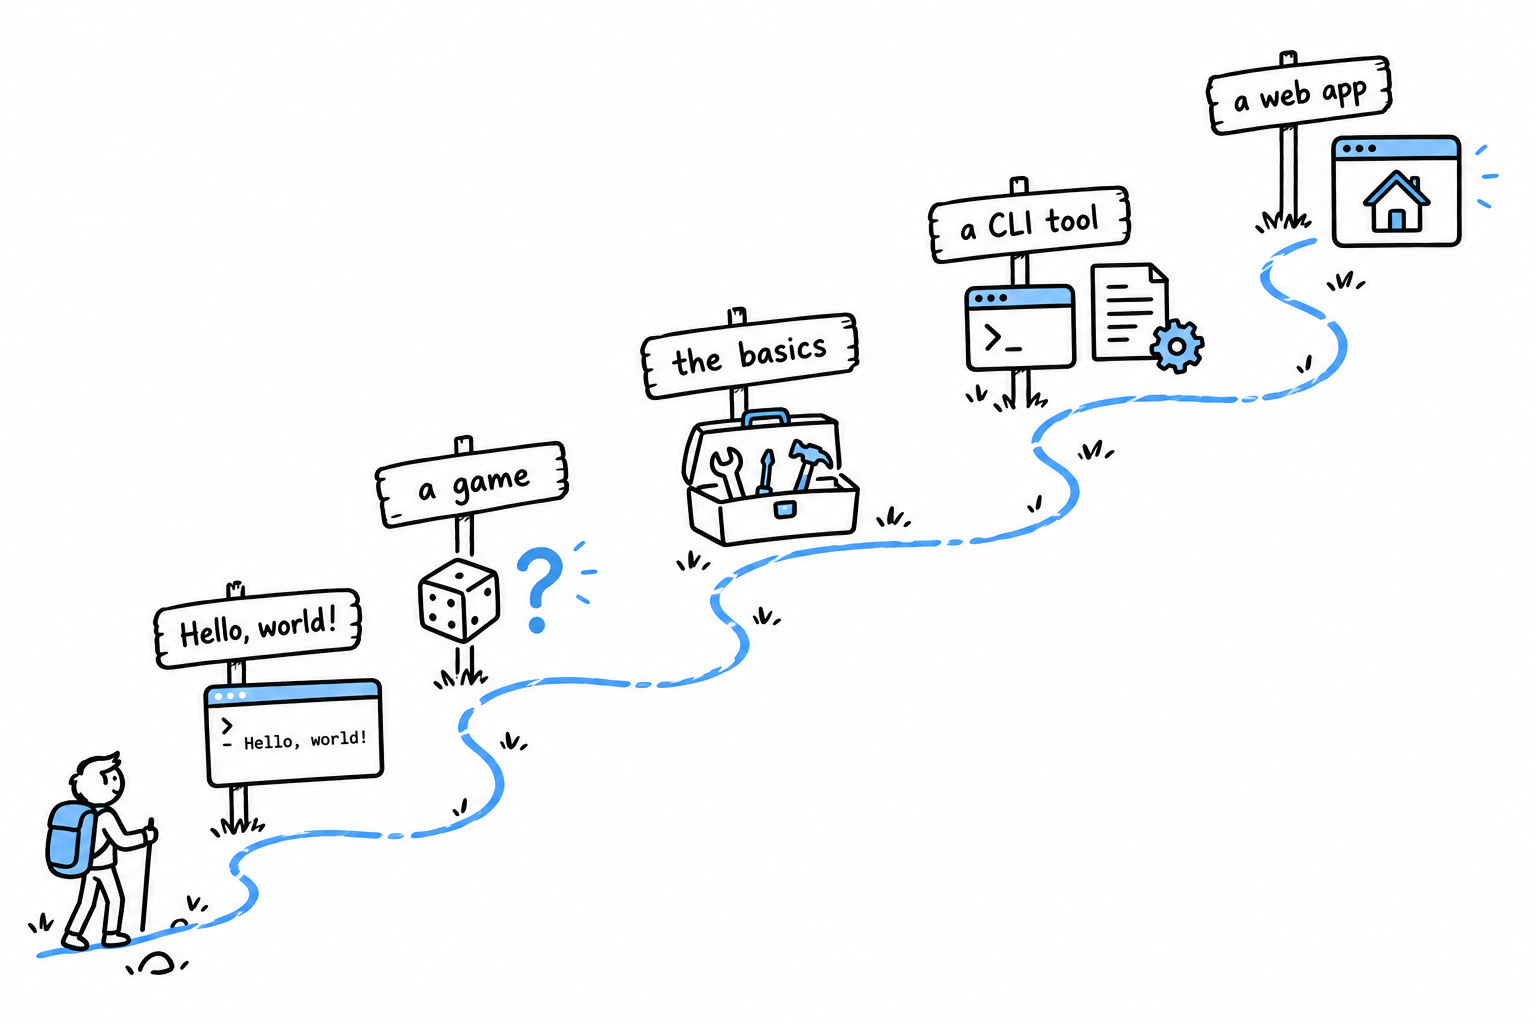
- Un premier programme. Installer PHP et lui faire afficher une phrase.
- Un petit jeu. Un jeu de devinette en trente lignes, écrit avant même de connaître le sens de la plupart des mots.
- Les fondamentaux. Chaque pièce de ce jeu (variables, types, décisions, boucles, fonctions), expliquée pour de bon, maintenant que vous l’avez vue fonctionner.
- Un vrai outil. Un programme en ligne de commande qui lit des fichiers et gère les erreurs comme un logiciel qu’on utilise vraiment.
- Une application web. Un petit site construit à partir de rien, sans framework pour cacher ce qui se passe.
Chaque projet est plus ambitieux que le précédent, et aucun n’utilise autre chose que ce que vous avez déjà vu.
Il y a deux façons de lire ce livre.
Si PHP est votre premier langage, lisez-le dans l’ordre. Chaque chapitre s’appuie sur les précédents, et les projets de la fin sont bien plus faciles quand les bonnes habitudes sont prises tôt.
Si vous programmez déjà et voulez seulement savoir comment PHP s’y prend (comment se comportent ses types, ce qui distingue ses objets de ses tableaux, à quoi ressemble sa syntaxe moderne), utilisez-le comme une référence et allez directement au chapitre qui vous intéresse. Les chapitres se suffisent à eux-mêmes autant que possible, et renvoient aux pages précédentes quand ils s’appuient dessus.
Une dernière chose avant de commencer : installez PHP. Le chapitre 1 explique comment, en quelques minutes. Ensuite, gardez un terminal ouvert à côté du livre et exécutez chaque exemple au moment où vous le rencontrez.
Lire un livre sur la natation n’a jamais appris à nager. Lire un livre sur PHP n’apprend pas PHP. Le taper, si.
Premiers pas
Passons à l’écriture.
Il vous faut trois choses, et vous en avez sûrement déjà deux : un terminal, un éditeur de texte, et PHP.
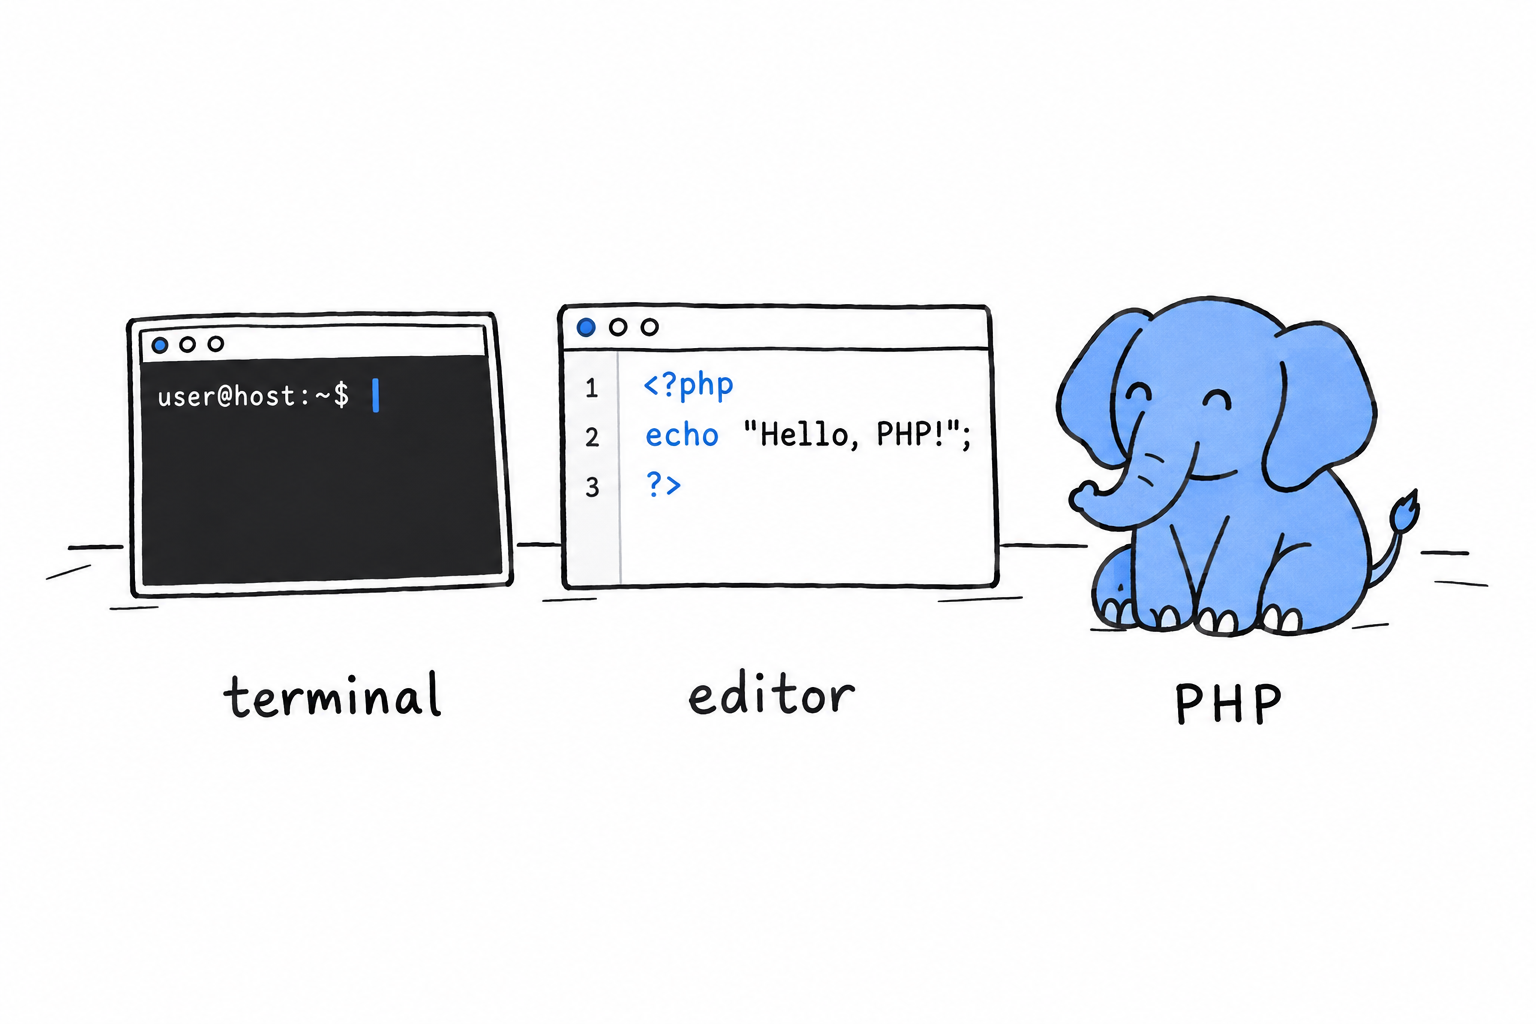
Le terminal, c’est là que vous lancerez vos programmes.
L’éditeur de texte, c’est là que vous les écrirez. N’importe quel éditeur capable d’enregistrer du texte brut fait l’affaire. Si vous n’en avez pas de préféré, Visual Studio Code est gratuit et tourne partout.
PHP, c’est le programme qui lit vos fichiers et exécute ce qu’ils disent. L’installer est la seule vraie préparation de tout le livre.
Regardez ce qui manque à cette liste. Pas de serveur web, pas de framework, pas d’outil de build. PHP est né sur le web et la plupart du code PHP finit par y servir des pages, mais pour apprendre le langage, vous n’avez besoin ni d’Apache, ni de nginx, ni d’un navigateur. Tout ce chapitre se passe dans le terminal, et c’est voulu : un terminal répond tout de suite, et c’est quand les réponses arrivent tout de suite qu’un langage devient clair.
Pas de serveur web, pas de framework, pas d’outil de build. Un terminal, et un langage qui répond du tac au tac.
Note
Ce livre suppose PHP 8.1 ou plus récent. PHP a trente ans, et Internet déborde de tutoriels dont le code ne fonctionne plus, ou pire, fonctionne encore mais que plus personne n’écrirait aujourd’hui. Ici, on s’en tient au PHP moderne. C’est un langage bien plus agréable que sa vieille réputation ne le laisse croire, et il n’y a aucune raison de l’apprendre tel qu’il était en 2010.
Installation
Ouvrir un terminal
Un terminal, c’est une conversation avec votre ordinateur. Vous tapez une phrase, vous appuyez sur Entrée, et il vous répond à la ligne suivante. Pas de boutons, pas de menus : des mots qui vont et viennent. Tous les exemples de ce livre se passent là. Première chose à faire : trouver le vôtre.
macOS. Cmd+Espace, tapez « Terminal », Entrée. C’est Terminal.app, et il suffit largement.
Linux. Chaque environnement de bureau en fournit un, généralement appelé Terminal, Konsole ou GNOME Terminal. Cherchez dans le menu des applications, ou essayez Ctrl+Alt+T.
Windows. Touche Win, tapez « Terminal », et ouvrez Windows Terminal. C’est celui de Windows 11 par défaut ; sur Windows 10, il s’installe depuis le Microsoft Store. À l’intérieur, Invite de commandes ou PowerShell, au choix : les deux conviennent pour ce livre.
Avez-vous déjà PHP ?
Posez la question à votre ordinateur. Tapez ceci, puis Entrée :
$ php -v
PHP 8.3.6 (cli) (built: ...) (NTS)
Tip
Dans les exemples de terminal de ce livre, le
$au début d’une ligne représente l’invite que le terminal affiche en attendant que vous tapiez. Ne le tapez pas. Tapez seulement ce qui vient après.
Regardez la réponse. Trois cas possibles :
- Elle commence par
PHP 8. PHP est installé et assez récent. Filez directement à Hello, World!. - Elle commence par
PHP 7ou moins. Votre version est trop ancienne. Installez-en une nouvelle, juste en dessous. - Elle dit quelque chose comme
command not found. L’ordinateur ne connaît pas encore le motphp. Vous n’avez rien fait de travers : rien n’est installé, tout simplement. Lisez la suite.
Installer PHP
macOS. Les versions récentes de macOS ne livrent plus PHP. Installez-le avec Homebrew :
$ brew install php
Linux. Le gestionnaire de paquets de votre distribution l’a. Sur Ubuntu ou Debian :
$ sudo apt install php-cli
Les paquets des distributions ont parfois un an ou deux de retard. Si la version obtenue est trop vieille, le dépôt d’Ondřej Surý suit les sorties de près.
Windows. Téléchargez l’archive « Non Thread Safe » sur windows.php.net, décompressez-la dans un dossier simple comme C:\php, et ajoutez ce dossier à votre PATH pour que le terminal le trouve. Si vous préférez laisser un installeur s’en occuper, Laragon ou WampServer livrent PHP avec une installation guidée.
N’importe où, avec Docker. Si vous ne voulez rien installer sur votre machine et que Docker est déjà là :
$ docker run --rm -it php:8.3-cli bash
Vous obtenez un shell temporaire, PHP prêt à l’emploi, dans un petit environnement isolé. Tout ce que vous y tapez reste dans cette boîte, et la refermer laisse votre ordinateur exactement comme avant.
Vérifier que ça marche
Fermez votre terminal, ouvrez-en un nouveau, et relancez php -v. Cette fois, un numéro de version doit s’afficher.
Tip
Un terminal apprend la liste des programmes qu’il connaît au démarrage. Si vous venez d’installer PHP et qu’il répond encore
command not found, neuf fois sur dix il suffit d’en ouvrir un nouveau.
Bon à savoir : PHP a deux casquettes
En lisant sur PHP, vous croiserez des noms comme php-cli, php-fpm ou mod_php. C’est le même langage, avec des casquettes différentes.
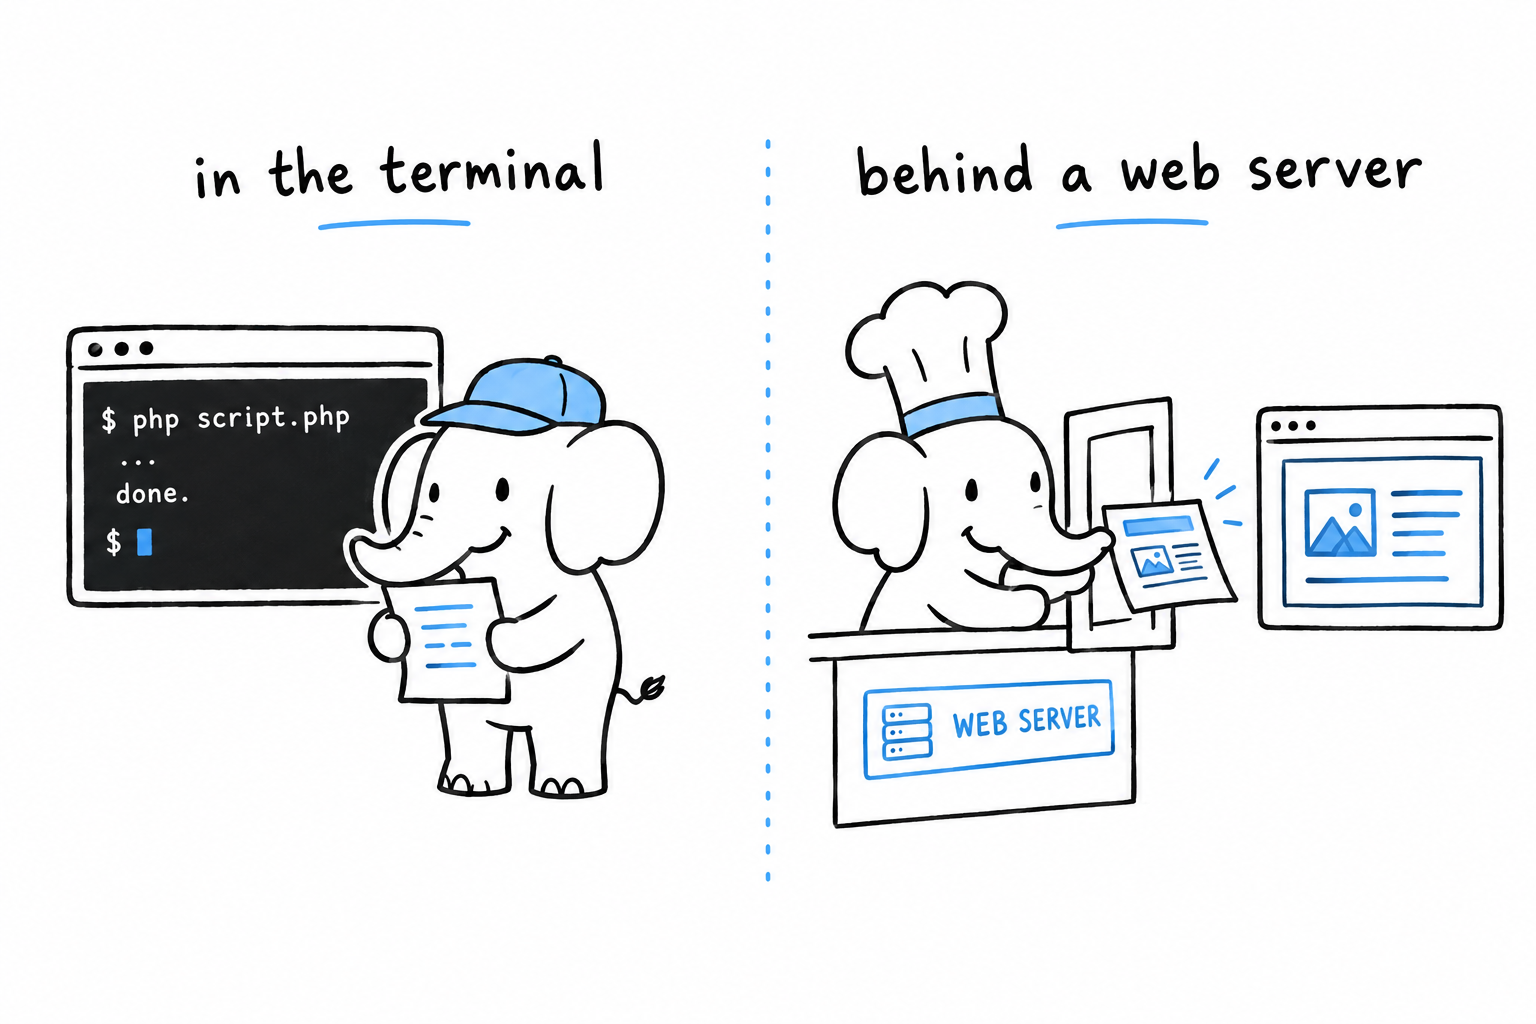
La première casquette, php-cli, c’est celle que vous venez d’installer. Elle exécute un script depuis votre terminal et affiche le résultat, comme le feraient Python ou Ruby.
La seconde, c’est la version pour serveur web. Elle se place derrière nginx ou Apache et répond aux demandes de pages.
Ce livre se contente de la première pendant longtemps. Quand le web arrivera, vous connaîtrez déjà le langage. Seule la casquette changera.
Hello, World!
Faisons parler PHP.
Ouvrez votre éditeur, créez un fichier hello.php où vous voulez, et tapez-y ces lignes :
<?php

echo "Hello, world!\n";
Enregistrez. Puis, dans le terminal, placez-vous dans le dossier du fichier et lancez :
$ php hello.php
Hello, world!
Voilà un programme PHP complet. Il est court, mais chaque caractère y a un rôle. Démontons-le.
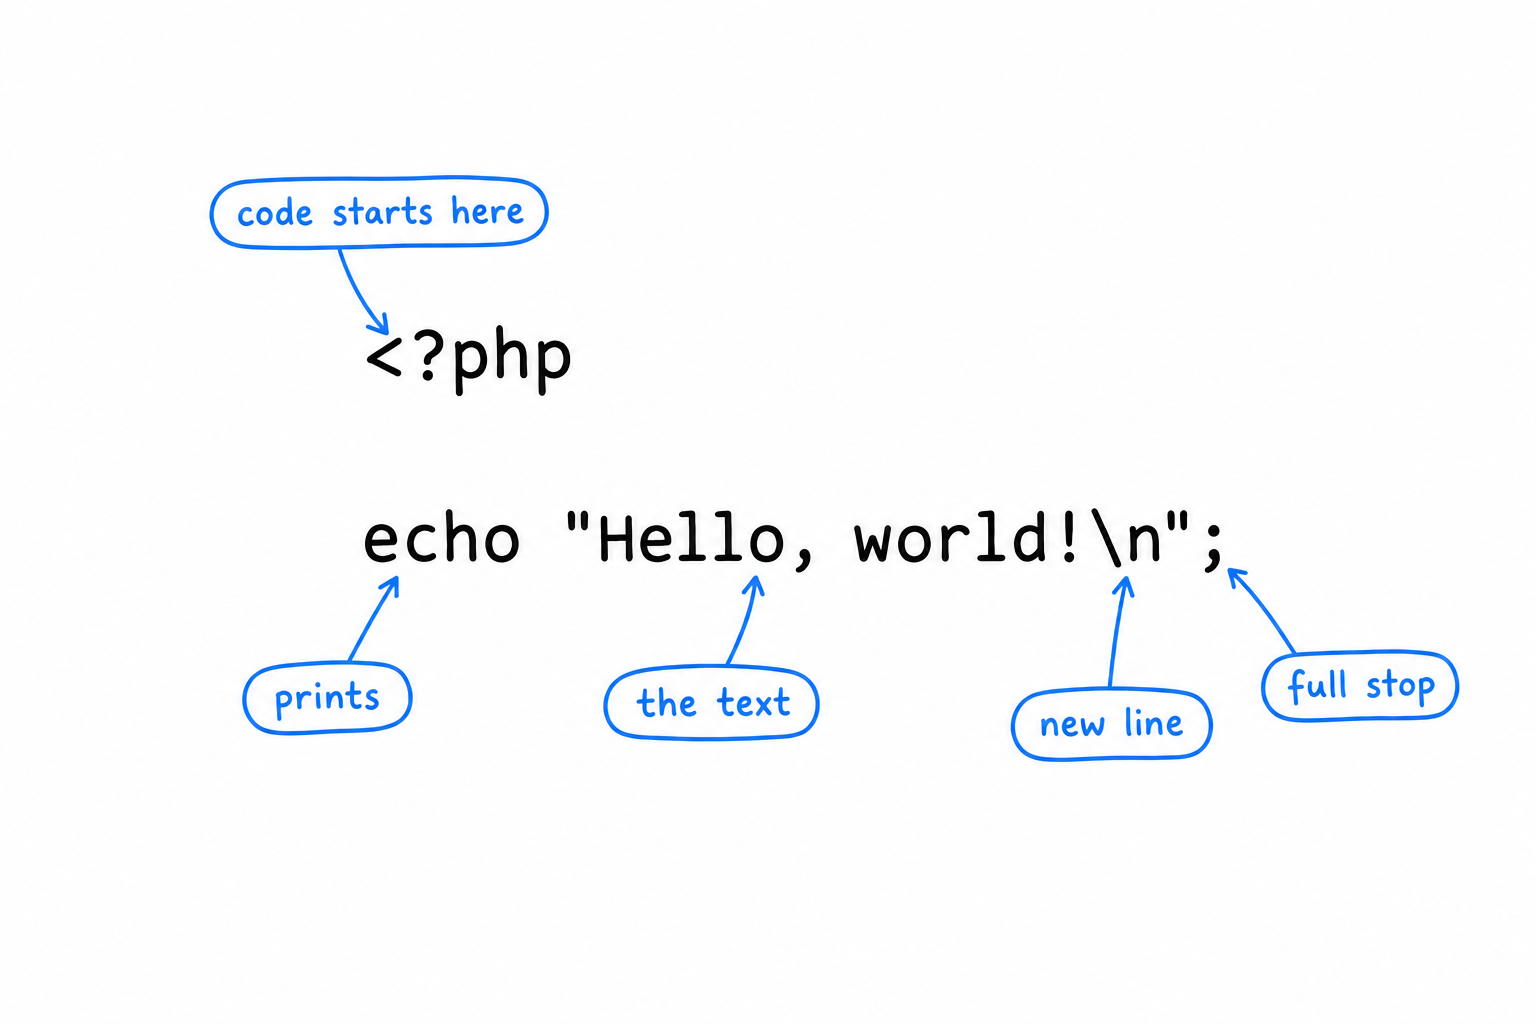
<?php, la balise d’ouverture
PHP est né pour glisser de petits morceaux de logique dans des pages web. Cette origine a laissé une trace définitive : par défaut, un fichier PHP est du texte ordinaire, et seul ce qui se trouve entre <?php et ?> est considéré comme du code. Tout le reste est recopié tel quel en sortie.
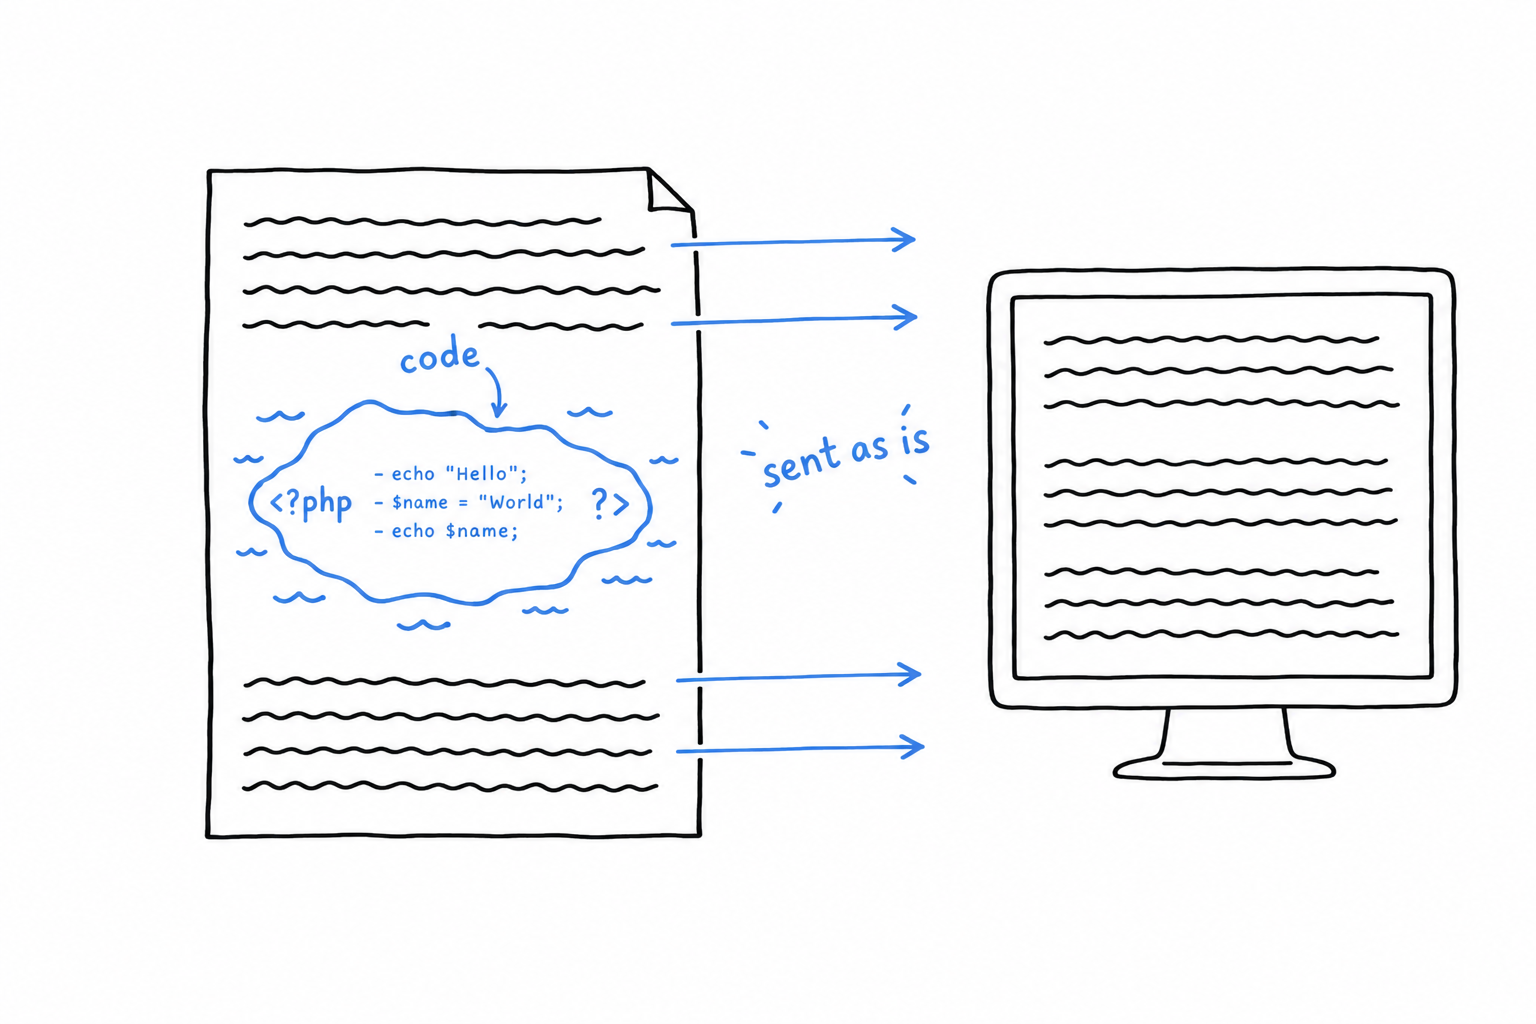
Dans un fichier qui ne contient que du code, comme le nôtre, on écrit la balise d’ouverture une fois, tout en haut, et rien d’autre. Deux habitudes en découlent.
- Rien avant
<?php. Pas même une ligne vide : elle partirait en sortie avant que le programme ait commencé. - Pas de balise fermante en fin de fichier. Omettre
?>a l’air d’un oubli, mais c’est volontaire. Un espace ou un saut de ligne égaré après la balise fermante part lui aussi en sortie, et ce genre de caractère invisible produit des bugs exaspérants. Une balise jamais fermée ne laisse rien fuir.
echo, la voix du programme
echo affiche ce qui le suit. C’est ainsi qu’un programme PHP parle. Vous vous en servirez tout le temps, et vous croiserez deux cousins en route : print, qui fait presque la même chose, et printf, pour quand le texte a besoin d’être mis en forme.
echo n’est pas une fonction, il n’a donc pas besoin de parenthèses. echo("Hello") marche aussi, PHP n’est pas regardant, mais la forme nue est celle que vous verrez partout.
"Hello, world!\n", le texte
Un texte entre guillemets s’appelle une chaîne de caractères. Celle-ci se termine par \n, et ce ne sont pas deux caractères affichés à l’écran : c’est l’ordre « passe à la ligne », comme si on appuyait sur Entrée. Sans lui, la prochaine chose affichée viendrait se coller juste après le point d’exclamation.
PHP connaît deux sortes de guillemets, et la différence compte. Les guillemets doubles demandent à PHP de regarder dans le texte et d’interpréter les séquences spéciales comme \n. Les guillemets simples lui demandent de ne toucher à rien : 'Hello, world!\n' affiche une barre oblique inverse suivie d’un n.
Les guillemets doubles regardent dans le texte. Les guillemets simples n’y touchent pas. Aucun n’est meilleur, vous choisirez entre les deux en permanence.
;, le point final
Chaque instruction PHP se termine par un point-virgule, comme une phrase se termine par un point. Oubliez-en un, et PHP protestera, mais pas là où vous l’attendez. Essayez : retirez le point-virgule et ajoutez une deuxième ligne.
<?php

echo "Hello, world!\n"
echo "Nice to meet you.\n";
$ php hello.php
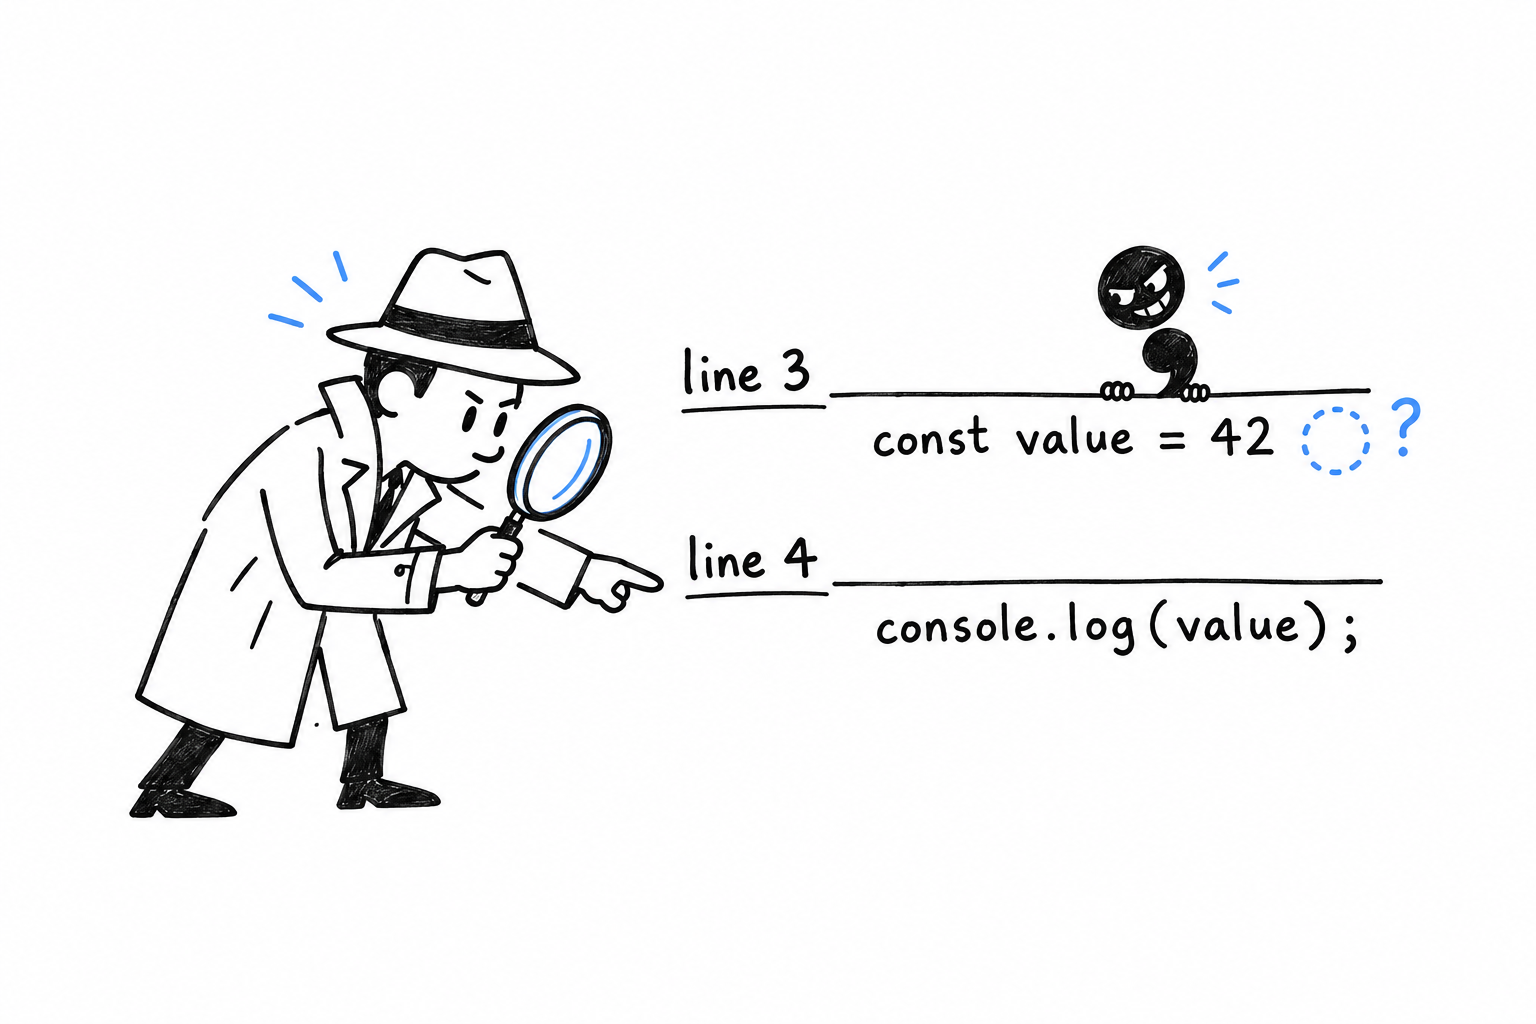
PHP Parse error:  syntax error, unexpected token "echo", expecting "," or ";" in hello.php on line 4
PHP accuse la ligne 4, qui n’a rien fait. Le point-virgule manque à la ligne 3 : PHP ne s’en est aperçu qu’en arrivant au mot suivant, quand plus rien n’avait de sens.
Tip
Quand une erreur incompréhensible désigne une ligne qui a l’air correcte, le vrai coupable est presque toujours juste au-dessus.
Lancer, relancer
php hello.php confie votre fichier à PHP, qui le lit de haut en bas et fait ce qu’il dit. Pas de compilation, pas de build, rien qui reste derrière.
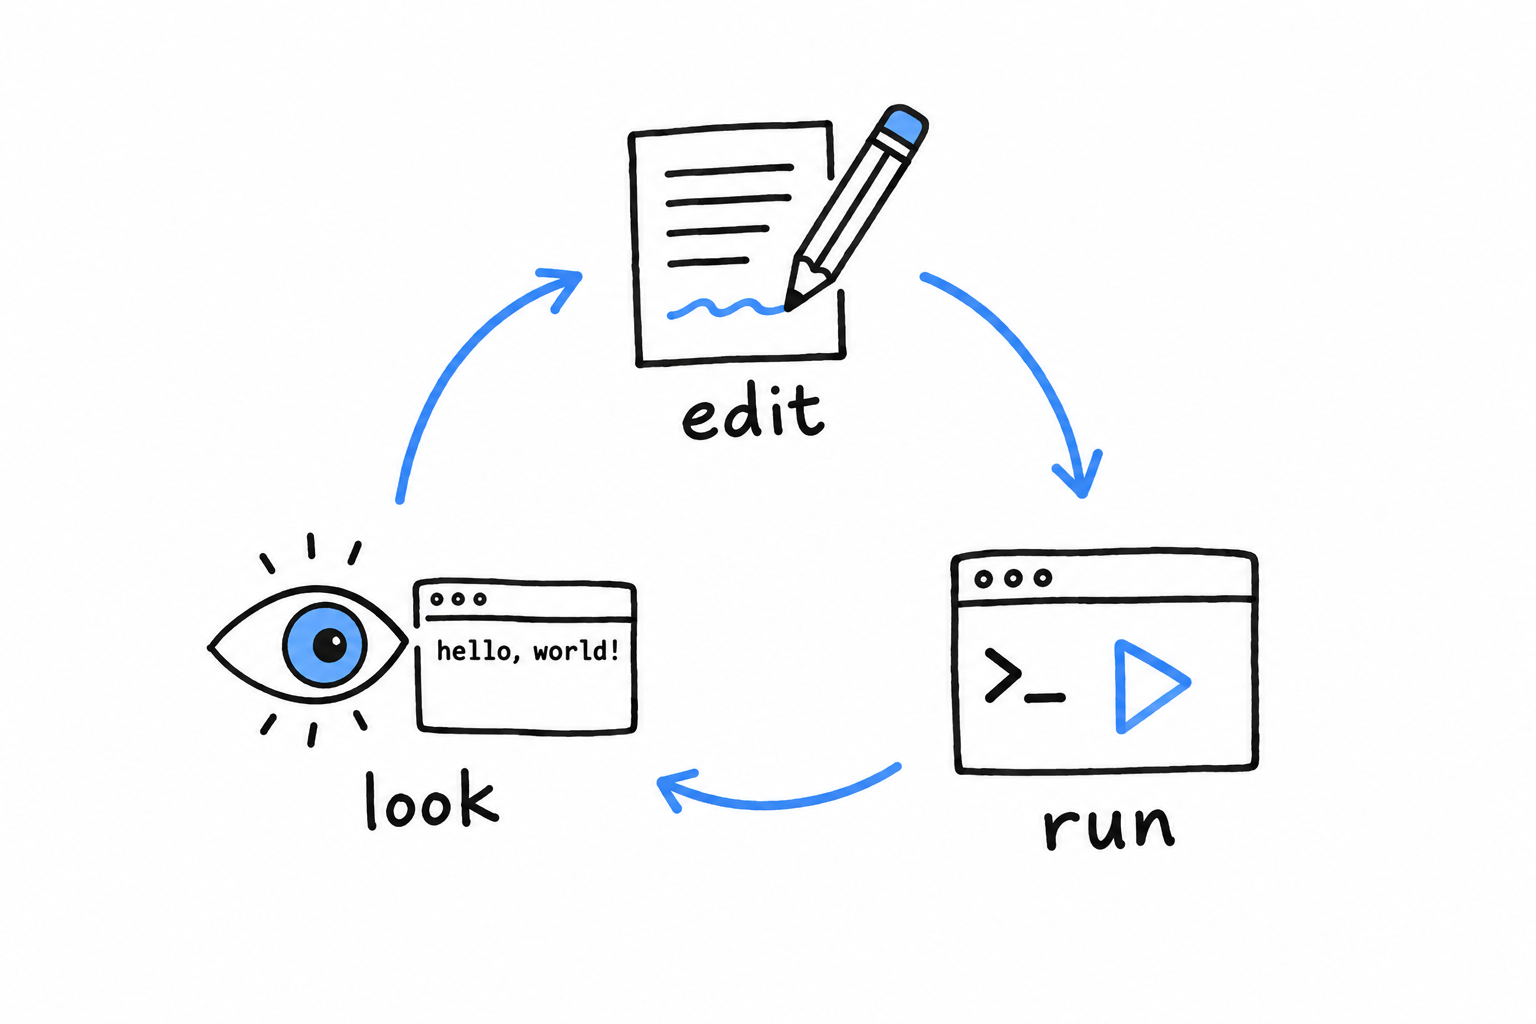
Modifier le fichier. Le lancer. Regarder le résultat. Modifier, lancer, regarder.
Cette boucle serrée est la plus grande différence de sensation entre PHP et un langage compilé, et ce livre en profite sans arrêt. Quand vous vous demandez ce que fait un bout de code, le plus rapide est de le lancer.
Pour un essai d’une ligne, PHP a aussi un mode interactif. Tapez php -a : vous obtenez une invite où chaque ligne s’exécute dès que vous appuyez sur Entrée.
$ php -a
Interactive shell

php > echo "Hello, world!\n";
Hello, world!
php > exit
Pratique pour vérifier un détail. Ce n’est pas là qu’on construit de vrais programmes, mais ça ne l’est dans aucun langage.
Vous venez d’écrire, de lancer, de casser et de réparer un programme PHP. Tout le rythme du métier tient là, en miniature. Le chapitre 2 s’en sert pour construire un jeu.
Programmer un jeu de devinette
Construisons un jeu.
Les règles tiennent en une phrase. L’ordinateur choisit en secret un nombre entre 1 et 100. Vous proposez un nombre. Il répond « trop petit » ou « trop grand », et vous recommencez jusqu’à tomber juste.
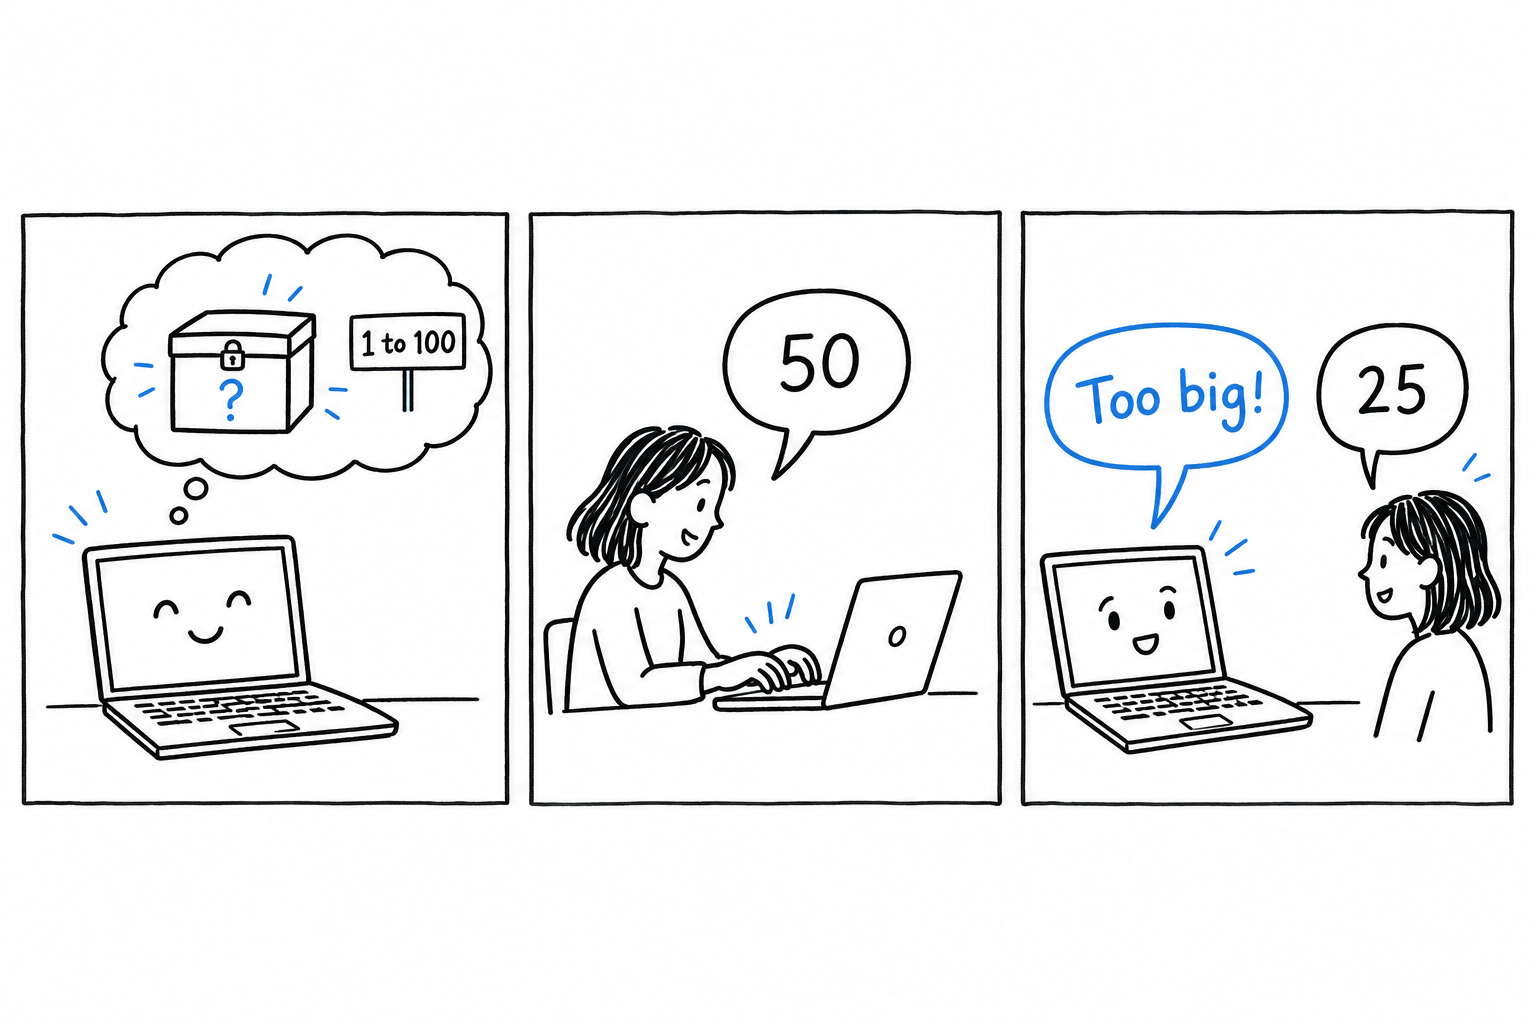
Si petit soit-il, ce jeu contient presque tout ce dont les vrais programmes sont faits : une entrée, une sortie, une décision, une boucle, et un peu de nettoyage de ce que l’utilisateur a tapé. C’est pour cela qu’il passe avant la théorie.
Vous allez croiser des mots que vous ne comprendrez pas encore tout à fait. C’est normal, c’est même le but. Vous voyez d’abord PHP en action, et le chapitre 3 reviendra expliquer chaque pièce posément.
Le jeu en un dessin
Avant de taper quoi que ce soit, voici le programme entier en un dessin. Chaque boîte deviendra quelques lignes de PHP.
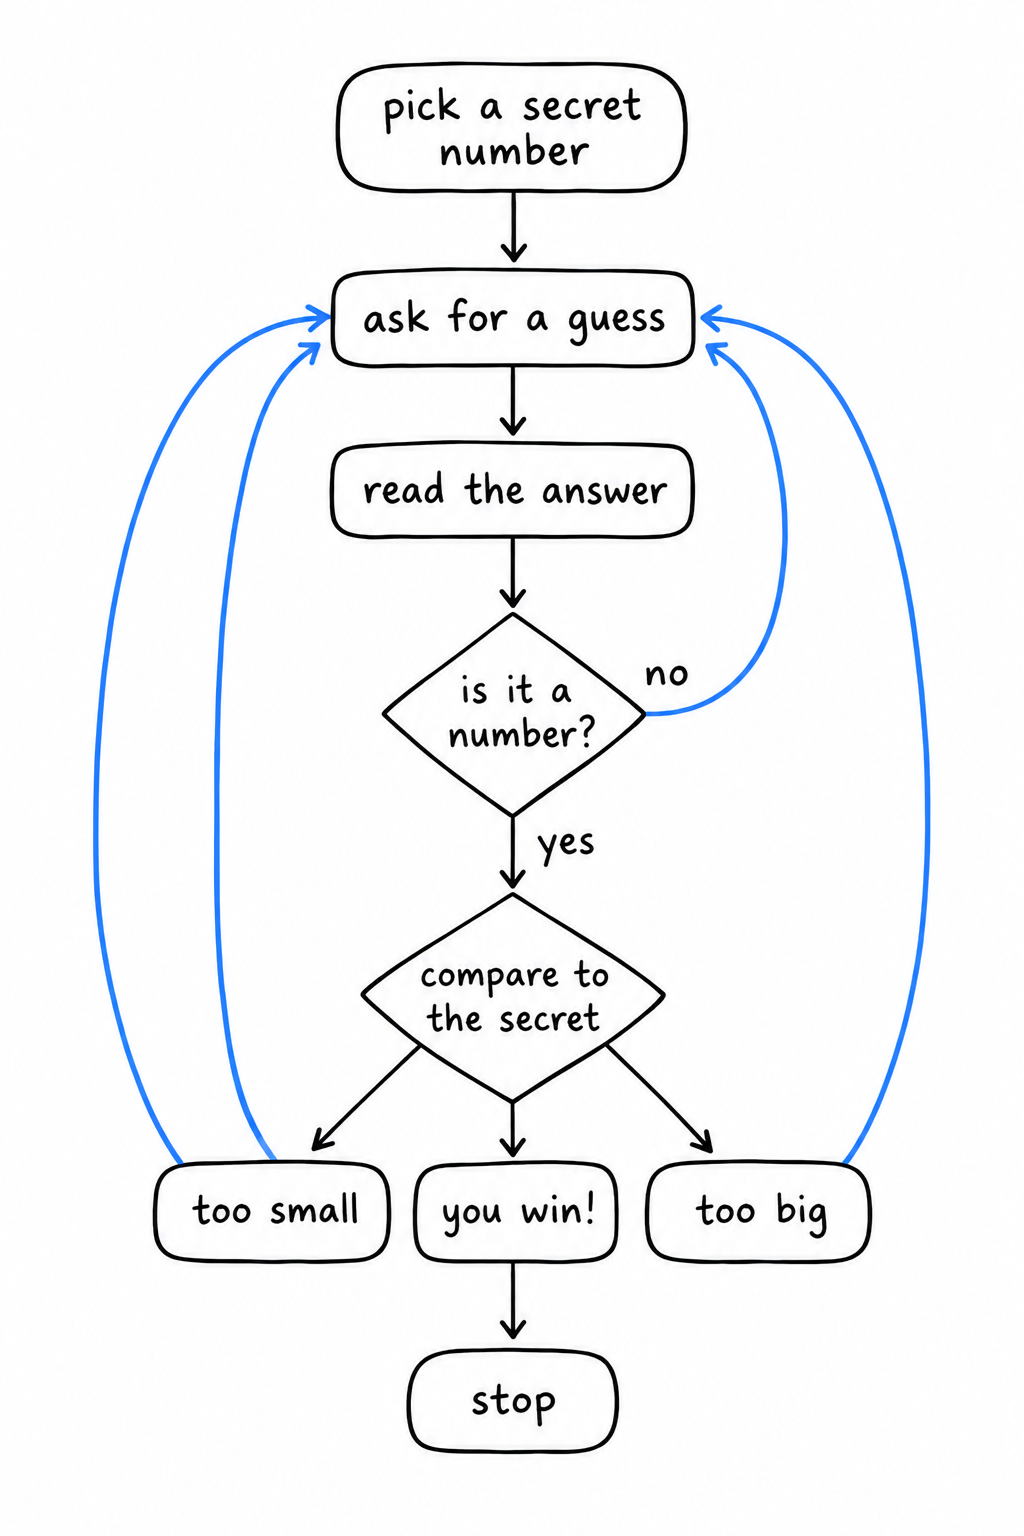
Lisez-le une fois, de haut en bas. Choisir un secret. Demander. Lire la réponse. Est-ce bien un nombre ? Sinon, redemander. Comparer au secret. Trop petit, trop grand, ou trouvé. Trouvé ? On s’arrête.
Choisir un secret. Demander. Lire. Vérifier. Comparer. Répondre. Recommencer. C’est tout le plan.
Construisons-le maintenant, une boîte à la fois.
Étape 1 : demander au joueur
Créez un fichier guessing_game.php :
<?php

echo "Guess the number!\n";
echo "Please input your guess.\n";

$guess = trim(fgets(STDIN));

echo "You guessed: {$guess}\n";
Lancez-le, tapez un nombre, Entrée :
$ php guessing_game.php
Guess the number!
Please input your guess.
42
You guessed: 42
Les deux premières lignes, vous les connaissez : echo affiche du texte. La ligne intéressante est celle du milieu, qui fait trois choses d’un coup. Lisons-la de l’intérieur vers l’extérieur.
fgets(STDIN) attend que le joueur tape une ligne et appuie sur Entrée, puis remet cette ligne au programme. STDIN est le nom du canal par lequel arrive ce que vous tapez au clavier, le même que lisent tous les outils en ligne de commande.
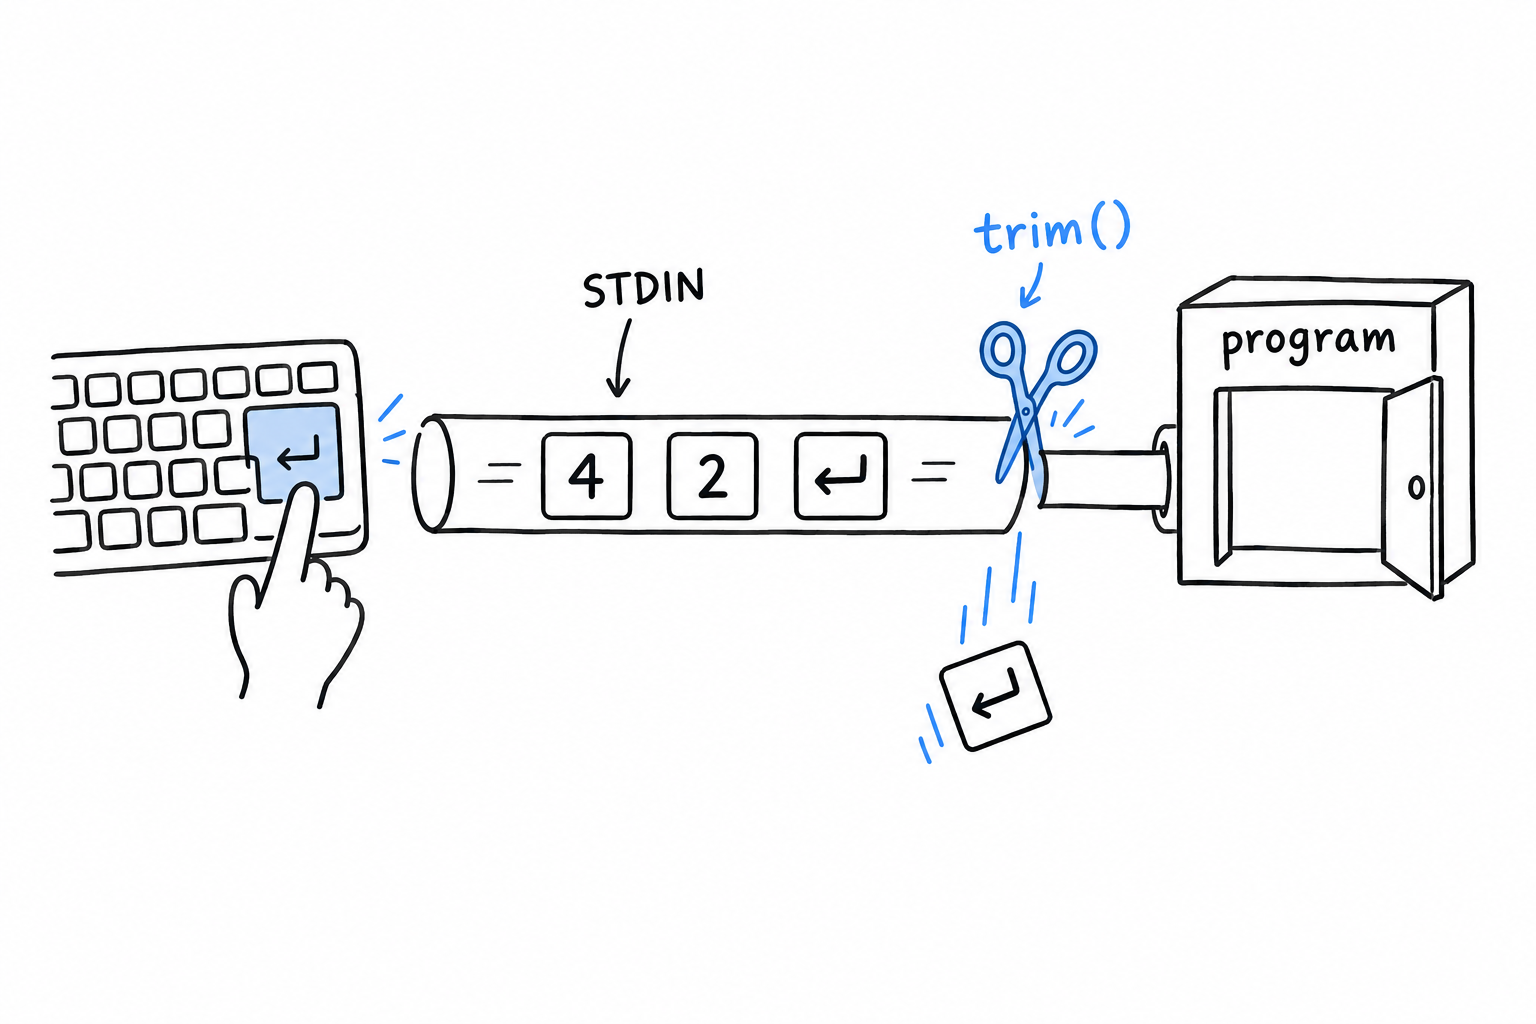
Il y a un piège : la ligne reçue contient aussi la touche Entrée, sous la forme d’un caractère de saut de ligne invisible, tout au bout. On n’en veut presque jamais, alors trim() le coupe. trim() retire les espaces et les sauts de ligne aux deux bouts d’un texte, et l’enrouler autour de fgets(STDIN) est un duo si courant que vos doigts le taperont bientôt tout seuls.
Enfin, $guess = ... range le résultat. $guess est une variable : une boîte étiquetée dans laquelle le programme garde une valeur pour plus tard. En PHP, tous les noms de variables commencent par $. Rien à déclarer, aucun type à annoncer : vous mettez quelque chose dans la boîte, et la boîte existe.
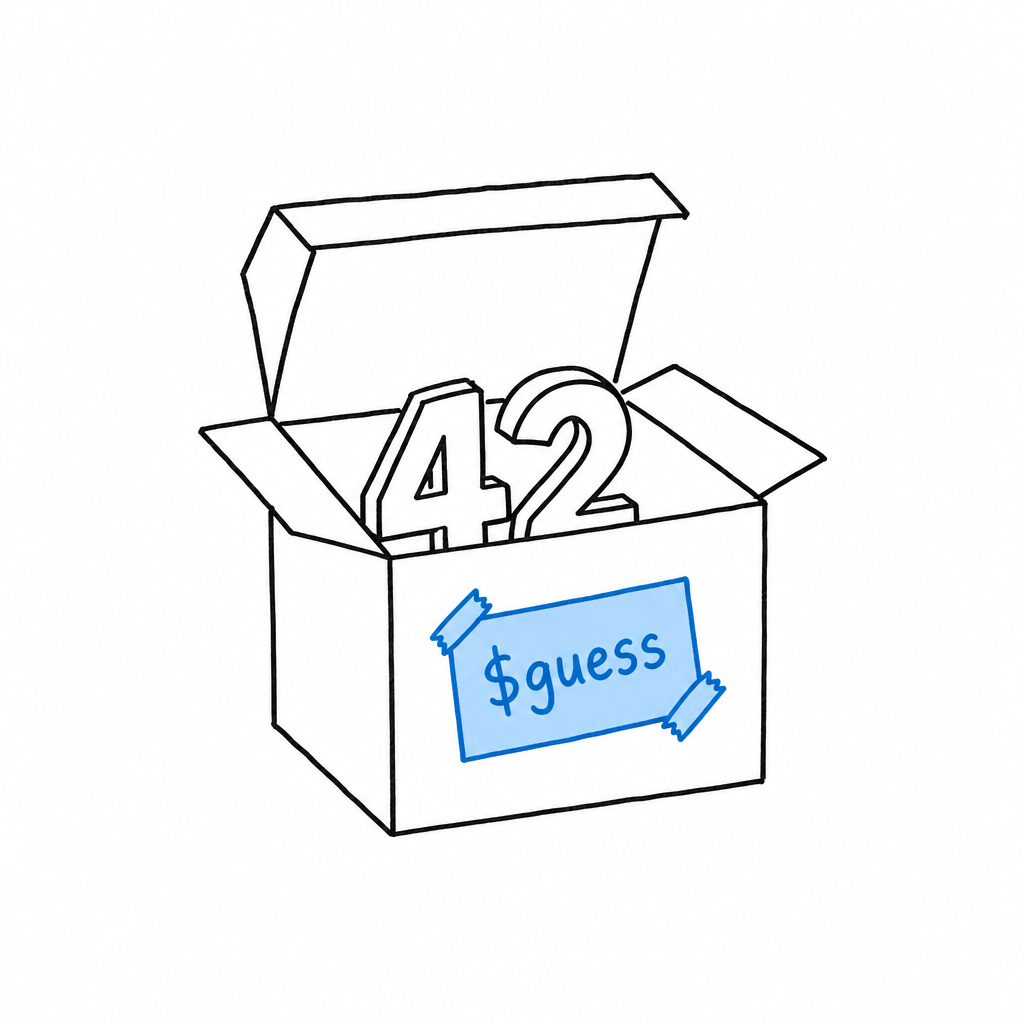
Une variable, c’est une boîte avec une étiquette. Mettez-y quelque chose, et la boîte existe.
La dernière ligne montre au joueur ce que contient la boîte. Entre guillemets doubles, {$guess} est remplacé par la valeur de la variable. Les accolades sont facultatives pour un nom simple comme celui-là, mais elles montrent sans ambiguïté où le nom s’arrête, et cette clarté rendra service plus tard, avec des expressions plus longues.
Étape 2 : choisir le nombre secret
L’ordinateur a besoin d’un nombre à cacher. PHP a une fonction faite pour ça :
<?php

$secretNumber = random_int(1, 100);

echo "Guess the number!\n";
echo "The secret number is between 1 and 100.\n";
echo "Please input your guess.\n";

$guess = trim(fgets(STDIN));

echo "You guessed: {$guess}\n";
random_int(1, 100) renvoie un nombre entier tiré au hasard entre 1 et 100, bornes comprises, et nous le rangeons dans une deuxième boîte, $secretNumber.
Tip
random_int()est un générateur aléatoire de haute qualité, bien plus qu’il n’en faut pour un jeu. Mais c’est aussi celui qu’il faut choisir chaque fois que vous avez besoin de hasard en PHP, autant prendre la bonne habitude tout de suite.
Lancez le programme plusieurs fois. Le secret change à chaque fois, mais rien ne vous permet encore de le voir : personne ne le compare à votre proposition. Réglons ça.
Étape 3 : comparer
<?php

$secretNumber = random_int(1, 100);

echo "Guess the number!\n";
echo "Please input your guess.\n";

$guess = (int) trim(fgets(STDIN));

if ($guess < $secretNumber) {
    echo "Too small!\n";
} elseif ($guess > $secretNumber) {
    echo "Too big!\n";
} else {
    echo "You win!\n";
}
Le bloc if, c’est la décision du dessin. PHP teste la première condition : la proposition est-elle plus petite que le secret ? Si oui, il affiche « Too small! » et ignore le reste. Sinon, il teste la deuxième. Si aucune des deux n’est vraie, la proposition n’est ni plus petite ni plus grande, donc elle est égale, et c’est la branche else qui s’exécute. Un seul des trois messages s’affiche, jamais deux.
Il y a un second changement, petit et facile à rater : (int) devant trim(fgets(STDIN)).
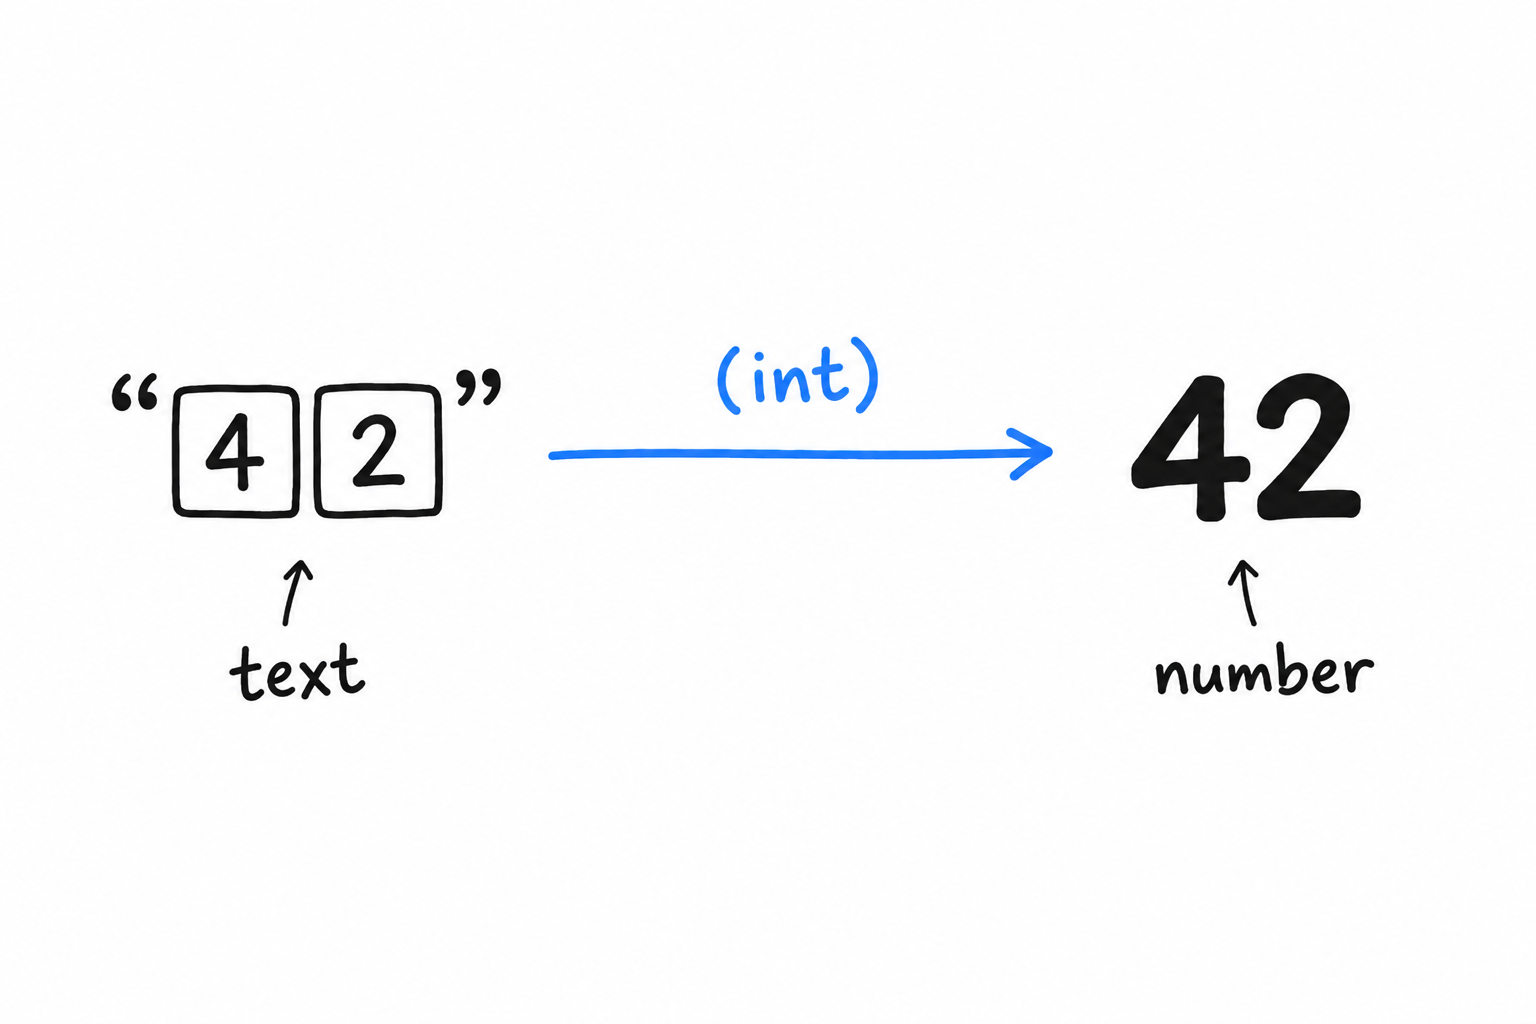
Tout ce qui vient du clavier arrive sous forme de texte. Quand le joueur tape 42, le programme reçoit les deux caractères « 4 » et « 2 », pas le nombre quarante-deux. PHP accepte souvent de comparer du texte à des nombres, et il devine généralement juste, mais « généralement » n’est pas un mot qu’on veut voir dans une comparaison. (int) convertit le texte en vrai entier, explicitement, de sorte que les deux côtés du < sont des nombres et qu’il ne reste rien à deviner.
« 42 », c’est du texte. 42, c’est un nombre.
(int)transforme le premier en second, et le dit clairement.
Le chapitre 3 reviendra sur cette idée, qu’on appelle le jonglage de types, et sur les bonnes raisons d’être explicite.
Étape 4 : recommencer
Pour l’instant, la partie s’arrête après une seule proposition, gagnée ou perdue. Sur le dessin, une flèche remonte. En PHP, cette flèche s’appelle une boucle :
<?php

$secretNumber = random_int(1, 100);

echo "Guess the number!\n";

while (true) {
    echo "Please input your guess.\n";
    $guess = (int) trim(fgets(STDIN));

    if ($guess < $secretNumber) {
        echo "Too small!\n";
    } elseif ($guess > $secretNumber) {
        echo "Too big!\n";
    } else {
        echo "You win!\n";
        break;
    }
}
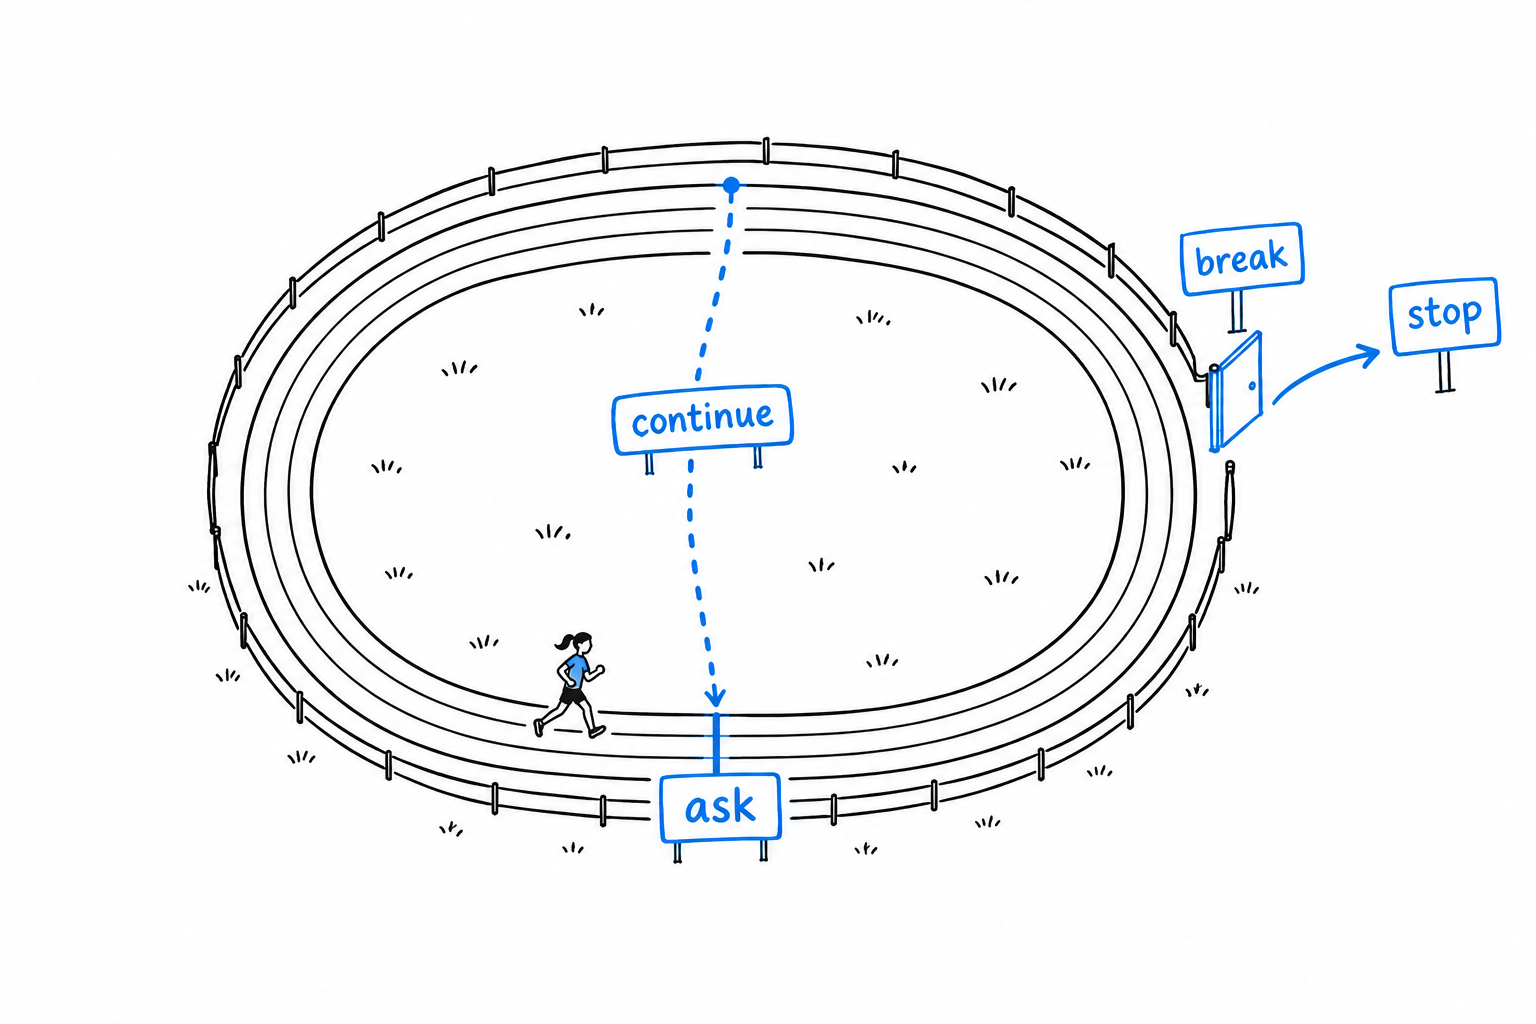
while (true) signifie « répète ce bloc indéfiniment ». Ça paraît dangereux, et ça le serait sans porte de sortie. La sortie, c’est break : dès que PHP l’exécute, il quitte la boucle et reprend après l’accolade fermante. Nous plaçons break uniquement dans la branche gagnante, donc la boucle redemande jusqu’à ce que le joueur trouve, puis s’arrête.
Étape 5 : encaisser n’importe quoi
Il reste une aspérité. Tapez banana à la place d’un nombre, et (int) "banana" devient 0 sans un mot. Pas d’erreur, pas d’avertissement, juste une mauvaise proposition qui compte comme les autres. Vérifions l’entrée avant de lui faire confiance :
<?php

$secretNumber = random_int(1, 100);

echo "Guess the number!\n";

while (true) {
    echo "Please input your guess.\n";
    $input = trim(fgets(STDIN));

    if (!is_numeric($input)) {
        echo "That doesn't look like a number, try again.\n";
        continue;
    }

    $guess = (int) $input;

    if ($guess < $secretNumber) {
        echo "Too small!\n";
    } elseif ($guess > $secretNumber) {
        echo "Too big!\n";
    } else {
        echo "You win!\n";
        break;
    }
}
is_numeric() répond par oui ou par non à une question : ce texte ressemble-t-il à un nombre ? Le ! devant inverse la réponse, si bien que le if se lit « si l’entrée n’est pas un nombre ». Dans ce cas, on affiche un message aimable et on passe par continue.
continue, c’est l’autre porte du dessin. Là où break sort de la boucle, continue saute directement au début pour un nouveau tour, en ignorant tout ce qui se trouve en dessous. Une faute de frappe ne coûte rien au joueur : le jeu redemande, c’est tout.
breaksort de la boucle.continuelance le tour suivant.
À vous de jouer
Lancez le jeu et gagnez-le. Puis revenez au dessin : chaque boîte est maintenant dans votre fichier. Choisir le secret, demander, lire, vérifier, comparer, répondre, recommencer.
Trente lignes, et le programme sait déjà :
- lire ce qu’on tape au clavier, avec
fgets()ettrim(), - prendre des décisions, avec
if,elseifetelse, - se répéter, avec
while,breaketcontinue, - transformer du texte en nombre, avec
(int), - refuser poliment n’importe quoi, avec
is_numeric().
Gardez ce fichier. Vous retrouverez sa silhouette dans tous les programmes que vous écrirez, et au chapitre 14, vous construirez des outils en ligne de commande nettement plus sérieux qu’un jeu de devinette.
Les notions de base de la programmation
Rouvrez guessing_game.php. Trente lignes, et vous les avez toutes tapées avant que quiconque vous dise ce qu’est une variable, un type ou une boucle. Le jeu a fonctionné sans les noms. Vous avez besoin des noms maintenant, parce que c’est avec eux que vous penserez les programmes que vous n’avez pas encore écrits.
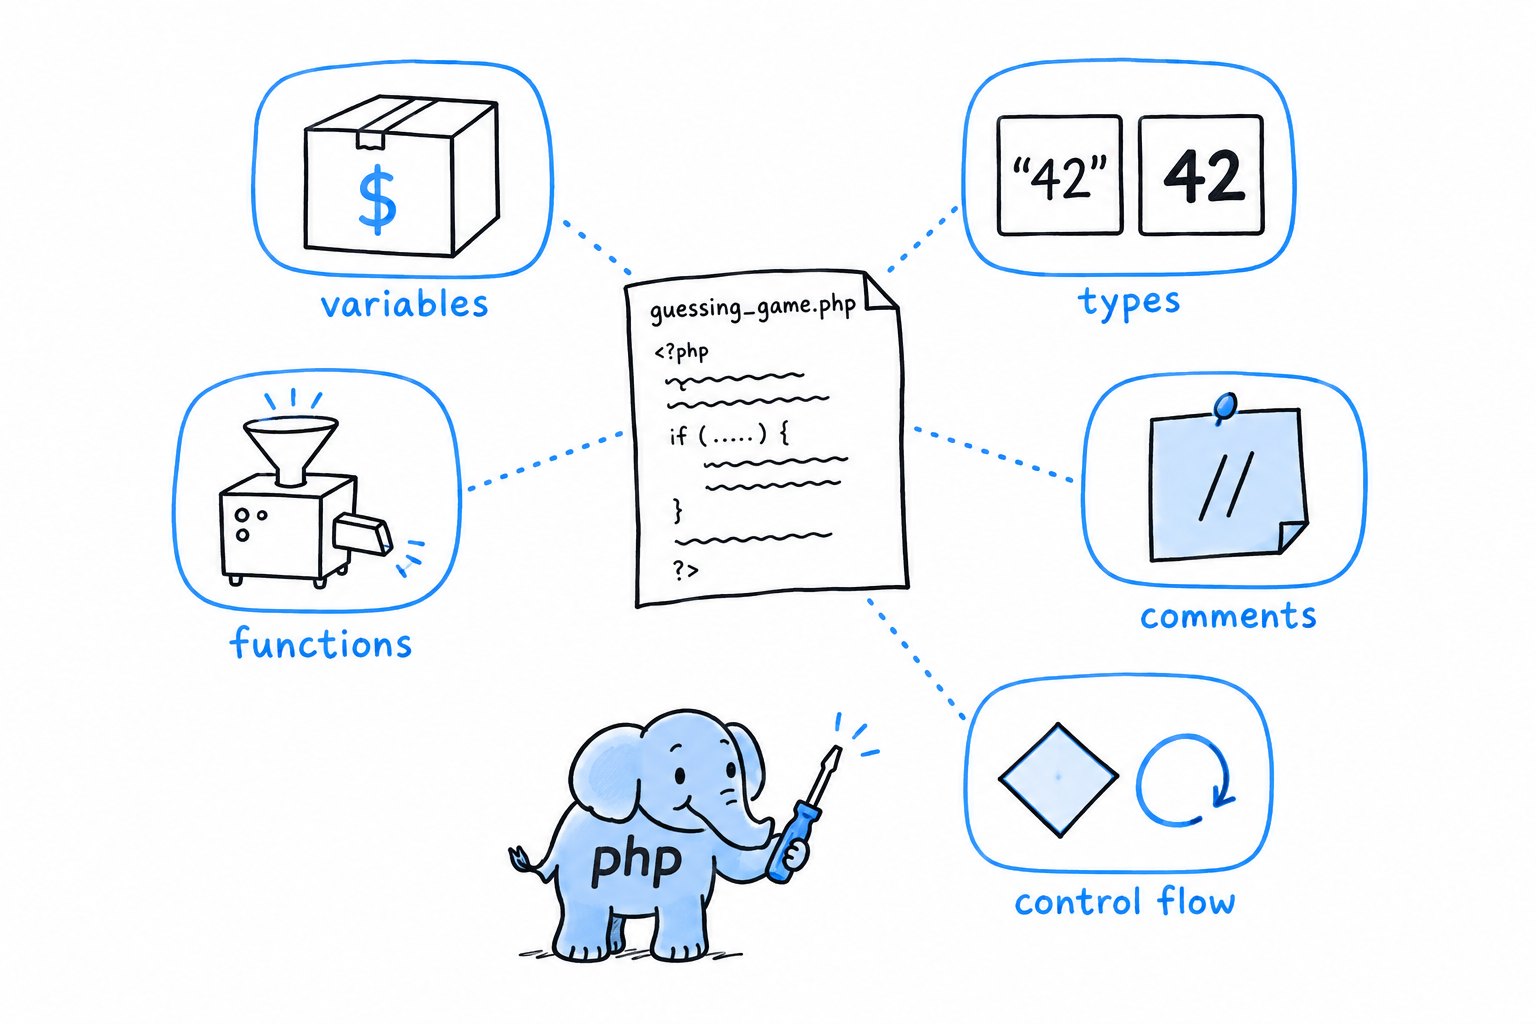
Tous les langages de programmation sont bâtis sur la même poignée d’idées, et le jeu les contient toutes. Un endroit où garder une valeur, comme $guess : une variable. La différence entre le texte « 42 » et le nombre 42 : les types. Un morceau de travail qui porte un nom, comme trim() : une fonction. Une note laissée aux humains qui lisent le code : un commentaire. Les parties qui décident et qui répètent, if et while : les structures de contrôle. Cinq idées, une section chacune, toutes expliquées à partir de code que vous avez déjà exécuté.
Si vous avez déjà programmé, rien ici n’est nouveau sur le fond, et vous pouvez lire vite. Guettez plutôt les endroits où PHP fait la chose familière à sa manière : des variables qui apparaissent dès qu’on leur affecte une valeur, un système de types plus strict que sa réputation dès qu’on le lui demande, et une expression match qui vous manquera ailleurs.
Si c’est votre premier langage, ralentissez, gardez le jeu ouvert dans votre éditeur, et exécutez chaque exemple au fur et à mesure. Tout le reste du livre, ce sont ces cinq idées, assemblées en formes plus grandes.
Variables, constantes et mutabilité
Dans le jeu de devinette, $guess contenait un nombre différent à chaque tour de boucle, tandis que $secretNumber gardait le même du début à la fin. Même syntaxe, deux rôles différents. PHP vous donne un moyen de dire lequel des deux vous voulez.
Les variables
Une variable PHP commence par un signe dollar, et c’est à peu près toute la syntaxe à connaître :
<?php

$greeting = "Hello";
echo $greeting;

$greeting = "Goodbye";
echo $greeting;
Pas de let, pas d’étape de déclaration à oublier. (Il existe bien un mot-clé var, un fossile de PHP 4 qui n’a de sens qu’à l’intérieur d’une classe. Vous ne l’utiliserez pas.) Vous affectez, et à partir de cette ligne la variable existe, exactement comme $guess dans le jeu : aucune annonce, juste une boîte et une valeur dedans.
La seconde affectation change ce que contient la boîte, sans permission particulière. Toute variable PHP est mutable par défaut. Réaffecter, c’est affecter, une fois de plus. Si vous venez d’un langage où la mutabilité se demande explicitement, c’est le défaut inverse : pour PHP, changer une valeur est le cas normal, et l’immutabilité est quelque chose que l’on construit exprès, en général avec des objets.
Essayez : dans le jeu, ajoutez $secretNumber = 42; juste sous la ligne du random_int(). Rien ne proteste, et vous voilà propriétaire d’un jeu que vous gagnez du premier coup.
Le nommage
Les noms de variables distinguent les majuscules des minuscules : $guess et $Guess sont deux boîtes différentes. Un nom commence par une lettre ou un tiret bas, et par convention il s’écrit en camelCase :
<?php

$userName = "damien";
$total_price = 42.50; // valid, but not idiomatic PHP
Les deux lignes fonctionnent. Seule la première ressemble à ce que vous verrez dans le PHP moderne et dans la norme de codage que suivent la plupart des projets, PSR-12. L’écosystème PHP tient plus à la cohérence à l’intérieur d’une base de code qu’à la supériorité d’un style sur un autre, mais le camelCase pour les variables est ce qui se rapproche le plus d’une convention universelle en PHP.
Les constantes
$secretNumber n’a jamais changé pendant une partie, mais rien ne l’en empêchait : une affectation égarée dans la boucle, et le jeu se cassait sans un mot. Pour une valeur qui ne doit pas changer pendant l’exécution (un réglage de configuration, une constante mathématique, l’URL de base d’une API), PHP a mieux qu’une variable que vous promettez de ne pas toucher :
<?php

define('MAX_RETRIES', 3);
echo MAX_RETRIES;

const APP_NAME = 'GuessingGame';
echo APP_NAME;
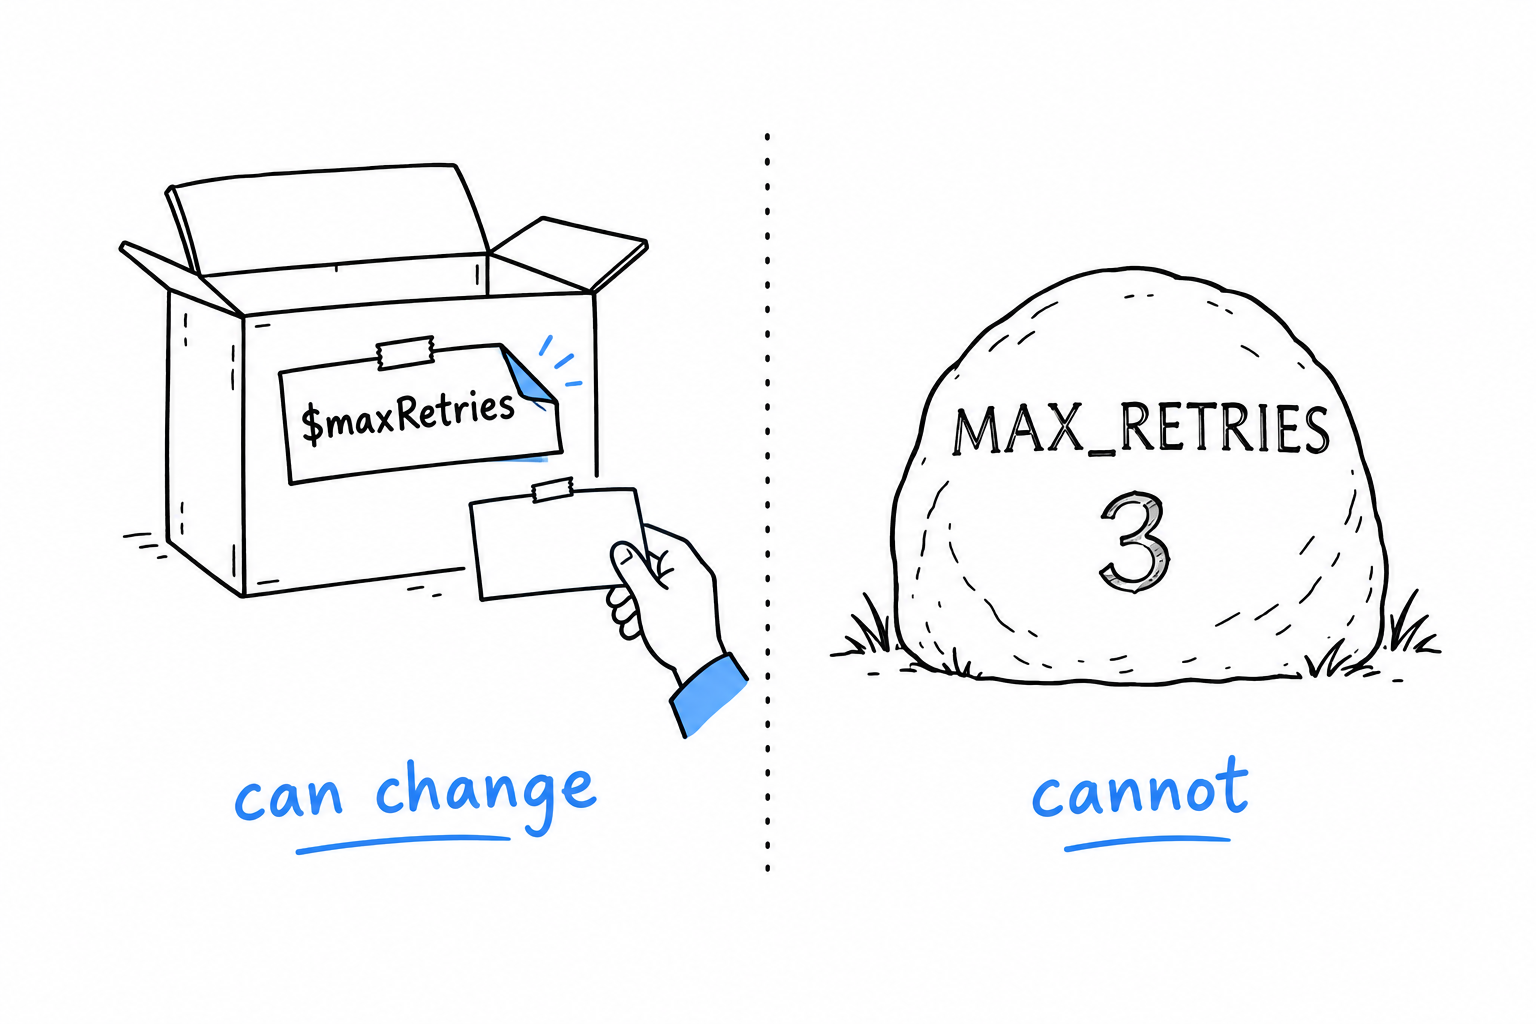
Une constante n’a pas de $, et c’est voulu. N’importe où dans un fichier, vous voyez d’un coup d’œil que MAX_RETRIES ne changera pas dans votre dos, alors que $maxRetries est à la merci de quiconque passe après vous.
Deux façons d’en écrire une, toutes deux courantes. define() est un appel de fonction, évalué pendant l’exécution, et fonctionne partout. const est une construction du langage, résolue avant l’exécution, et (c’est là que les gens trébuchent) elle n’est autorisée qu’au niveau supérieur d’un fichier ou dans une classe, jamais dans un bloc if ni dans le corps d’une fonction. Hors d’une classe, préférez const : c’est légèrement plus rapide et ça se lit comme ce que c’est.
Une variable est une boîte dont on peut décoller l’étiquette. Une constante est un nom gravé dans la pierre.
La mutabilité, et ce que PHP en fait vraiment
Si vous avez lu des choses sur des langages qui font grand cas de la propriété ou de l’emprunt des données, vous vous attendez peut-être à une histoire plus compliquée que « affectez, c’est tout ». À ce niveau, ce n’est pas le cas. PHP a bien sa propre idée, beaucoup plus douce, de qui possède une donnée, et elle apparaît dès que vous passez des tableaux et des objets à des fonctions au lieu d’afficher des chaînes. C’est le sujet du chapitre 4.
Les types de données
Le clavier a donné au jeu le texte « 42 », et le jeu avait besoin du nombre 42. Cet écart, et le (int) que vous avez écrit pour le combler, voilà le sujet de cette section. PHP vous laisse écrire un programme entier sans nommer un seul type. Il peut aussi, si vous le lui demandez, vous tenir à vos types aussi strictement qu’un langage compilé. Les deux sont vrais en même temps.
Les types scalaires
Quatre types contiennent une seule valeur chacun :
<?php

$age = 41;           // int
$price = 19.99;      // float
$name = "Damien";    // string
$isReady = true;     // bool
Un entier pour compter, un flottant pour mesurer, une chaîne de caractères pour le texte, un booléen pour oui ou non. Le jeu en a utilisé trois sans le dire : $secretNumber était un int, la saisie brute une string, et is_numeric() répondait par un bool.
Vous pouvez demander à PHP ce que contient une variable avec gettype(), ou, bien plus utile pour déboguer, avec var_dump() :
<?php

var_dump($age);
// int(41)

var_dump($price);
// float(19.99)
var_dump() affiche le type avec la valeur, ce qu’echo ne fait jamais. Il deviendra l’un de vos outils les plus utilisés. Essayez : dans le jeu, ajoutez var_dump($input); juste après la ligne qui lit le clavier, tapez 42, et lisez la réponse. string(2) "42" : deux caractères de texte, pas un nombre.
Les types composés
Deux types contiennent des collections d’autres choses.
Les tableaux sont la structure à tout faire de PHP : liste, dictionnaire, pile, file, un seul type sous-jacent qui change de chapeau :
<?php

$fruits = ["apple", "banana", "cherry"];   // indexed
$prices = ["apple" => 0.5, "banana" => 0.3]; // associative
Tout le chapitre 8 leur est consacré, et ils le méritent : aucun programme PHP d’une taille respectable ne s’en passe.
Les objets sont des instances de classes, la manière qu’a PHP de réunir des données et le comportement qui les manipule. Les objets commencent vraiment au chapitre 5 ; d’ici là, vous n’en croiserez qu’un ou deux en passant.
Les types spéciaux
null signifie « aucune valeur » : pas zéro, pas une chaîne vide, rien :
<?php

$middleName = null;
Vous rencontrerez null sans arrêt, le plus souvent comme réponse à « cette fonction a-t-elle trouvé quelque chose, ou non ? ». PHP 8 a donné de vraies dents à null avec les énumérations et l’opérateur nullsafe (?->), tous deux au chapitre 6.
Le jonglage de types, et comment cesser de s’en inquiéter
Voici ce qui a fait la réputation de PHP, méritée ou non : quand un opérateur a besoin d’un certain type, PHP convertit la valeur sur place.
<?php

var_dump("5" + 3);      // int(8)
var_dump("5" . 3);      // string(2) "53"
var_dump(0 == "abc");   // false, as of PHP 8 (this used to be true!)
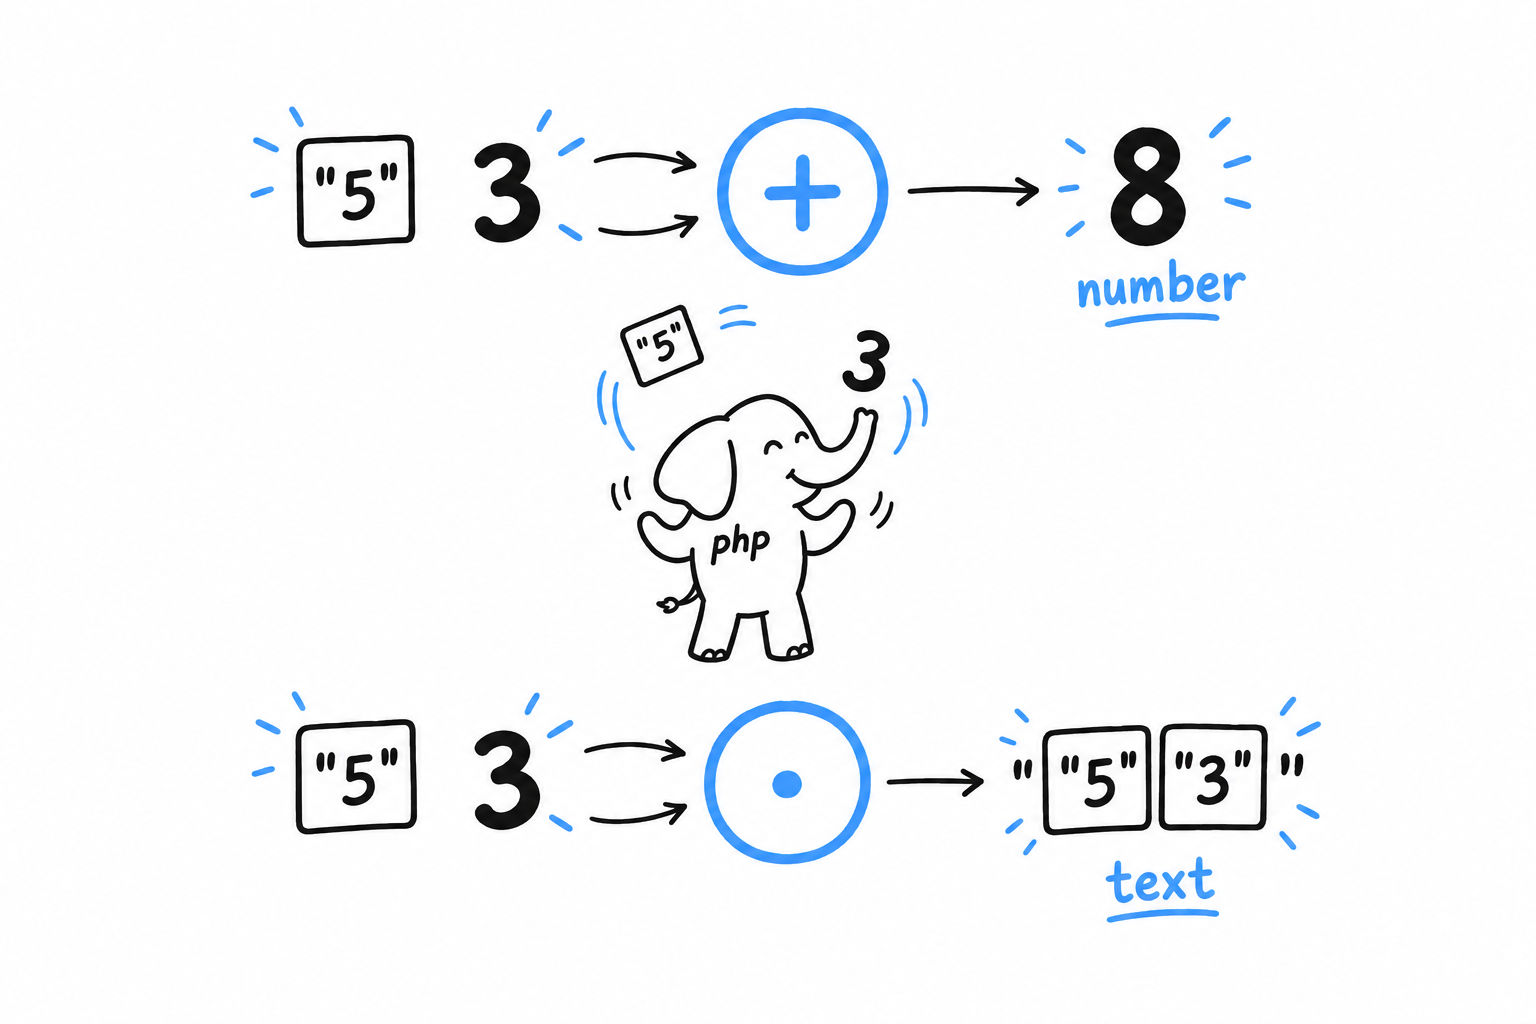
+ veut des nombres, donc la chaîne "5" devient un nombre. . (la concaténation) veut des chaînes, donc l’entier 3 devient du texte. C’est le jonglage de types, et les vieux tutoriels PHP en racontent des histoires d’horreur, surtout parce que la comparaison souple avec == avait des règles franchement surprenantes avant que PHP 8 ne les resserre. C’est aussi ce qui a transformé "banana" en un 0 silencieux dans le jeu.
Deux habitudes suffisent pour que le jonglage ne vous morde jamais.
Préférez === à ==. La comparaison stricte vérifie le type et la valeur, sans conversion : 0 === "abc" vaut simplement false, sans astérisque. Ne prenez == que lorsque vous voulez précisément la conversion.
Activez les types stricts. Placez ceci en toute première instruction du fichier, juste après <?php :
<?php
declare(strict_types=1);

function double(int $n): int {
    return $n * 2;
}

double("4"); // TypeError: no silent conversion here
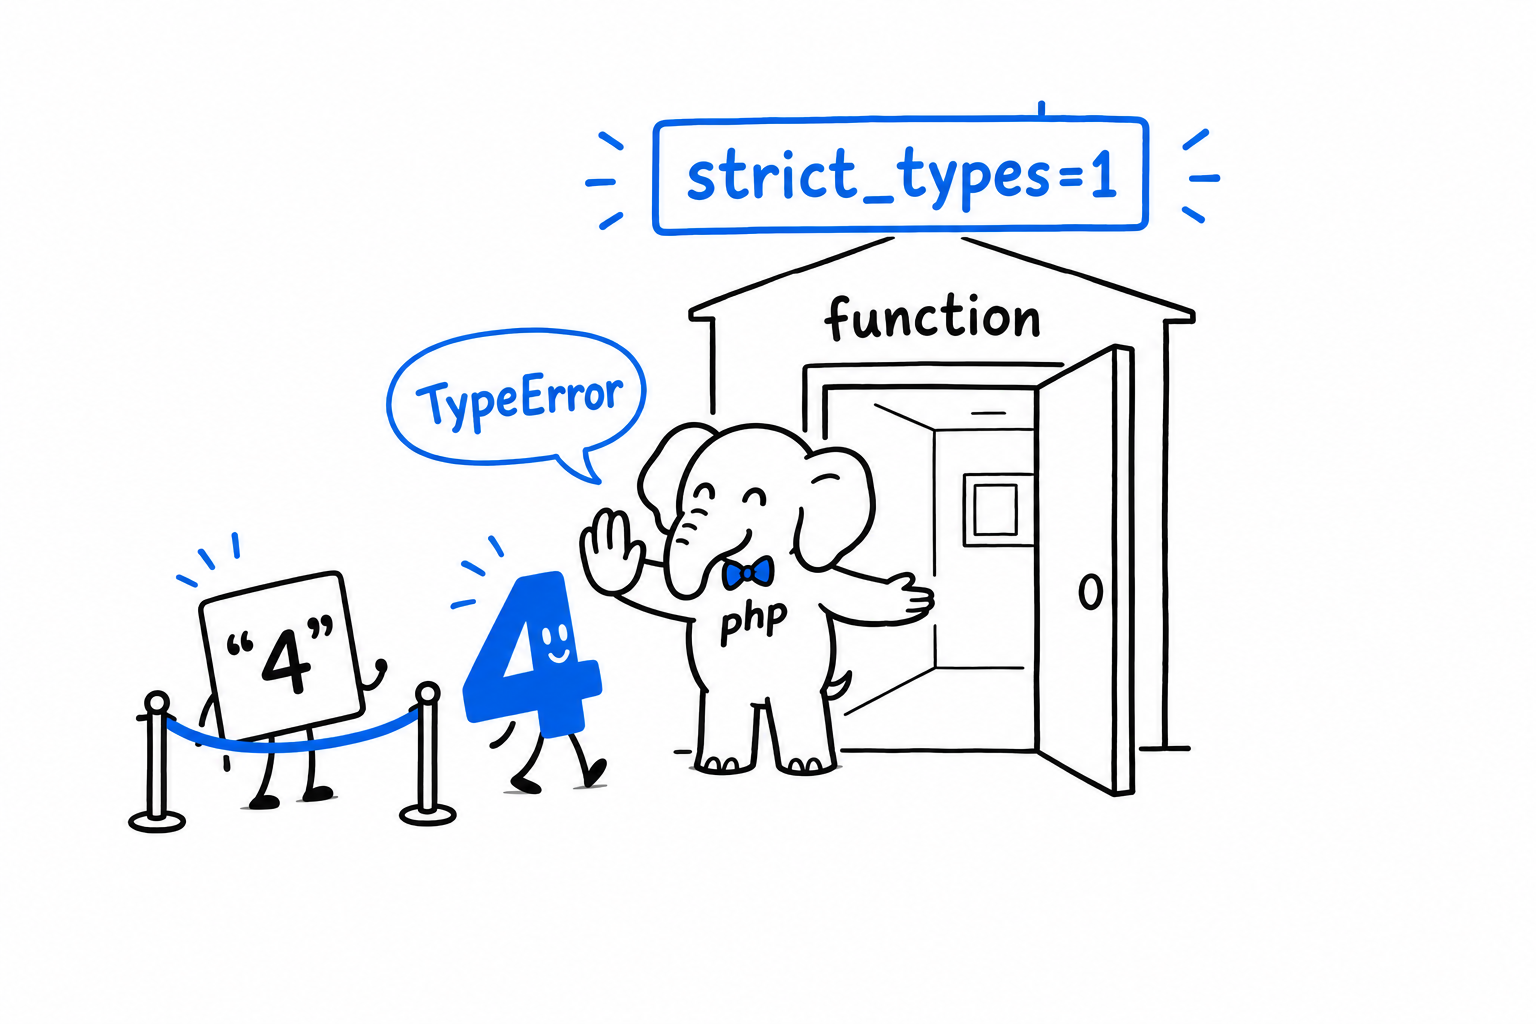
Sans declare(strict_types=1), PHP convertit discrètement "4" en 4 quand la valeur atteint un paramètre typé int. Avec, le même appel lève une TypeError. Le PHP moderne l’active presque toujours : « PHP a deviné ce que vous vouliez » devient « PHP vous a dit exactement ce qui n’allait pas », et le second est un bien meilleur rapport de bug.
La comparaison souple et la conversion silencieuse sont le défaut de PHP.
===etstrict_typesservent à les désactiver.
Les déclarations de types sur les paramètres, sur les valeurs de retour et, plus tard, sur les propriétés, apparaissent dans tous les exemples à partir d’ici. Elles sont facultatives en PHP. Traitez-les comme la règle, pas comme l’exception.
Les fonctions
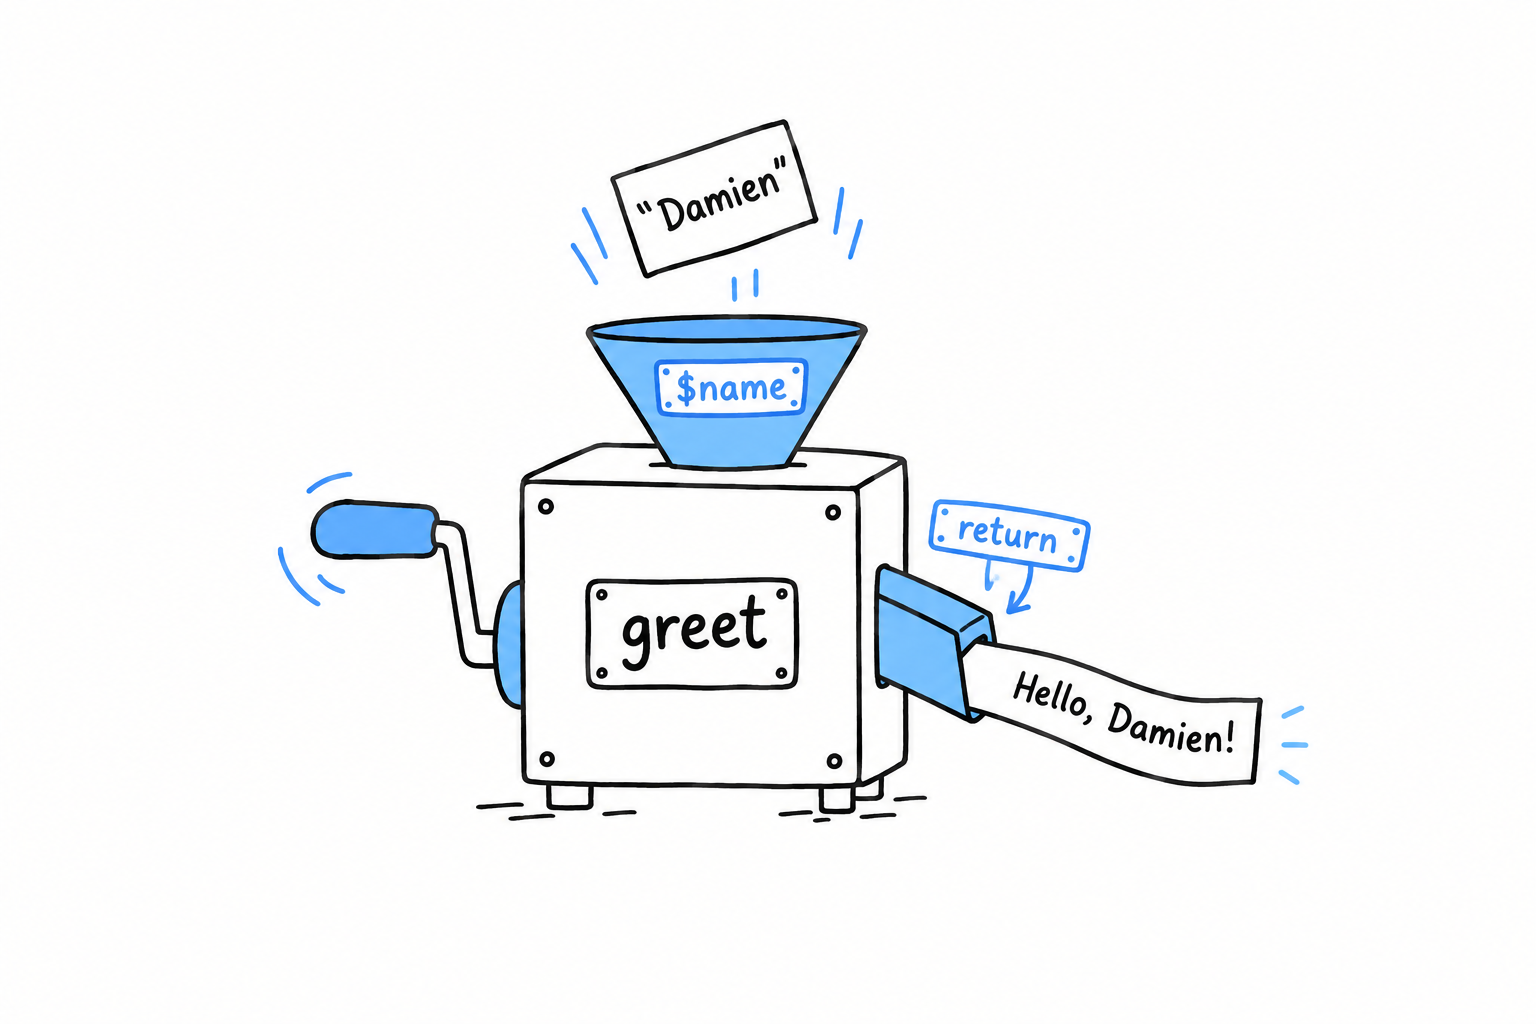
Vous appelez des fonctions depuis les premières lignes du jeu. random_int(1, 100) a choisi le secret, fgets(STDIN) a lu une ligne, trim() l’a nettoyée, is_numeric() l’a vérifiée. Chacune est un morceau de travail qui porte un nom : vous lui donnez quelque chose, elle vous rend quelque chose. (echo y ressemble mais, comme le chapitre 1 le signalait, ce n’en est pas une.) Écrivons la vôtre.
<?php

function greet($name) {
    return "Hello, {$name}!\n";
}

echo greet("Damien");
function, un nom, des parenthèses pour les paramètres, et un corps entre accolades : c’est toute la forme. Appelez greet("Damien"), et dans le corps $name contient "Damien". Par convention, les noms de fonctions s’écrivent en camelCase. Ils sont aussi insensibles à la casse à l’appel, contrairement aux variables : GREET("Damien") fonctionnerait. Ne comptez pas dessus.
Paramètres et types
Donnez un type à chaque paramètre, comme vous l’avez vu dans les types de données, et donnez aussi un type de retour à la fonction :
<?php

function greet(string $name): void {
    echo "Hello, {$name}!\n";
}
: void dit que cette fonction ne rend rien : on l’appelle uniquement pour son effet de bord, ici l’affichage. Une fonction qui rend quelque chose doit dire quoi :
<?php

function add(int $a, int $b): int {
    return $a + $b;
}

$sum = add(2, 3);
Typez chaque paramètre et chaque valeur de retour de chaque fonction que vous écrivez, à partir de maintenant. Ça coûte quelques frappes et ça supprime toute une catégorie de bugs où une fonction reçoit, ou rend, discrètement quelque chose d’inattendu. Avec declare(strict_types=1), PHP passe de « typé dynamiquement et un peu trop indulgent » à un langage qui vous arrête à la porte quand vous passez la mauvaise chose.
Les valeurs par défaut
Un paramètre peut avoir une valeur par défaut, ce qui le rend facultatif à l’appel :
<?php

function greet(string $name, string $greeting = "Hello"): string {
    return "{$greeting}, {$name}!\n";
}

echo greet("Damien");             // Hello, Damien!
echo greet("Damien", "Bonjour");  // Bonjour, Damien!
Les paramètres avec défaut viennent après ceux qui n’en ont pas. PHP lit les arguments de gauche à droite : il lui faut d’abord régler les obligatoires.
Les arguments nommés
L’ordre des arguments cesse de compter dès que vous les passez par leur nom, et nommer les arguments est un vrai confort dès qu’une fonction a plus de deux ou trois paramètres :
<?php

echo greet(name: "Damien", greeting: "Bonjour");
echo greet(greeting: "Bonjour", name: "Damien"); // order no longer matters
C’est surtout précieux avec les fonctions qui ont plusieurs paramètres facultatifs : vous allez droit à celui que vous voulez changer, au lieu d’épeler tous les défauts intermédiaires pour l’atteindre par sa position.
return sort immédiatement
return quitte la fonction sur-le-champ, avec une valeur. Rien de ce qui suit ne s’exécute :
<?php

function classify(int $n): string {
    if ($n < 0) {
        return "negative";
    }

    if ($n === 0) {
        return "zero";
    }

    return "positive";
}
Pas de « la dernière expression est le résultat » implicite, comme dans certains langages. PHP veut toujours un return explicite. Oubliez-le, et la fonction renvoie null, en silence. C’est en général un bug plutôt qu’un choix, et c’est pourquoi déclarer : void sur les fonctions qui ne renvoient vraiment rien mérite de devenir une habitude : PHP, et tout outil d’analyse statique qui lit votre code, peut alors signaler une valeur qui s’échappe par accident.
Les fonctions sont des valeurs
Une dernière chose, bonne à savoir tôt même si elle ne prend tout son sens qu’au chapitre 15 : une fonction est une valeur, elle aussi. Vous pouvez la garder dans une variable et l’appeler depuis là :
<?php

$operation = 'add';
echo $operation(2, 3); // calls add(2, 3), if add() is defined above
Et PHP a de vraies fonctions anonymes, les closures, pour quand vous devez faire circuler un comportement sans lui donner de nom :
<?php

$double = function (int $n): int {
    return $n * 2;
};

echo $double(21); // 42
Rangez ça dans un coin. Ça comptera beaucoup plus tard, quand vous confierez de petits morceaux de comportement aux fonctions de tableaux et aux générateurs.
Les commentaires
Le jeu de devinette n’a aucun commentaire, et à trente lignes il n’en a pas besoin. Mais les programmes grandissent, et tôt ou tard une ligne réclame une note à côté d’elle : pourquoi cette vérification est là, ce que signifie ce nombre, quel bug elle contourne. Un commentaire est un texte que PHP ignore entièrement et qu’un humain lit. PHP vous donne trois façons d’en écrire un, un héritage de ses débuts comme langage de gabarits.
<?php

// A single-line comment.

# Also a single-line comment, same effect, different heritage
// (this style is borrowed from shell scripts; you'll see it far less often).

/*
 * A multi-line comment,
 * for when one line isn't enough.
 */
En pratique // domine pour les notes de tous les jours, et /* ... */ sert aux commentaires plus longs et plus structurés, le plus souvent sous la forme d’un docblock posé juste au-dessus d’une fonction ou d’une classe :
<?php

/**
 * Calculates compound interest.
 *
 * @param float $principal Starting amount
 * @param float $rate Annual interest rate, as a decimal (e.g. 0.05 for 5%)
 * @param int $years Number of years to compound
 * @return float The final amount after compounding
 */
function compoundInterest(float $principal, float $rate, int $years): float {
    return $principal * (1 + $rate) ** $years;
}
L’ouverture /**, deux astérisques et non un, marque un docblock. C’est une convention, pas une fonctionnalité du langage, mais votre éditeur, PHPStan et les générateurs de documentation y lisent tous les balises @param et @return. Les docblocks prennent toute leur valeur au chapitre 11, où le système de types de PHP a besoin d’un coup de main des commentaires pour dire ce que le langage ne sait pas encore exprimer.
Ce qui mérite un commentaire
Moins que vous ne le pensez. Une fonction bien nommée, avec des paramètres bien typés, s’explique toute seule. Un commentaire qui répète ce que dit déjà le code vous donne deux endroits à garder synchronisés, et PHP n’en vérifie qu’un.
<?php

// Bad: says what, which the code already says
// Increment the counter by one
$counter++;

// Good: says why, which the code can't say on its own
// Retry once more here: the upstream API is flaky on cold start
$retries++;
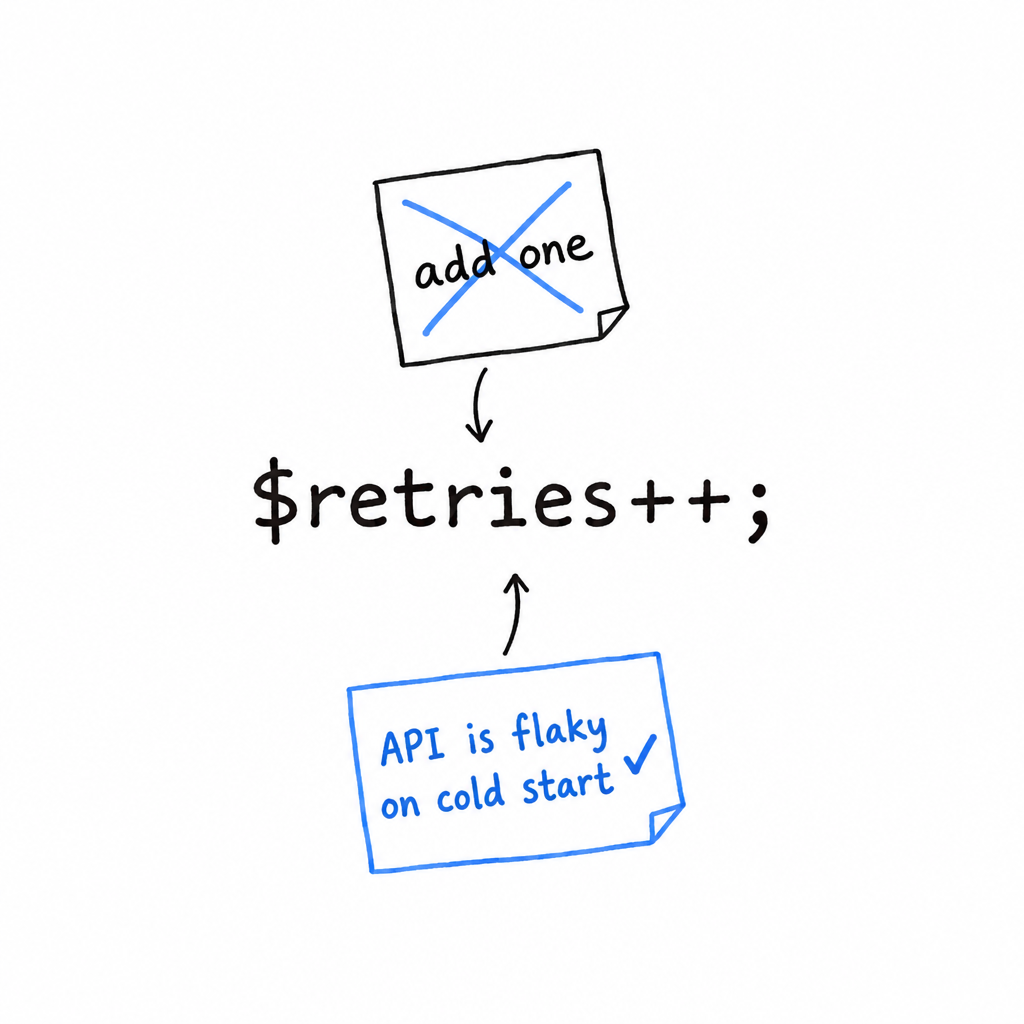
Commentez le pourquoi, pas le quoi. Un commentaire qui explique un contournement, une contrainte peu évidente ou une décision qui paraîtrait fausse hors contexte vaut son pesant d’or. Un commentaire qui traduit le code en français, ligne par ligne, est une chose de plus qui se périmera la prochaine fois que quelqu’un modifiera la ligne sans toucher à la note au-dessus.
Les structures de contrôle
Réduisez le jeu de devinette à son squelette, et il reste deux mots : if et while. L’un décide, l’autre répète. Tout ce qu’un programme fait au-delà de s’exécuter de haut en bas vient de ces deux gestes, et PHP a quelques variantes de chacun.
if / elseif / else
<?php

$temperature = 18;

if ($temperature > 30) {
    echo "Hot.\n";
} elseif ($temperature > 15) {
    echo "Pleasant.\n";
} else {
    echo "Bring a jacket.\n";
}
Même forme que la comparaison du jeu : PHP exécute le premier bloc dont la condition est vraie et ignore les autres, ou se rabat sur else. C’est elseif, en un mot. else if, en deux mots, fonctionne aussi, mais seul elseif est un jeton unique pour PHP, c’est donc la convention à adopter.
La condition n’a pas à être un booléen, mais écrivez-la comme si c’était le cas. PHP convertit ce que vous lui donnez : 0, "", null et [] comptent pour faux, tout le reste pour vrai. S’appuyer là-dessus, c’est exactement le genre de jonglage de types contre lequel les types de données vous ont mis en garde. Préférez une comparaison explicite dès que la valeur n’est pas déjà, à l’évidence, un booléen.
Une chaîne de if/elseif est à son meilleur quand chaque branche teste quelque chose de différent, comme $temperature > 30 et $temperature > 15 ci-dessus. Quand vous vous surprenez à écrire plusieurs branches qui comparent toutes la même valeur à une liste de possibilités, cette répétition est le signal de passer à l’outil suivant.
match
PHP 8 a ajouté match, et une fois qu’on l’a utilisé, switch ressemble à une relique :
<?php

$httpStatus = 404;

$message = match (true) {
    $httpStatus >= 200 && $httpStatus < 300 => "Success",
    $httpStatus >= 400 && $httpStatus < 500 => "Client error",
    $httpStatus >= 500 => "Server error",
    default => "Unknown",
};

echo $message; // Client error
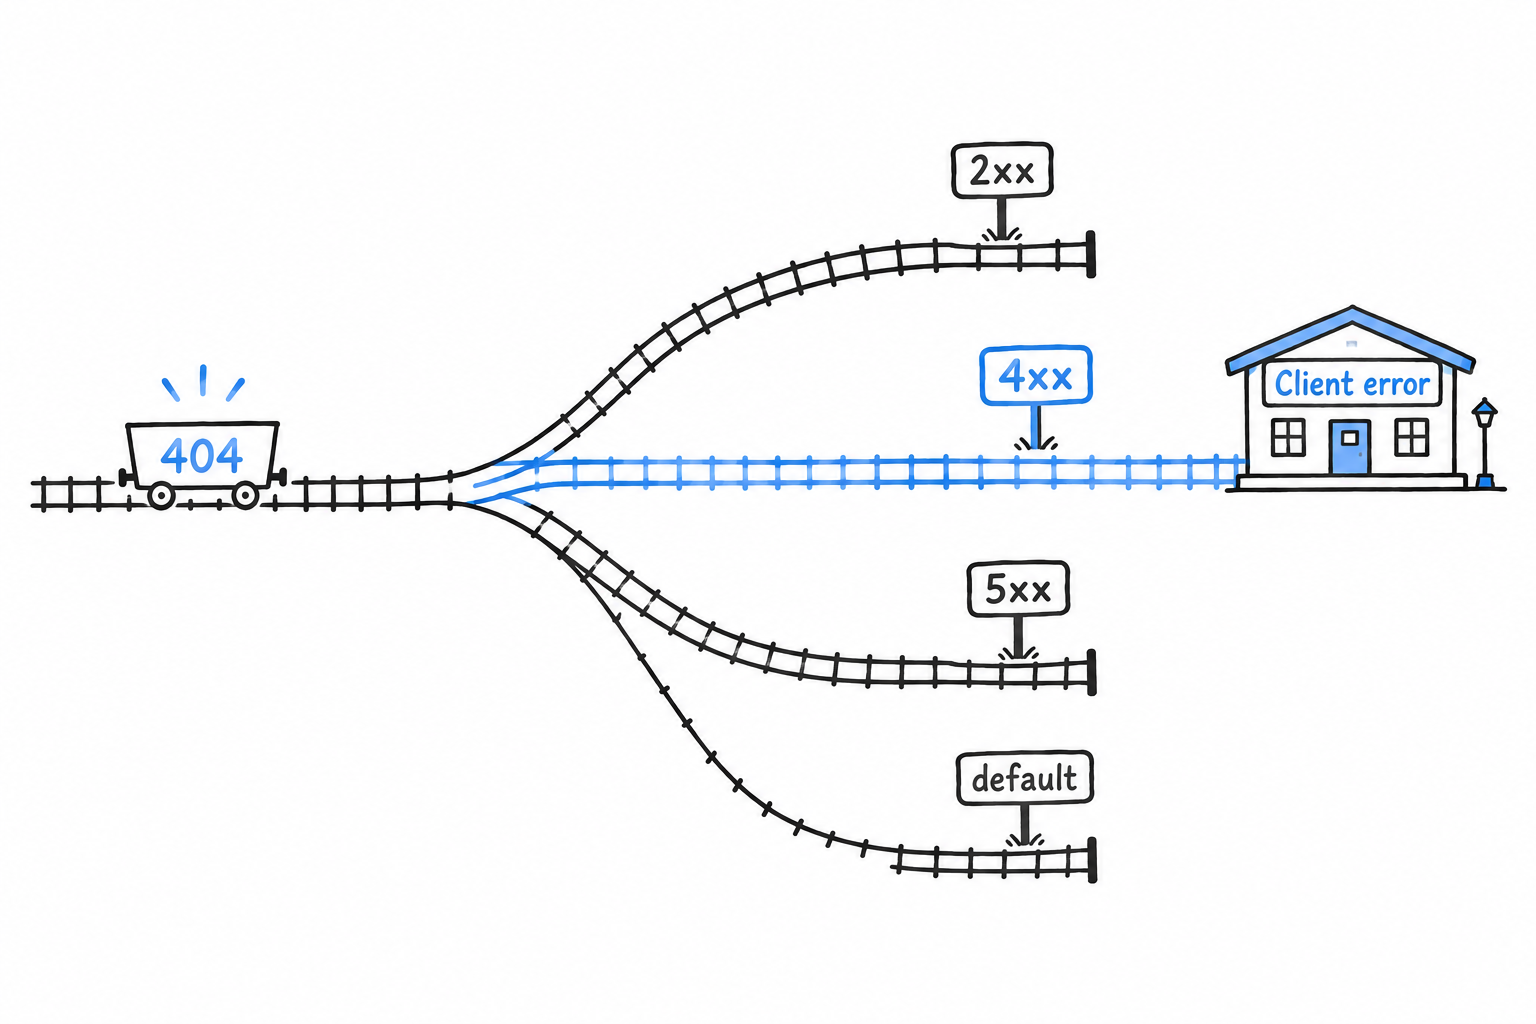
match est une expression : il produit une valeur, que vous affectez, comme ci-dessus, au lieu d’une instruction dans laquelle on bifurque. Deux autres choses en font une vraie amélioration par rapport à switch. Ses comparaisons sont strictes, ===, donc aucun jonglage ne fait passer une mauvaise branche en douce. Et il n’a pas de fallthrough, donc pas de break à oublier. Le chapitre 6 associe match aux énumérations, et les deux se révèlent faits l’un pour l’autre.
Les boucles
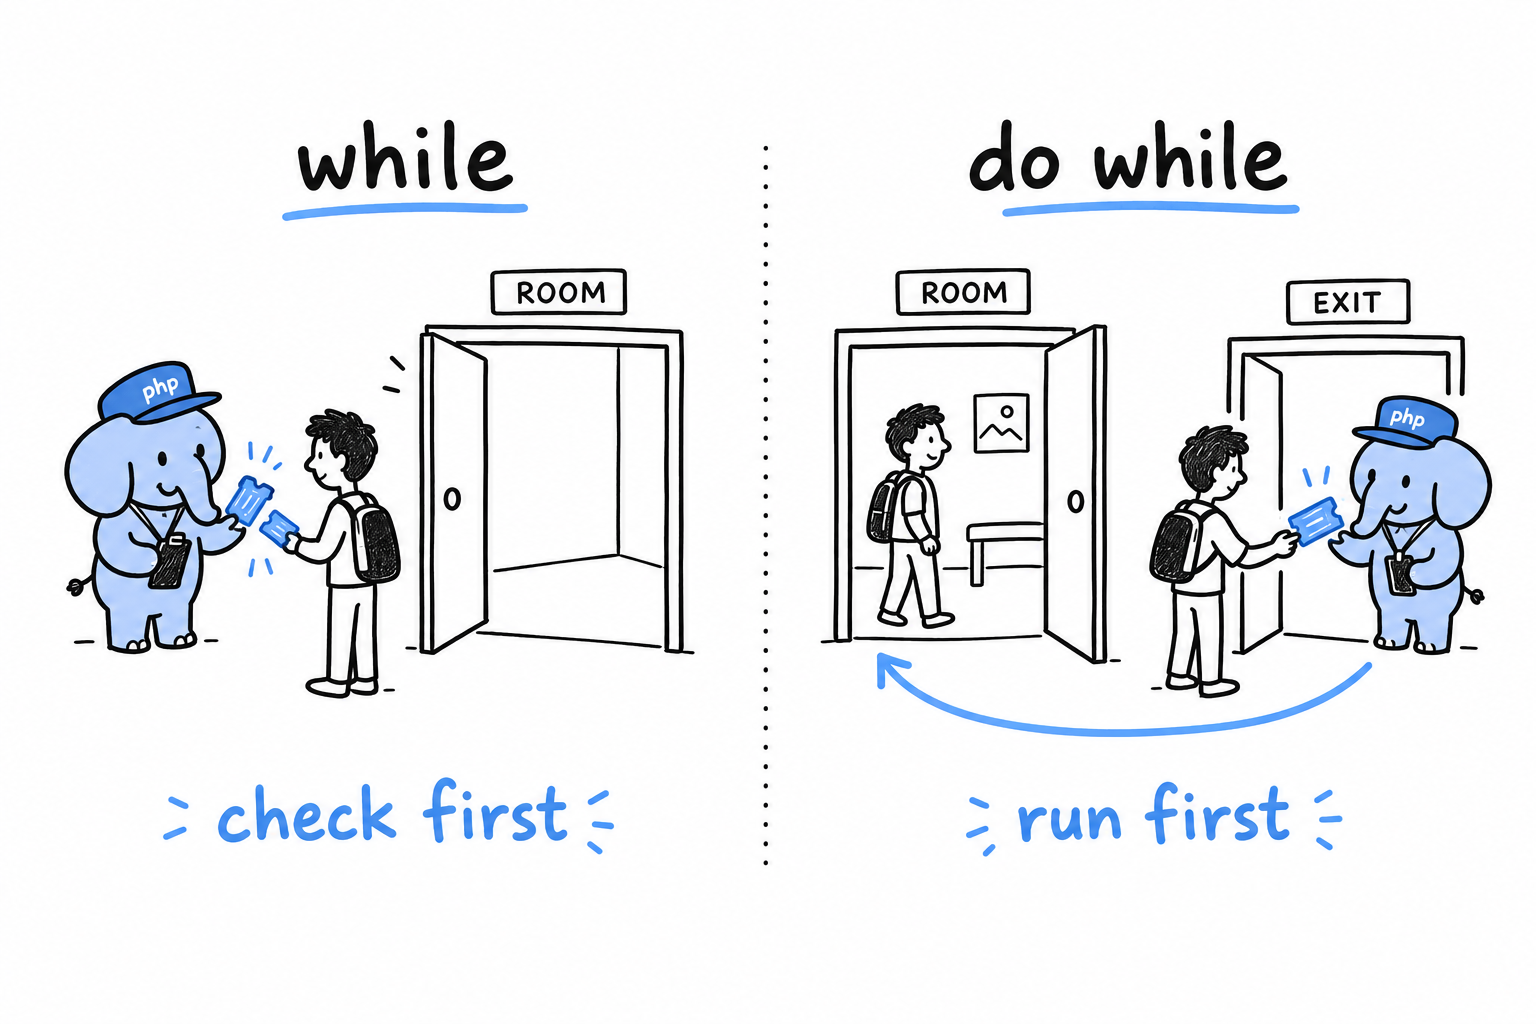
while tourne tant que sa condition tient, et la vérifie avant chaque passage :
<?php

$count = 3;
while ($count > 0) {
    echo "{$count}...\n";
    $count--;
}
echo "Go!\n";
Le while (true) du jeu était le cas extrême : une condition qui ne devient jamais fausse, et break comme seule sortie.
do...while vérifie la condition après chaque passage, si bien que le corps s’exécute au moins une fois :
<?php

do {
    echo "This runs once even if the condition is already false.\n";
} while (false);
for est la boucle classique en trois parties, chez elle dès qu’il vous faut un compteur :
<?php

for ($i = 0; $i < 5; $i++) {
    echo "{$i}\n";
}
Valeur de départ, condition, pas, le tout sur une ligne : $i part de 0, le corps tourne tant que $i < 5, et $i++ ajoute un après chaque passage.
foreach parcourt directement une collection, sans compteur à tenir, et c’est la boucle que vous prendrez sans cesse dès que les tableaux arriveront au chapitre 8 :
<?php

$fruits = ["apple", "banana", "cherry"];

foreach ($fruits as $fruit) {
    echo "{$fruit}\n";
}

$prices = ["apple" => 0.5, "banana" => 0.3];

foreach ($prices as $name => $price) {
    echo "{$name}: \${$price}\n";
}
La seconde forme, as $name => $price, extrait la clé et la valeur d’un coup. Elle est si fréquente dans le vrai code PHP qu’elle vaut d’être mémorisée dès maintenant.
break et continue, encore une fois
Vous les avez rencontrés tous les deux dans le jeu : break quitte la boucle sur-le-champ, continue saute au tour suivant.
<?php

foreach ([1, 2, 3, 4, 5] as $n) {
    if ($n === 3) {
        continue; // skip 3, keep going
    }
    if ($n === 5) {
        break; // stop entirely once we hit 5
    }
    echo "{$n}\n";
}
// prints 1, 2, 4
Tous deux acceptent un nombre facultatif : break 2 quitte deux boucles imbriquées d’un coup. N’y touchez que si c’est plus lisible que de restructurer les boucles. Les niveaux de break imbriqués sont évidents quand on les écrit et déroutants un mois plus tard.
Essayez : réécrivez la comparaison à trois branches du jeu sous la forme d’un match (true) qui produit le message, puis affichez-le. Le break doit rester hors du match, puisqu’un match produit une valeur et ne fait rien d’autre. Cette petite résistance, c’est la différence entre une expression et une instruction, sentie sous vos propres doigts.
Bifurquer, répéter, piloter. Le reste du livre n’ajoute jamais un nouveau geste, seulement des formes plus grandes faites de ceux-là.
Travailler avec les variables et les références
Depuis le jeu de devinette du chapitre 2, vous écrivez $x = $y sans y penser. Cette ligne mérite qu’on s’y arrête.
Écrivez-la avec un tableau, puis avec un objet, et modifiez la copie à chaque fois. Avec un tableau, l’original ne bouge pas. Avec un objet, l’original change aussi. Même ligne, deux comportements opposés, et la différence n’est pas un détail du moteur. C’est l’une des surprises les plus fréquentes pour qui arrive d’un autre langage, et l’une des sources les plus sûres de bugs étranges pour qui ne se l’est jamais fait expliquer. Prenez-la à l’envers, et un jour une fonction « ne marchera pas » sans raison visible, jusqu’à ce que vous ayez lu ce chapitre.
Les tableaux se comportent comme si chaque affectation vous fabriquait une copie neuve et indépendante. Les objets se comportent comme si chaque variable qui en tient un n’était qu’un nom de plus pour la même chose. La première section regarde comment PHP copie les tableaux, et l’astuce qu’il emploie pour que ça ne coûte presque rien. La deuxième présente le & qui permet de partager une variable exprès, et la façon dont les objets sont partagés que vous le demandiez ou non. Les références sont un outil tranchant, utile dans quelques situations précises et source de code confus quand on y recourt par habitude ; vous apprendrez donc aussi où elles méritent leur place.
Le chapitre se termine sur deux idées plus petites qui habitent à côté : ce qu’une fonction voit, ou ne voit pas, des variables autour d’elle, et la façon dont PHP se débarrasse de la mémoire dont il n’a plus besoin. Ni l’une ni l’autre n’est longue à apprendre, et les deux reviendront plus loin dans le livre.
Comment PHP gère les valeurs : la copie à l’écriture
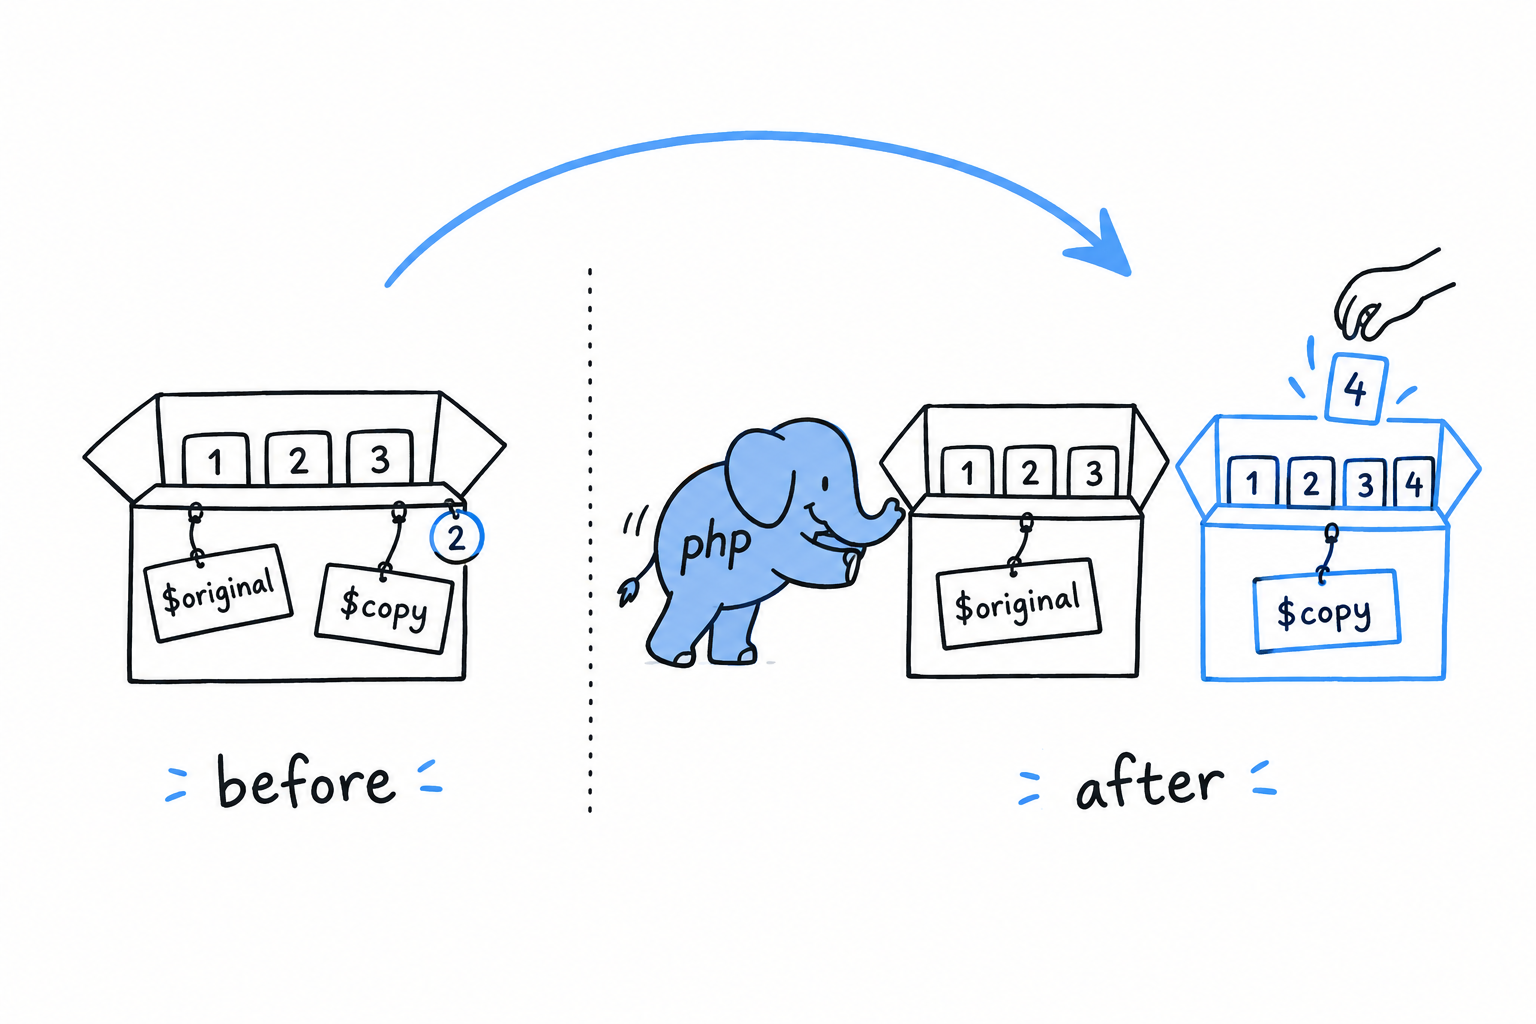
Affectez un tableau à une seconde variable, ajoutez quelque chose à la seconde, et regardez la première :
<?php

$original = [1, 2, 3];
$copy = $original;

$copy[] = 4;

var_dump($original); // array(3) { [0]=> int(1) [1]=> int(2) [2]=> int(3) }
var_dump($copy);     // array(4) { [0]=> int(1) [1]=> int(2) [2]=> int(3) [3]=> int(4) }
$original a toujours trois éléments. Copier un tableau donne un tableau indépendant : modifiez la copie autant que vous voulez, l’original ne bouge pas. Imaginez $copy = $original comme PHP parcourant le tableau et recopiant chaque élément dans une boîte neuve. C’est l’image à garder, et pour l’essentiel du PHP quotidien, elle suffit.
Copiez un tableau, modifiez la copie : l’original ne bouge pas.
Mais il ne copie pas vraiment tout de suite
Voici ce qui se passe réellement, et ça vaut la peine de le savoir même si ça change rarement la façon d’écrire du code. Dupliquer un tableau à l’instant où on l’affecte serait du gaspillage : beaucoup de tableaux circulent sans jamais être modifiés, et la copie serait du travail pour rien. PHP attend, et ne copie le tableau qu’au moment où l’un des deux côtés essaie de le modifier. Cette stratégie s’appelle la copie à l’écriture, copy-on-write en anglais.
L’affectation $copy = $original fait pointer les deux noms vers les mêmes données, et PHP tient un petit compte du nombre de variables qui les partagent. Lire par l’un ou l’autre nom ne coûte rien. La première écriture par l’un d’eux ($copy[] = 4 ci-dessus) est le moment où PHP intervient : il fabrique une vraie copie, séparée, et applique la modification à cette copie seulement.
<?php

$original = ["apple", "banana"];
$copy = $original; // no copying has happened yet, both point at the same data

foreach ($copy as $fruit) {
    echo $fruit . "\n"; // just reading, still sharing
}

$copy[] = "cherry"; // *now* PHP actually duplicates the array
Rien de tout cela n’est visible depuis votre programme. Aucune fonction à appeler, aucun délai, rien qui se comporte différemment selon que la copie a « vraiment » eu lieu ou non. C’est une pure optimisation que le moteur fait pour vous. Le mot vaut quand même la peine d’être connu, parce que « copy-on-write » revient dans les discussions sur les performances de PHP, dans le texte des RFC et dans la sortie de certains profileurs, et il est bon de savoir que ça n’a rien d’exotique. C’est PHP qui paresse sur une copie qu’il allait de toute façon vous donner.
Pourquoi ça compte pour les fonctions
Passez un tableau à une fonction, et la fonction reçoit ce qui se comporte comme sa propre copie :
<?php
declare(strict_types=1);

function addTax(array $prices): array
{
    foreach ($prices as $key => $price) {
        $prices[$key] = round($price * 1.2, 2);
    }
    return $prices;
}

$cart = ["book" => 10.00, "pen" => 2.00];
$withTax = addTax($cart);

var_dump($cart);     // unchanged: book => 10.00, pen => 2.00
var_dump($withTax);  // book => 12.00, pen => 2.40
addTax() réécrit $prices à sa guise, et rien n’en ressort vers $cart. Une fonction qui reçoit un tableau ne peut pas revenir réécrire les données de l’appelant, sauf si celui-ci l’autorise explicitement. C’est en général exactement ce que vous voulez : vous confiez des données à une fonction, elle vous en rend, et ce que vous teniez est toujours ce que vous teniez. Essayez : ajoutez $prices["hat"] = 5.00; juste avant le return et affichez $cart à nouveau. Toujours deux articles.
Parfois, vous voulez vraiment qu’une fonction modifie sur place le tableau de l’appelant. La copie à l’écriture ne peut pas vous l’offrir. Les références, si, et c’est le sujet de la section suivante.
Une chose à signaler avant d’y arriver : tout ce qui précède parle de tableaux. Affectez un objet à une autre variable et vous n’obtenez pas de copie indépendante, paresseuse ou non. Ce contraste mérite son propre traitement, juste après le &.
Passage par valeur et passage par référence
Copiez une variable, modifiez la copie, et l’original ne bouge pas. C’est le comportement par défaut de PHP, et il a un nom : le passage par valeur. C’est ce qui se passe partout en PHP tant que vous ne demandez pas autre chose. Cette section explique comment demander autre chose, et s’arrête sur le seul endroit où PHP vous donne autre chose sans que vous l’ayez demandé : les objets.
Les références explicites avec &
Placez & devant une variable au moment de l’affecter, et les deux noms n’en font plus qu’un :
<?php

$a = 10;
$b = &$a; // $b is now an alias for $a, not a copy of its value

$b = 20;

echo $a; // 20
Après $b = &$a, $a et $b ne sont pas deux variables contenant des valeurs égales. Ce sont deux étiquettes collées sur la même boîte. Changez la valeur par l’une ou l’autre étiquette, et vous l’avez changée pour les deux, puisqu’il n’y a jamais eu qu’une seule boîte.
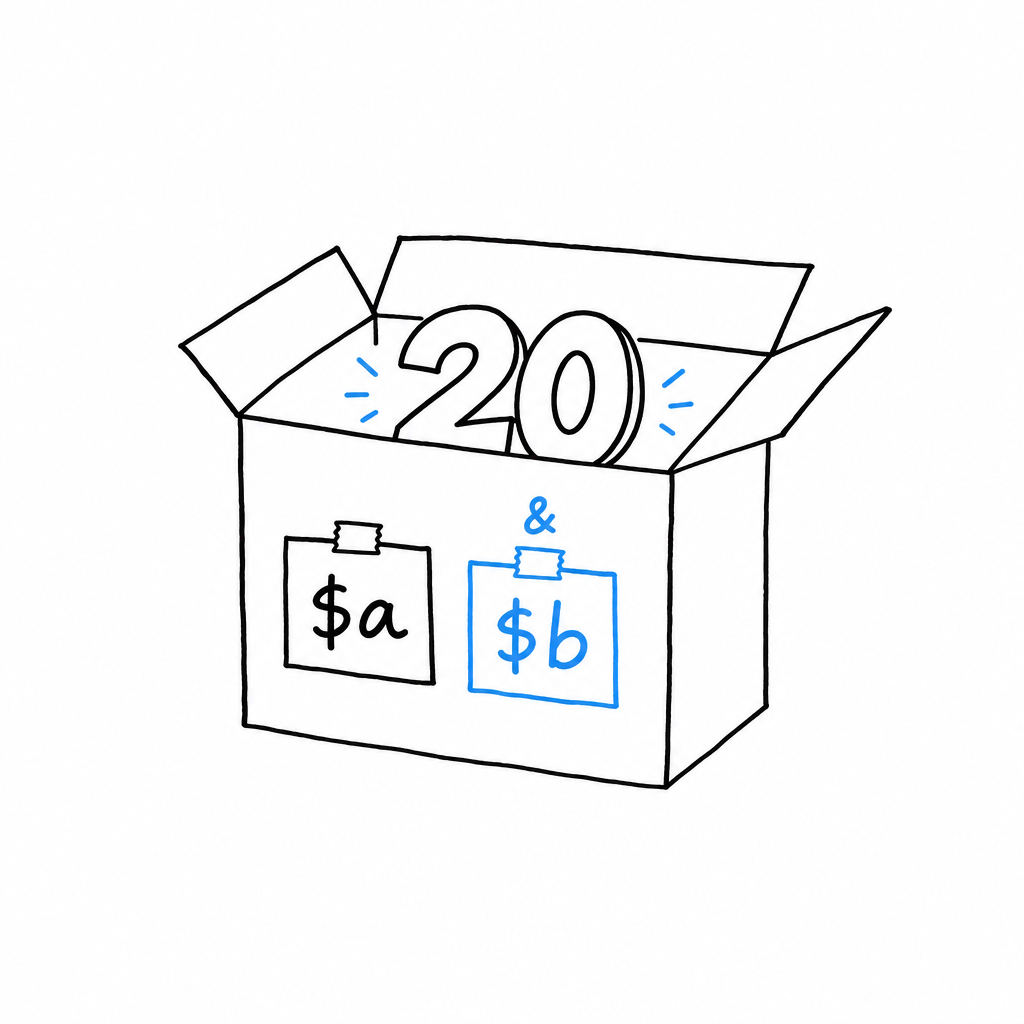
Une référence, c’est une deuxième étiquette sur la même boîte.
Le même & fonctionne sur un paramètre de fonction :
<?php
declare(strict_types=1);

function addTax(array &$prices): void
{
    foreach ($prices as $key => $price) {
        $prices[$key] = round($price * 1.2, 2);
    }
}

$cart = ["book" => 10.00, "pen" => 2.00];
addTax($cart);

var_dump($cart); // book => 12.00, pen => 2.40, modified in place
Comparez avec le addTax() de la section précédente : même corps, mais le & devant $prices change tout pour l’appelant. Sans lui, la fonction recevait une valeur qu’elle pouvait modifier sans conséquence. Avec lui, $prices à l’intérieur de la fonction est $cart à l’extérieur : pas de copie du tout, pas même paresseuse. Un paramètre par référence permet à une fonction de modifier sur place la variable de l’appelant. C’est exactement ainsi que travaille sort(), une vraie fonction native, qui réordonne votre tableau à travers une référence au lieu de vous en rendre un nouveau.
Warning
Le
&se prête à l’abus. Une fonction dont la signature en porte un change discrètement son contrat, de « donne-moi des données, je t’en rends » à « laisse-moi entrer dans ta variable et la modifier », et c’est une promesse plus lourde qu’elle n’en a l’air. Réservez-le aux cas où la modification sur place est tout l’intérêt (trier, remplir un tampon) et renvoyez une valeur partout ailleurs. Le code qui renvoie son résultat se lit et se teste seul. Le code parsemé de paramètres&envoie le lecteur vérifier chaque appel pour savoir ce qui a pu changer.
Les tableaux se copient, les objets non
Voici la surprise vers laquelle tout le chapitre avançait. Lisez-la lentement : elle piège presque tout le monde la première fois.
Vous savez que les tableaux se copient. Les objets, non. Affectez un objet à une variable, passez-le à une fonction, rangez-le dans un tableau : PHP ne duplique jamais l’objet lui-même. Chaque variable qui « tient » un objet tient en réalité une poignée vers l’unique exemplaire qui vit en mémoire. Copiez la variable tant que vous voulez, vous copiez la poignée, pas ce qu’il y a au bout.
<?php
declare(strict_types=1);

class Cart
{
    public array $items = [];
}

$cartA = new Cart();
$cartA->items[] = "book";

$cartB = $cartA; // NOT a copy, $cartB points at the same Cart instance
$cartB->items[] = "pen";

var_dump($cartA->items); // ["book", "pen"], both items show up here too
var_dump($cartB->items); // ["book", "pen"]
Si class et new sont nouveaux pour vous, le chapitre 5 les explique posément. Pour l’instant, lisez new Cart() comme « fabrique un panier » et ->items comme « sa liste d’articles ».
$cartB = $cartA ressemble trait pour trait au $copy = $original des tableaux. Il ne se comporte pas du tout pareil. Il n’y a qu’un seul Cart ici, et $cartA et $cartB sont deux étiquettes dessus. Ajoutez un stylo par l’une ou l’autre, et l’autre le voit aussitôt, parce qu’il n’y a rien d’autre à voir.
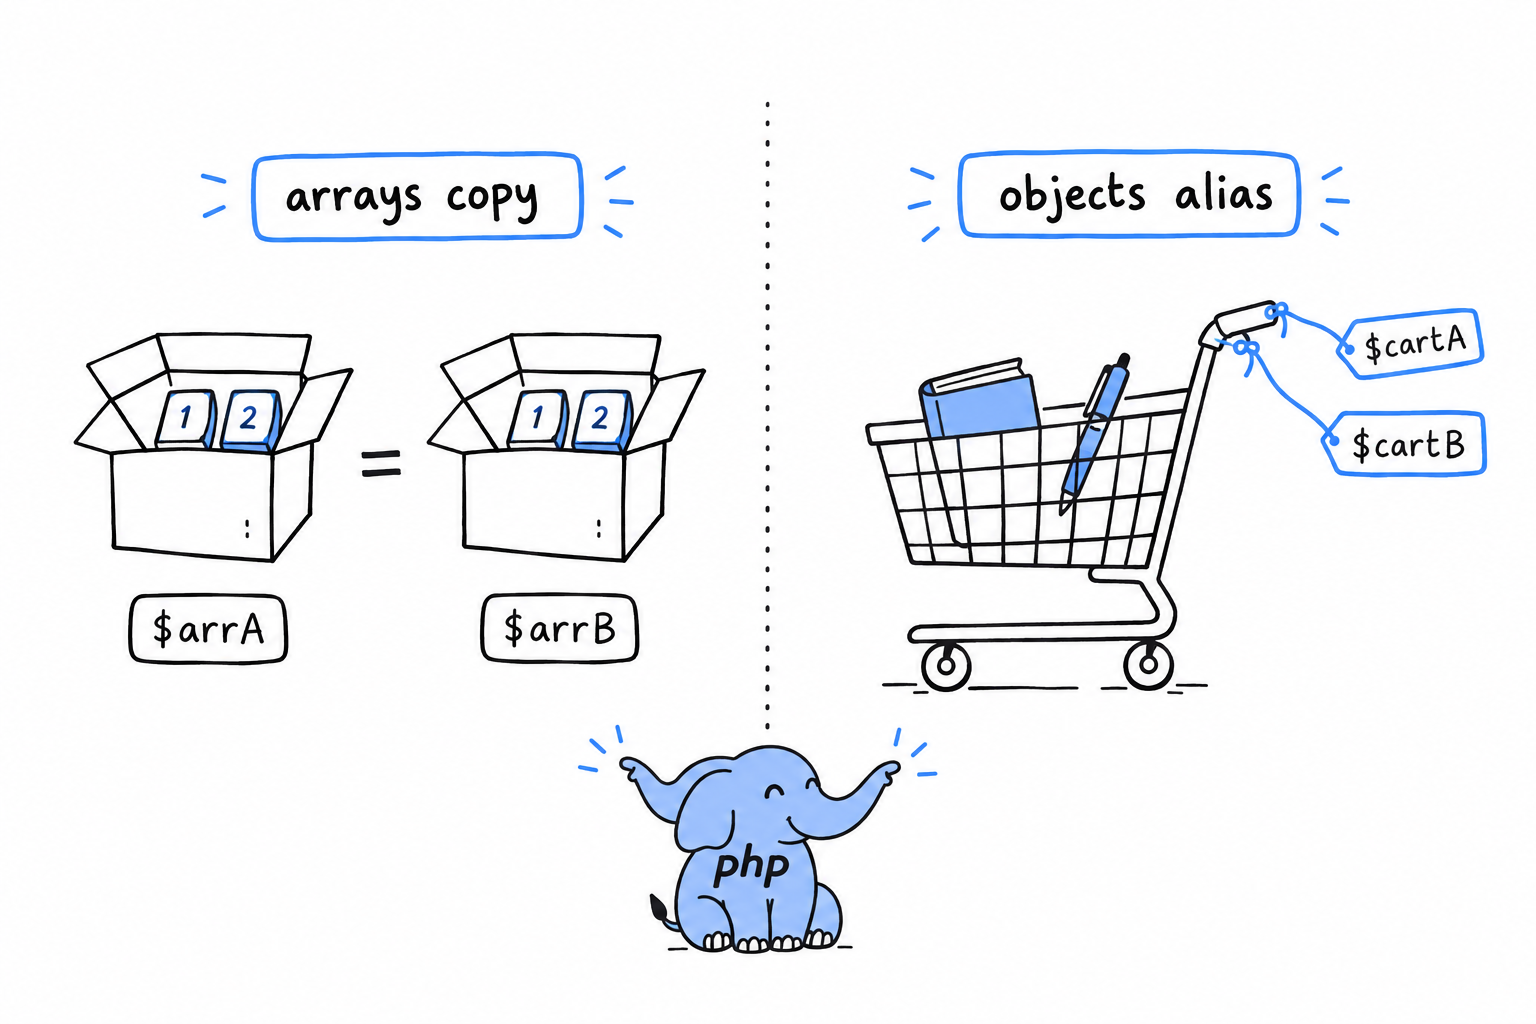
C’est la cause la plus fréquente des « pourquoi ma fonction a-t-elle modifié quelque chose qu’elle n’était pas censée toucher » dans le code PHP des débutants, et elle joue dans le sens inverse de la confusion sur les tableaux. On s’attend à ce que les objets se copient comme les tableaux, on se brûle une fois, puis on surcorrige en supposant que tout se partage comme les objets. Aucune des deux hypothèses n’est bonne.
Les tableaux se copient, les objets se partagent.
Passer un objet à une fonction ne protège jamais les données de l’appelant comme le fait un tableau. La fonction reçoit une poignée vers le même exemplaire, et tout ce qu’elle fait à travers cette poignée est visible dès qu’elle rend la main, sans & :
<?php
declare(strict_types=1);

function addItem(Cart $cart, string $item): void
{
    $cart->items[] = $item; // this mutates the caller's actual Cart
}

$cart = new Cart();
addItem($cart, "notebook");

var_dump($cart->items); // ["notebook"], visible outside the function, no & needed
Pas de & dans addItem(), et pas besoin. Les objets sont toujours « passés par poignée ». Vous entendrez dire « passés par référence », ce qui est proche mais pas le terme exact en PHP : à l’intérieur de la fonction, vous pouvez toujours réaffecter $cart à un autre objet sans toucher la variable de l’appelant. Essayez : mettez $cart = new Cart(); en première ligne de addItem(). Le carnet part dans un panier que personne d’autre ne tient, et le $cart->items de l’appelant reste vide. Ce que vous ne pouvez pas faire, c’est modifier l’objet au bout de la poignée sans que la modification apparaisse partout où cet objet est tenu.
clone, la porte de sortie
Parfois, vous voulez bel et bien un second Cart indépendant, qui démarre avec les mêmes articles puis suit son propre chemin. C’est le rôle de clone :
<?php
declare(strict_types=1);

$cartA = new Cart();
$cartA->items[] = "book";

$cartB = clone $cartA; // a genuine, separate copy
$cartB->items[] = "pen";

var_dump($cartA->items); // ["book"], untouched
var_dump($cartB->items); // ["book", "pen"]
clone crée un nouvel objet avec les mêmes valeurs de propriétés, et à partir de là les deux sont pleinement indépendants, le comportement que vous auriez pu attendre d’une simple affectation. Une réserve, à noter dès maintenant : clone copie sur un seul niveau. Si l’une des propriétés de Cart était elle-même un objet plutôt qu’un simple tableau, le clone et l’original partageraient encore cet objet imbriqué, poignée comprise, à moins d’y remédier. PHP donne aux classes une méthode __clone() exactement pour ça, et le livre y revient une fois que vous aurez passé plus de temps avec les classes, à partir du chapitre 5.
Portée des variables et ramasse-miettes
Chaque fonction a sa propre portée
Une variable créée dans une fonction vit dans cette fonction, et nulle part ailleurs :
<?php
declare(strict_types=1);

function greet(): void
{
    $message = "Hello from inside greet()";
    echo $message . "\n";
}

greet();
echo $message ?? "no such variable out here\n";
Lancez-le. La seconde ligne affiche « no such variable out here » : le $message de greet() et n’importe quel $message qui traînerait dehors n’ont aucun lien, même s’ils portent le même nom. Chaque fonction a son propre jeu de variables, invisible de l’extérieur. C’est ce qu’on appelle la portée locale, et c’est le bon réglage par défaut. Sans elle, tous les noms de variables de toutes les fonctions se disputeraient un seul espace commun, et appeler une fonction que vous n’avez pas écrite serait un petit acte de foi : pourvu qu’elle n’ait pas écrasé l’une des vôtres en passant.
Imaginez chaque fonction comme une pièce avec ses propres étagères. Une boîte posée dans une pièce n’existe pas dans la pièce d’à côté.
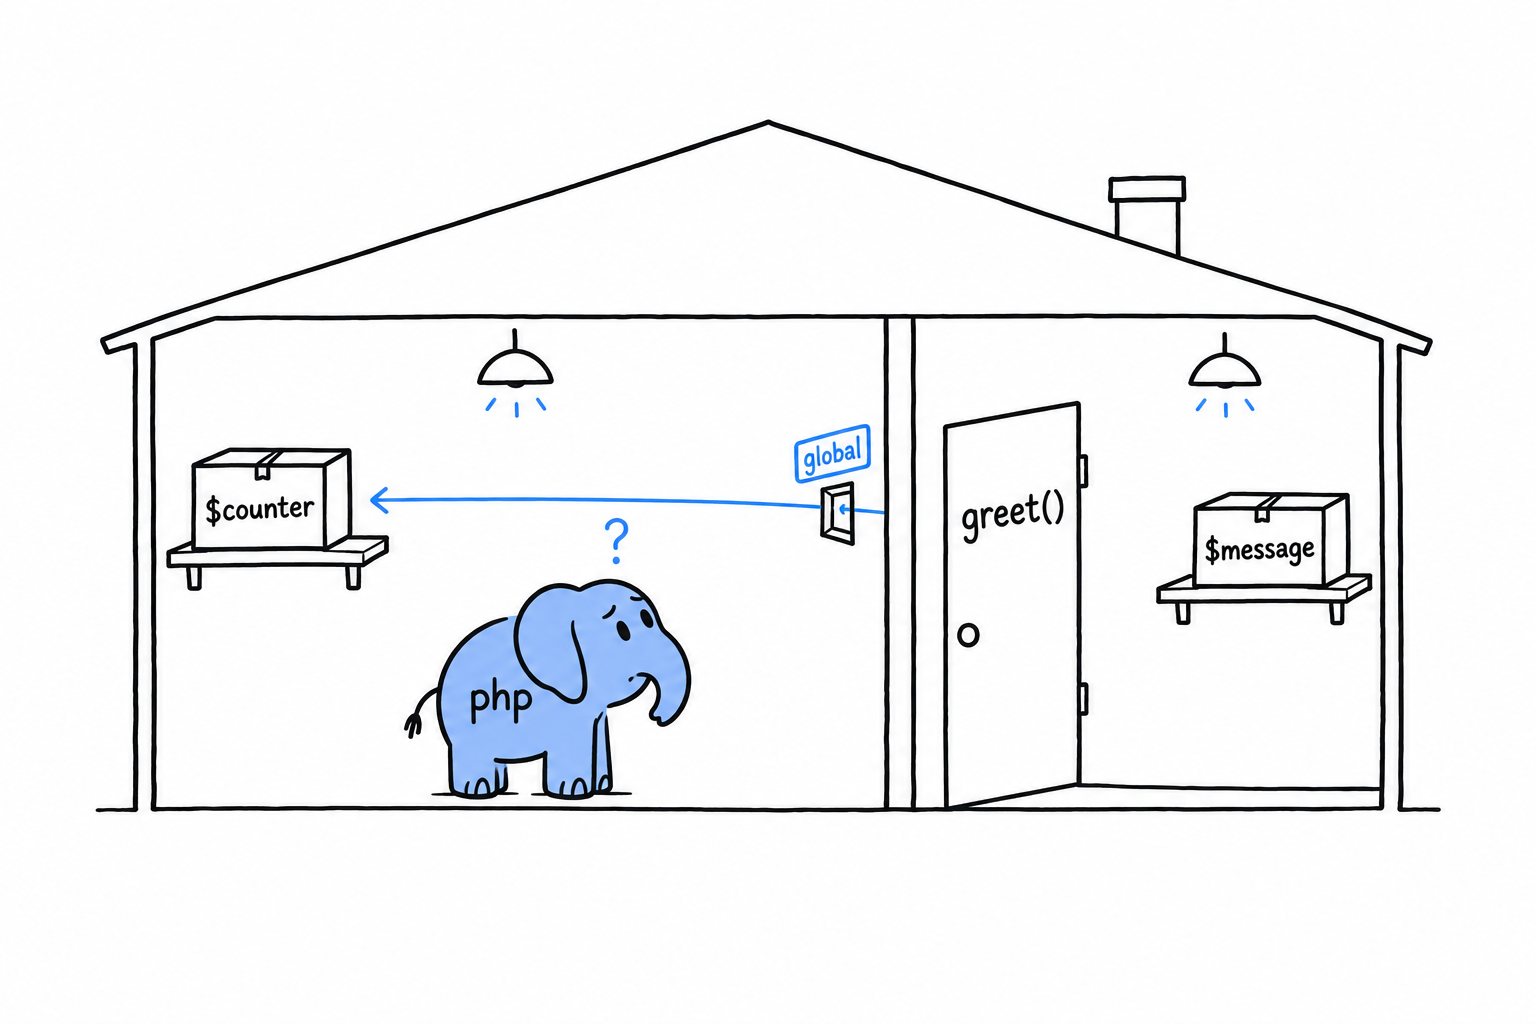
global, et pourquoi vous y toucherez rarement
PHP a bien un moyen de laisser une fonction lire et écrire une variable du script principal : le mot-clé global.
<?php
declare(strict_types=1);

$counter = 0;

function increment(): void
{
    global $counter;
    $counter++;
}

increment();
increment();
echo $counter; // 2
Ça marche. Ce n’est presque jamais le bon outil. Une fonction qui passe par global pour modifier un état qui vit hors de ses paramètres et de sa valeur de retour est une fonction que sa signature ne suffit pas à comprendre : il faut retrouver chaque global $counter du code pour savoir qui le modifie, et dans quel ordre. Invisible dans un exemple de cinq lignes, douloureux dans une application de cinq mille.
Préférez recevoir les valeurs en paramètres et rendre les résultats en valeur de retour, ou bien, à partir du chapitre 5, garder l’état partagé dans une propriété d’un objet que vous faites circuler volontairement. Si vous sentez l’attrait de global, c’est en général que la fonction réclame un paramètre.
Les variables static dans les fonctions
Il existe une façon plus sage, pour une fonction, de se souvenir de quelque chose d’un appel à l’autre. Une variable locale ordinaire naît et disparaît à chaque exécution de la fonction. Une variable locale static garde sa valeur d’un appel au suivant, et seule cette fonction peut la voir.
<?php
declare(strict_types=1);

function nextId(): int
{
    static $id = 0;
    $id++;
    return $id;
}

echo nextId(); // 1
echo nextId(); // 2
echo nextId(); // 3
$id = 0 ne s’exécute qu’au tout premier appel de nextId() ; chaque appel suivant reprend là où le précédent s’est arrêté. Rien en dehors de nextId() ne peut lire ni remettre $id à zéro. Aucune fuite à la global ici, juste une fonction dotée d’une mémoire privée. C’est un motif pratique pour un petit compteur, un cache simple ou un drapeau « ai-je déjà fait cette initialisation », quand un objet entier serait disproportionné pour un seul nombre.
Un mot bref et honnête sur le ramasse-miettes
Vous entendrez parler du « garbage collector » de PHP, en général à côté des mots « fuite mémoire » ou « script de longue durée ». Il est utile de savoir en gros de quoi il s’agit, même si vous y penserez rarement.
Chaque valeur que PHP crée, chaque tableau et chaque objet, porte un petit compteur : le nombre de variables qui pointent dessus en ce moment. Quand ce compteur tombe à zéro, PHP libère la mémoire immédiatement. La dernière variable est sortie de sa portée ou a été réaffectée, plus personne n’a besoin de la valeur, elle disparaît. Ce compteur est aussi ce qui fait fonctionner la copie à l’écriture, dans la première section de ce chapitre : PHP sait toujours combien d’endroits partagent un tableau donné.
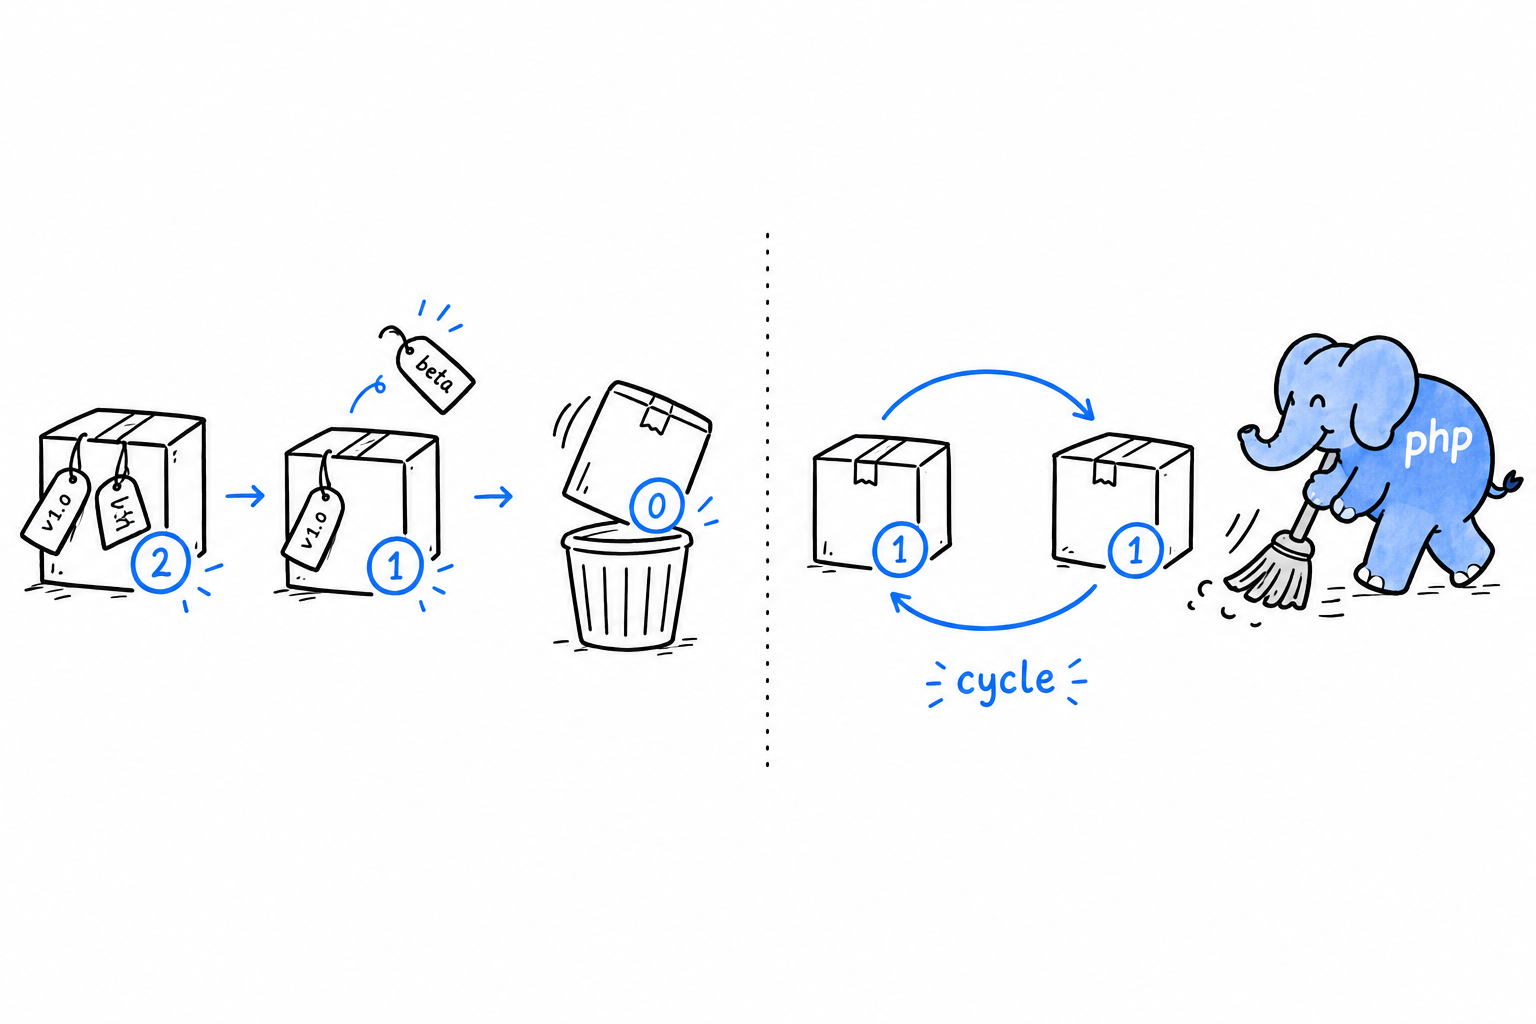
Le comptage a un angle mort. Deux objets qui pointent l’un vers l’autre forment un cycle, et un cycle peut être oublié par le reste du programme alors que ses deux membres se tiennent encore. Leurs compteurs n’atteignent jamais zéro. PHP lance de temps en temps un collecteur de cycles séparé, qui repère ces cycles orphelins et les nettoie quand même.
Vous ne gérez pas la mémoire en PHP. Pas de malloc, pas de free, aucune comptabilité de qui possède quoi. Les valeurs disparaissent quand plus rien n’en a besoin, et PHP détermine ce « plus rien » pour vous, cycles compris. Ce n’est pas un manque par rapport aux langages qui vous font penser à la mémoire ; c’est tout l’intérêt. Gardez le vocabulaire sous le coude pour le jour rare où vous traquerez une mémoire qui enfle dans un script de longue durée, et le reste du temps, laissez-le faire son travail.
Structurer des données avec des classes
Quelque part dans votre code, il y a un tableau $product. Ailleurs, une fonction calculateTotal($product). Les deux ne fonctionnent ensemble que tant qu’ils sont d’accord sur les clés que contient le tableau, et rien dans PHP ne vérifie qu’ils le sont.
Vous regroupez des valeurs liées dans des tableaux depuis le chapitre 3 : les articles d’un panier, des prix indexés par nom. Ça marche, jusqu’au jour où ça ne marche plus. Un tableau associatif n’a pas de forme fixe. Rien ne vous empêche de mal orthographier une clé, rien ne dit quelles clés sont censées exister, et rien ne rattache aux données les opérations que vous faites dessus.
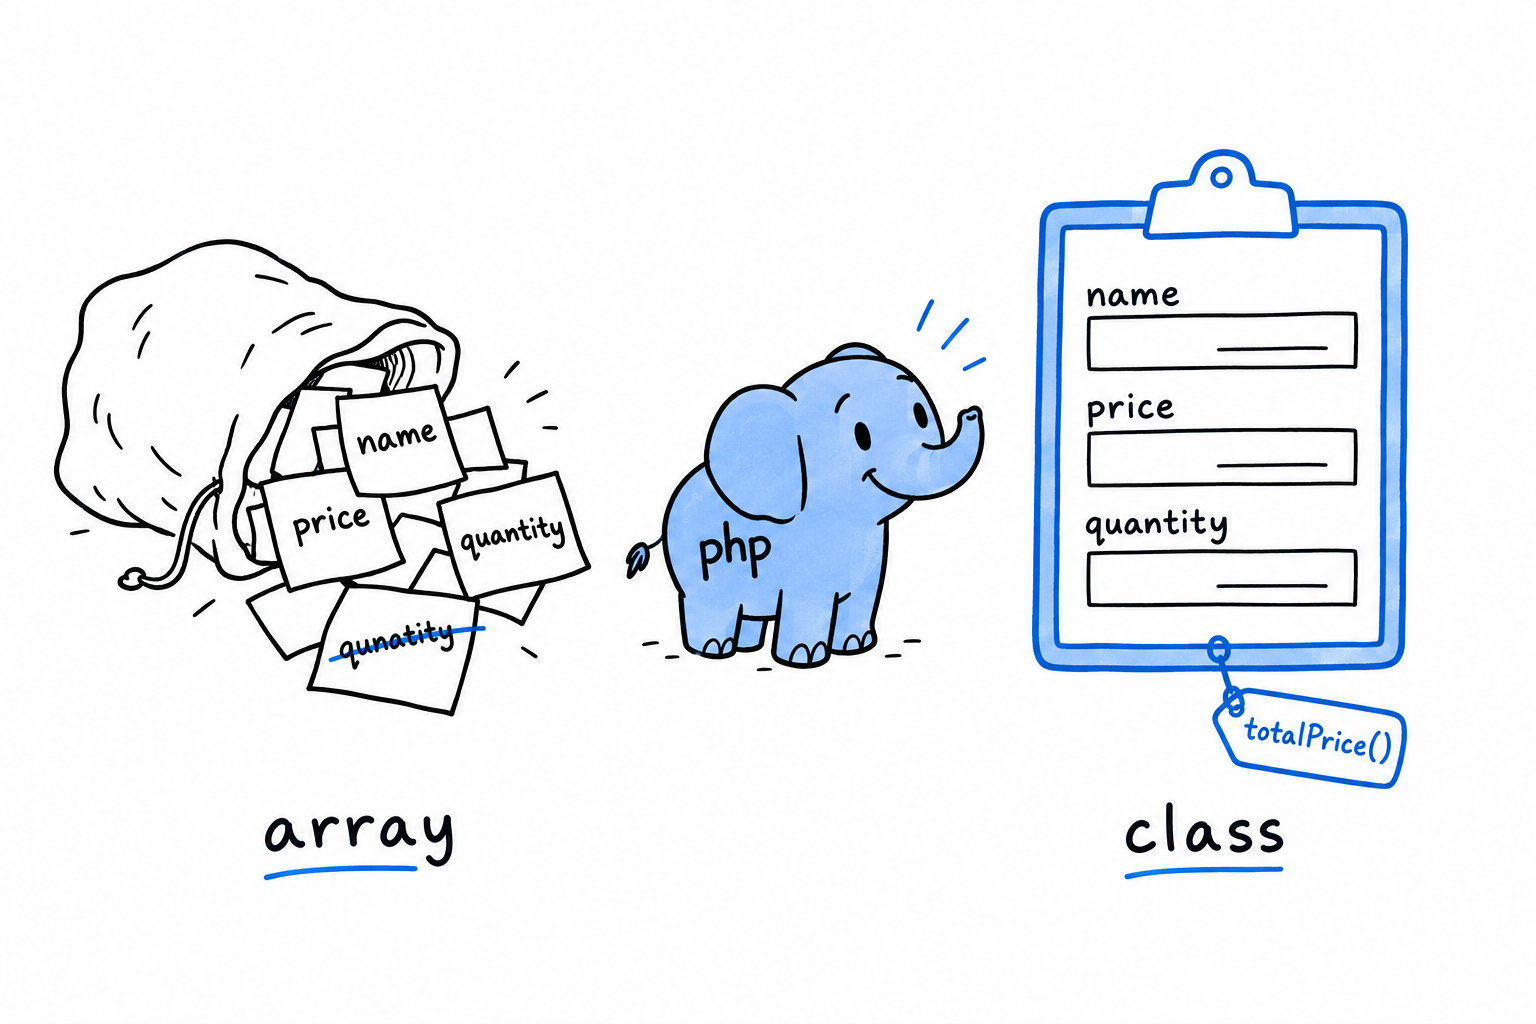
Une classe donne une forme à une donnée : des propriétés nommées et typées, qui existent toujours, avec les opérations qui ont un sens sur ces données rangées juste à côté, sous forme de méthodes. Pensez à la différence entre une pile de post-it et un formulaire imprimé. Le formulaire a des champs fixes, chaque exemplaire a les mêmes, et le mode d’emploi est imprimé sur le formulaire lui-même.
Vous avez déjà croisé les objets deux fois : en passant dans Types de données, puis plus sérieusement au chapitre 4, où vous avez appris la chose la plus importante à leur sujet. Contrairement aux tableaux, les objets ne sont pas copiés quand on les affecte ou qu’on les passe à une fonction : toute variable qui en tient un tient une poignée vers la même instance. À partir d’ici, les objets cessent d’être un décor d’arrière-plan. C’est vous qui les construisez.
La mécanique d’abord : le mot-clé class, les propriétés typées, la visibilité, et new, qui fait naître une instance. Puis un petit exemple, mené du début à la fin, comme une classe apparaît dans du vrai code : non pas parce qu’un livre vous l’a dit, mais parce que la version à base de tableaux du même problème était devenue une dette. Les méthodes ferment le chapitre, avec $this et le raccourci moderne de PHP pour les constructeurs, qui fait disparaître une quantité surprenante du code répétitif dont le vieux PHP est plein.
Un sac de tableaux tenus par une convention, ou une forme que le langage lui-même fait respecter. C’est le choix dont parle ce chapitre.
Définir et instancier une classe
Une classe est un plan. Elle dit quelles données un objet de ce type contient et, plus tard, ce qu’il sait faire. Un plan ne construit rien tout seul. C’est avec new que vous demandez à PHP de bâtir un objet à partir du plan.
Définir une classe
<?php
declare(strict_types=1);

class Rectangle
{
    public float $width;
    public float $height;
}
class Rectangle { ... } déclare le plan. À l’intérieur, public float $width; déclare une propriété typée : une case nommée que chaque Rectangle possédera, avec un type que PHP fait respecter à chaque affectation. C’est la même déclaration de type que vous posez sur les paramètres de fonction depuis le chapitre 3, appliquée à une donnée qui vit sur un objet plutôt que dans un appel de fonction.
Instancier une classe
new construit un vrai objet à partir du plan. Cet objet s’appelle une instance :
<?php

$rect = new Rectangle();
$rect->width = 10.0;
$rect->height = 4.0;

echo $rect->width;  // 10
echo $rect->height; // 4
new Rectangle() vous remet un Rectangle bien réel, avec ses propres $width et $height, et $rect le tient. La flèche -> entre dans un objet pour lire ou écrire l’une de ses propriétés. C’est l’équivalent, pour un objet, des crochets [] sur un tableau, sauf qu’un objet est beaucoup plus regardant sur ce qu’on y met, comme vous le verrez bientôt.
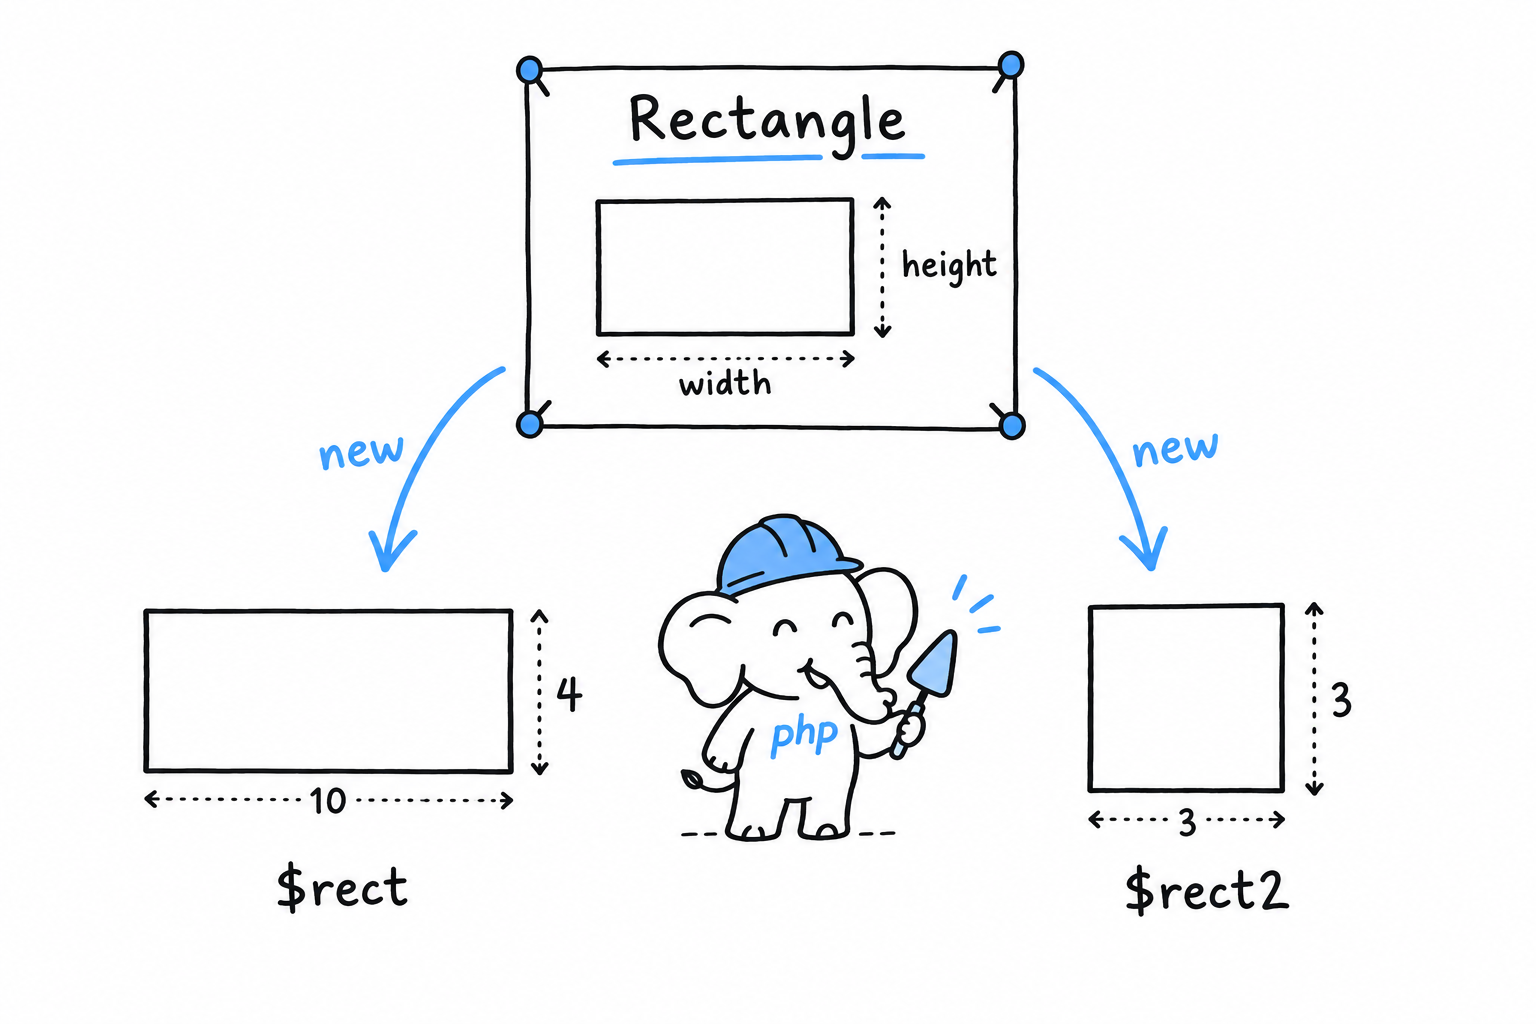
Construisez un second Rectangle, et vous obtenez un objet vraiment distinct, avec son propre espace :
<?php

$rect2 = new Rectangle();
$rect2->width = 3.0;
$rect2->height = 3.0;

echo $rect->width;  // 10, untouched by $rect2
echo $rect2->width; // 3
Un instant, parce que le chapitre 4 vous a peut-être rendu méfiant envers les objets qui partagent une poignée. $rect et $rect2 ne sont pas deux noms pour un même objet. Ils viennent de deux appels à new distincts, donc ce sont deux instances distinctes. La règle « les objets s’aliasent, ils ne se copient pas » concerne l’affectation d’un objet existant à une autre variable, $a = $b. Chaque new construit un objet neuf.
Un plan, autant d’objets que vous en demandez. Chaque
newen fait un nouveau.
Construire avec __construct
Remplir chaque propriété à la main après new fonctionne, mais on en oublie facilement une, et pendant un instant un Rectangle à moitié bâti existe, avec des propriétés encore vides. PHP a une méthode spéciale pour ça. __construct() s’exécute automatiquement à l’instant où l’objet est créé, si bien que l’objet est complet dès son premier souffle :
<?php
declare(strict_types=1);

class Rectangle
{
    public float $width;
    public float $height;

    public function __construct(float $width, float $height)
    {
        $this->width = $width;
        $this->height = $height;
    }
}

$rect = new Rectangle(10.0, 4.0);

echo $rect->width;  // 10
echo $rect->height; // 4
Tout ce que vous passez à new Rectangle(...) file directement à __construct(). À l’intérieur, $this est l’objet en cours de construction : $this->width = $width prend le paramètre reçu et le range dans la case $width de l’objet. $this aura droit à un examen plus attentif, avec une façon bien plus courte d’écrire exactement ce constructeur, dans Méthodes et promotion des propriétés.
Visibilité : public, private, protected
Chaque propriété et chaque méthode a une visibilité, et jusqu’ici tout était public : accessible de partout, y compris depuis du code qui n’a rien à voir avec la classe. C’est souvent plus que vous ne voulez. Marquez une propriété private, et seul le code à l’intérieur de la classe peut y toucher :
<?php
declare(strict_types=1);

class Rectangle
{
    private float $width;
    private float $height;

    public function __construct(float $width, float $height)
    {
        $this->width = $width;
        $this->height = $height;
    }
}

$rect = new Rectangle(10.0, 4.0);
echo $rect->width; // Error: Cannot access private property Rectangle::$width
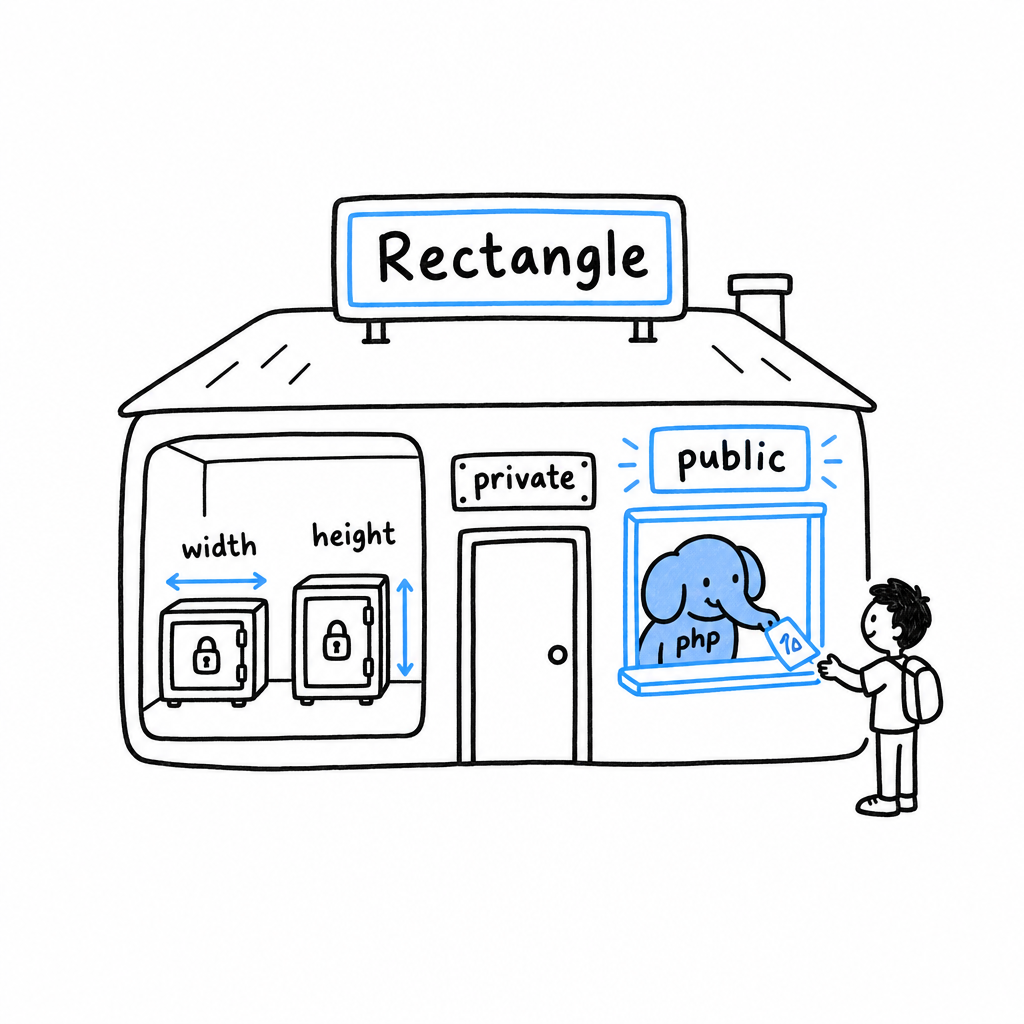
C’est une restriction voulue, pas un bug à contourner. Une fois $width privée, le seul moyen pour l’extérieur d’en connaître ou d’en changer la valeur passe par les méthodes que Rectangle choisit d’offrir. C’est donc Rectangle qui décide de ce qu’est une largeur valide, au lieu de faire confiance à tous ses appelants. Essayez : ajoutez public function width(): float { return $this->width; } à la classe et appelez $rect->width(). La valeur redevient lisible, aux conditions de la classe.
protected se place entre les deux : invisible de l’extérieur, visible depuis toute classe qui viendra plus tard étendre celle-ci. La distinction prendra son sens avec l’héritage, au chapitre 17.
Tip
Partez sur
private. Ne passez une propriété enpublicque pour une raison précise, et offrez une méthode au code extérieur quand il a vraiment besoin d’y accéder.
Un programme d’exemple avec des classes
Le meilleur moyen de voir ce qu’une classe apporte, c’est d’écrire deux fois le même petit problème, une fois avec un tableau, une fois avec une classe, et de regarder où la première version casse.
Le problème, avec un tableau
Vous démarrez une boutique. Chaque produit a un nom, un prix et une quantité dans le panier, et il vous faut le total de la ligne. La version à base de tableau a l’air parfaitement raisonnable :
<?php
declare(strict_types=1);

function lineTotal(array $product): float
{
    return $product['price'] * $product['quantity'];
}

$item = [
    'name' => 'Coffee mug',
    'price' => 8.50,
    'quantity' => 3,
];

echo lineTotal($item); // 25.5
Ça marche, jusqu’au jour où ça ne marche plus. Rien n’empêche une faute de frappe :
<?php

$item = [
    'name' => 'Coffee mug',
    'prise' => 8.50, // typo, silently different key
    'quantity' => 3,
];

echo lineTotal($item); // Warning: Undefined array key "price"
L’avertissement se déclenche au fond de lineTotal(), loin de l’endroit où l’erreur a été commise. Rien dans $item ne disait quelles clés il devait contenir, et rien n’a vérifié que price était un nombre avant l’instant de la multiplication. Laissez la boutique grandir (remises, taux de TVA, niveaux de stock) et chaque fonction qui touche un tableau produit doit s’accorder, de son côté, sur les mêmes clés magiques. Chacune est à une faute de frappe d’échouer à l’exécution, loin du vrai bug.
Le même problème, avec une classe
<?php
declare(strict_types=1);

class Product
{
    public string $name;
    public float $price;
    public int $quantity;

    public function __construct(string $name, float $price, int $quantity)
    {
        $this->name = $name;
        $this->price = $price;
        $this->quantity = $quantity;
    }

    public function totalPrice(): float
    {
        return $this->price * $this->quantity;
    }
}
Product nomme sa forme une fois, à un seul endroit. Il ne reste rien à mal orthographier : new Product(...) exige exactement un nom, un prix et une quantité, dans cet ordre, chacun avec un type déclaré. Trompez-vous de type et, avec strict_types activé, PHP vous arrête sur-le-champ au lieu de laisser une chaîne se faire passer pour un prix :
<?php

$mug = new Product('Coffee mug', 8.50, 3);

echo $mug->totalPrice(); // 25.5
Essayez : passez '3', entre guillemets, comme quantité, dans un fichier où strict_types est activé. PHP refuse avec une TypeError avant même que l’objet existe.
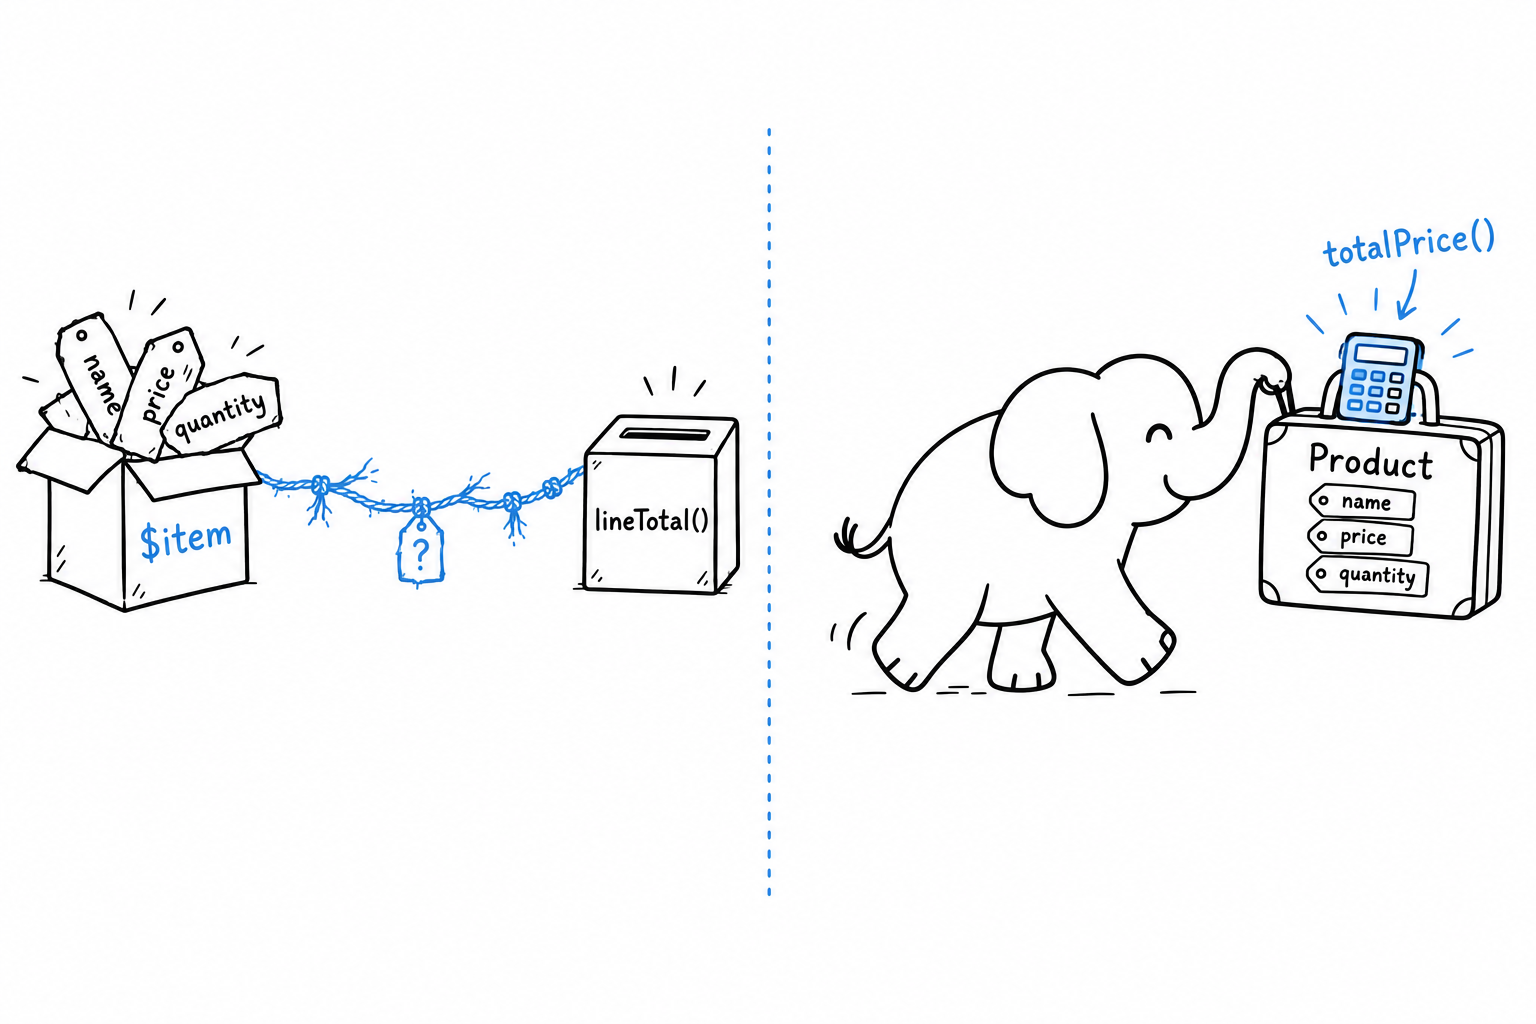
totalPrice() vit maintenant sur Product, et non dans une fonction isolée à qui il faut expliquer la forme de son argument. Quiconque tient un Product, n’importe où dans le code, peut appeler $product->totalPrice() et obtenir la bonne réponse, parce que la logique voyage avec les données sur lesquelles elle travaille.
L’utiliser dans un petit programme
Un panier minuscule, fait de quelques objets Product :
<?php
declare(strict_types=1);

$cart = [
    new Product('Coffee mug', 8.50, 3),
    new Product('Notebook', 4.25, 2),
    new Product('Pen', 1.10, 5),
];

$total = 0.0;

foreach ($cart as $product) {
    echo "{$product->name}: \${$product->totalPrice()}\n";
    $total += $product->totalPrice();
}

echo "Total: \${$total}\n";
$ php cart.php
Coffee mug: $25.5
Notebook: $8.5
Pen: $5.5
Total: $39.5
Regardez $cart : c’est toujours un tableau ordinaire. Les classes ne remplacent pas les tableaux. Elles remplacent ce que vous seriez sinon forcé d’y entasser. Ici, le tableau fait ce pour quoi il est bon, tenir une liste ordonnée de choses, et chaque chose est un Product qui connaît sa propre forme et sa propre arithmétique.
Des tableaux pour les collections, des classes pour ce qu’elles collectionnent. Vous utiliserez ce duo jusqu’à la fin du livre.
Méthodes et promotion des propriétés
Une méthode est une fonction qui vit à l’intérieur d’une classe. Vous en avez déjà écrit une, totalPrice() sur Product. Ce qui la distingue d’une fonction ordinaire tient dans une seule variable, $this, et une fois ce point clair, la façon la plus courte d’écrire un constructeur en PHP n’est plus qu’à un pas.
$this
Dans une méthode, $this est l’objet sur lequel la méthode a été appelée. C’est par lui qu’une méthode atteint les données de cette instance précise, et non d’une autre instance de la même classe :
<?php
declare(strict_types=1);

class Product
{
    public string $name;
    public float $price;
    public int $quantity;

    public function __construct(string $name, float $price, int $quantity)
    {
        $this->name = $name;
        $this->price = $price;
        $this->quantity = $quantity;
    }

    public function totalPrice(): float
    {
        return $this->price * $this->quantity;
    }

    public function applyDiscount(float $percentage): void
    {
        $this->price -= $this->price * ($percentage / 100);
    }
}

$mug = new Product('Coffee mug', 8.50, 3);
$mug->applyDiscount(10);

echo $mug->price; // 7.65
applyDiscount() ne prend pas le produit en paramètre. Elle n’en a pas besoin : $this est déjà le produit sur lequel on l’a appelée. Appelez $mug->applyDiscount(10), et dans la méthode, $this est $mug. Appelez la même méthode sur un autre Product, et $this est celui-là.
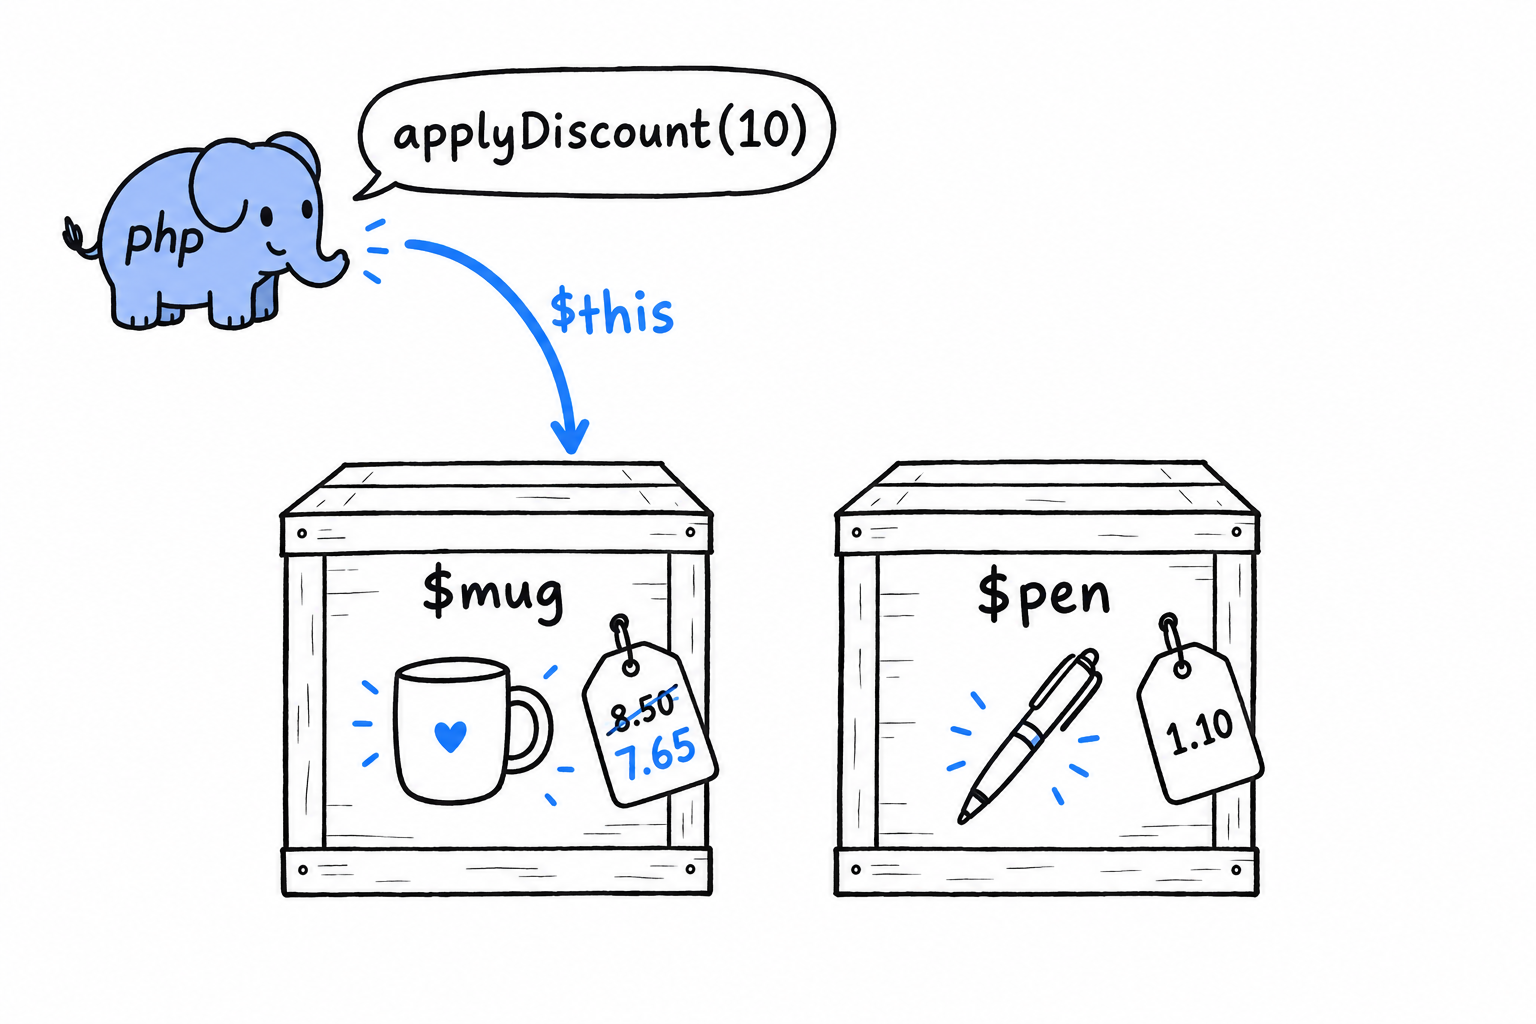
$this est implicite, et toujours disponible dans toute méthode non statique. C’est lui qui garde les méthodes d’un objet en phase avec les données de ce même objet, sans que vous ayez à passer l’objet à chacune de ses propres méthodes.
Appelez une méthode sur un objet, et
$thisest cet objet. Rien à passer, rien à déclarer.
Essayez : créez un second produit, $pen = new Product('Pen', 1.10, 5);, appelez $mug->applyDiscount(10), puis affichez $pen->price. Le stylo n’a pas bougé. La remise n’a atteint que l’objet vers lequel $this pointait.
Le constructeur, version longue
Regardez à nouveau le constructeur de Product. Trois paramètres en entrée, trois affectations en face, une ligne chacune, aucune logique au-delà de « range ça là où ça va ». Ce motif est si courant en PHP, et si répétitif, qu’il a gagné son propre raccourci.
La promotion des propriétés
Depuis PHP 8, ajouter un mot-clé de visibilité à un paramètre du constructeur déclare la propriété et l’affecte d’un seul geste :
<?php
declare(strict_types=1);

class Product
{
    public function __construct(
        public string $name,
        public float $price,
        public int $quantity,
    ) {
    }

    public function totalPrice(): float
    {
        return $this->price * $this->quantity;
    }
}

$mug = new Product('Coffee mug', 8.50, 3);
echo $mug->totalPrice(); // 25.5
Mettez cette version à côté de celle du début de la section. Vues de l’extérieur, les deux classes sont identiques : mêmes propriétés, mêmes types, même signature de constructeur. À l’intérieur, la version promue n’a plus de déclarations de propriétés séparées, plus de $this->name = $name; répété trois fois, et un corps de constructeur vide. Écrire public string $name en paramètre fait trois choses à la fois : déclarer la propriété, la typer, et y ranger l’argument reçu.
C’est la façon idiomatique et moderne d’écrire un constructeur dont le seul travail est « garde ce qu’on m’a donné », et cela décrit une bonne part des constructeurs que vous écrirez en PHP. Vous le verrez partout à partir de maintenant.
Les propriétés readonly, en bref
Un mot-clé de plus, parce qu’il va si naturellement avec la promotion. Marquez une propriété promue readonly, et elle ne peut être affectée qu’une fois, à la construction, et plus jamais ensuite :
<?php
declare(strict_types=1);

class Product
{
    public function __construct(
        public readonly string $name,
        public float $price,
        public int $quantity,
    ) {
    }
}

$mug = new Product('Coffee mug', 8.50, 3);
$mug->name = 'Travel mug'; // Error: Cannot modify readonly property Product::$name
Un prix et une quantité sont faits pour changer ; c’est tout l’intérêt de applyDiscount(). Le nom d’un produit, lui, a rarement une bonne raison de bouger. readonly vous permet de le dire dans la définition même de la classe, et PHP le fait respecter, au lieu que la règle vive dans un commentaire ou une convention que quelqu’un finira par oublier. Il reviendra plus loin dans le livre, quand les enums et les objets-valeurs entreront en scène.
Énumérations et filtrage par motif
Une commande est en attente, expédiée ou annulée. Jamais autre chose. Une carte à jouer appartient à l’une des quatre couleurs, point. Un feu tricolore est rouge, orange ou vert. Les programmes regorgent de valeurs de ce genre, et PHP a longtemps manqué d’un moyen propre de le dire.
Avant PHP 8.1, on prenait une chaîne de caractères, 'shipped', ou une constante entière, et on croisait les doigts. Rien n’empêchait un collègue d’écrire 'shiped' quelque part. Rien ne disait, à un endroit unique, quelle était la liste complète des valeurs permises. La règle vivait dans votre tête, et les têtes oublient.
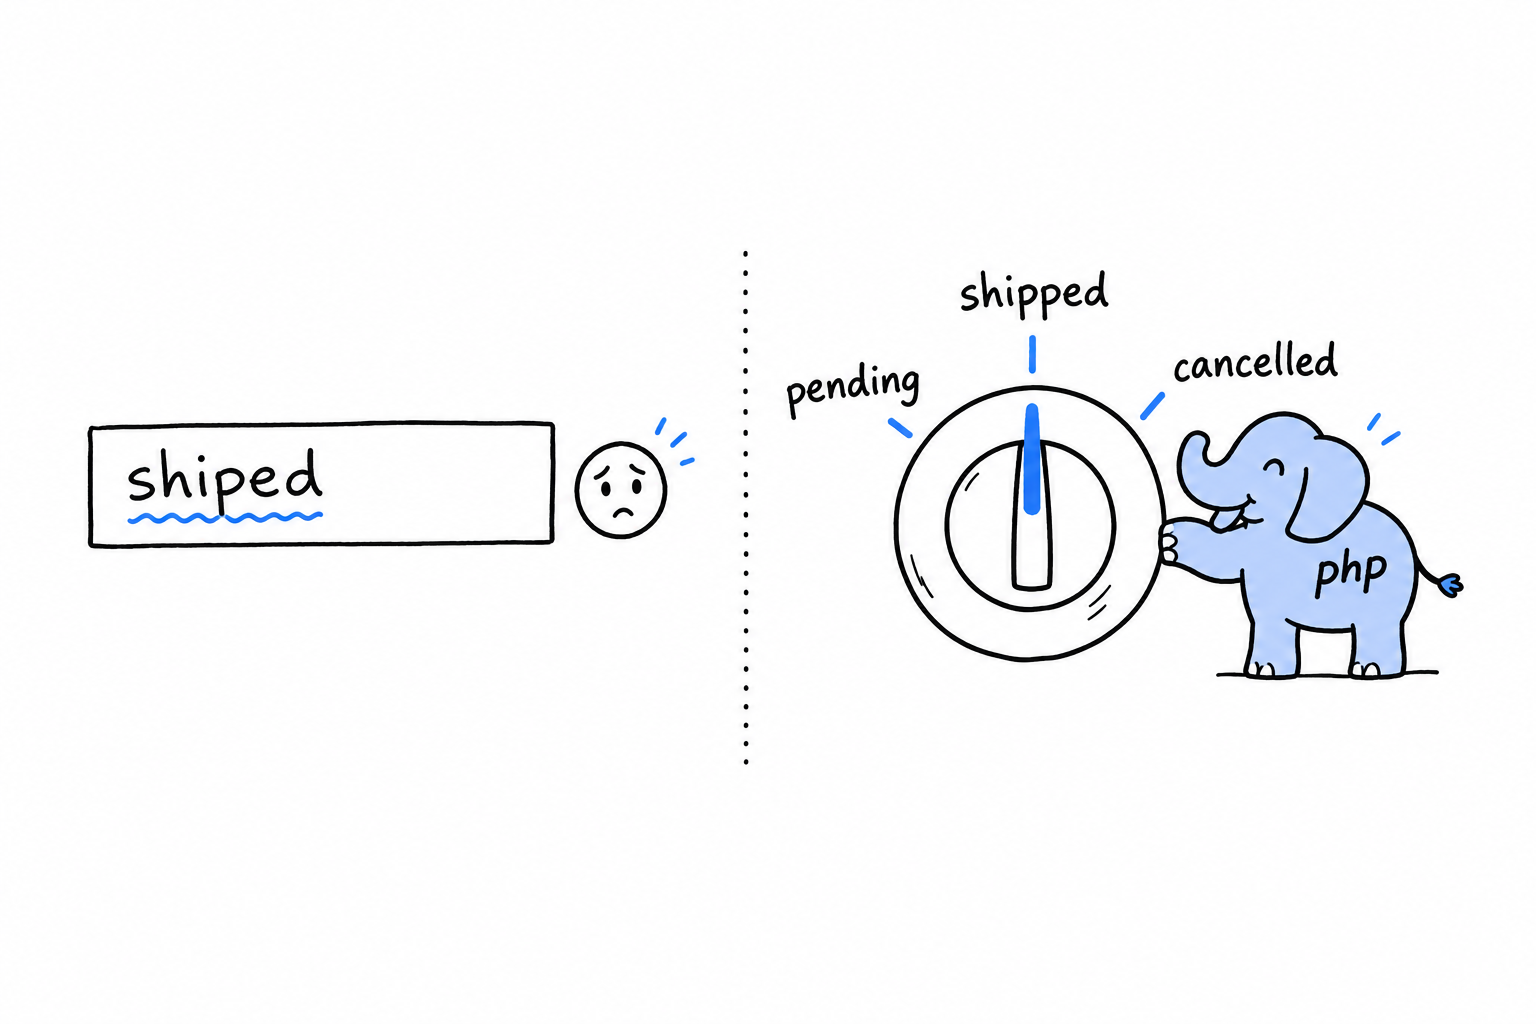
Une énumération transforme cette liste en un vrai type, vérifié par le moteur, qui ne peut contenir qu’un des cas que vous avez déclarés. C’est la différence entre un champ de texte où chacun tape ce qu’il veut et un bouton à trois positions gravées dans le métal.
Vous avez croisé match au passage au chapitre 3, pour jauger un code de statut HTTP, et les classes donnent forme à vos données depuis le chapitre 5. Les énumérations se logent exactement entre les deux : elles ressemblent à une petite classe, et match a été conçu pour les lire. Le chapitre se termine sur l’opérateur nullsafe, ?->, un cousin de la même famille. Il traite un ensemble d’exactement deux possibilités, quelque chose ou rien, sans un if défensif devant chaque accès.
Définir une énumération
Énumérations pures
Quatre couleurs, ni plus ni moins. Les voici sous forme d’énumération :
<?php
declare(strict_types=1);

enum Suit
{
    case Hearts;
    case Diamonds;
    case Clubs;
    case Spades;
}

$card = Suit::Hearts;

var_dump($card);          // enum(Suit::Hearts)
var_dump($card === Suit::Hearts); // true
enum ouvre la définition comme class le ferait, et chaque ligne case déclare une des valeurs permises. Une énumération est un type doté d’une liste fermée de valeurs, et ces valeurs s’appellent des cas. Suit::Hearts s’écrit comme une constante de classe : on atteint un cas par le nom de l’énumération.
La ligne var_dump montre quelque chose qu’une chaîne ne vous a jamais dit. Suit::Hearts est une valeur unique. Il n’en existe qu’une dans tout votre programme, quel que soit le nombre de variables qui pointent dessus, et c’est pourquoi le === de la ligne suivante répond true sans hésiter.
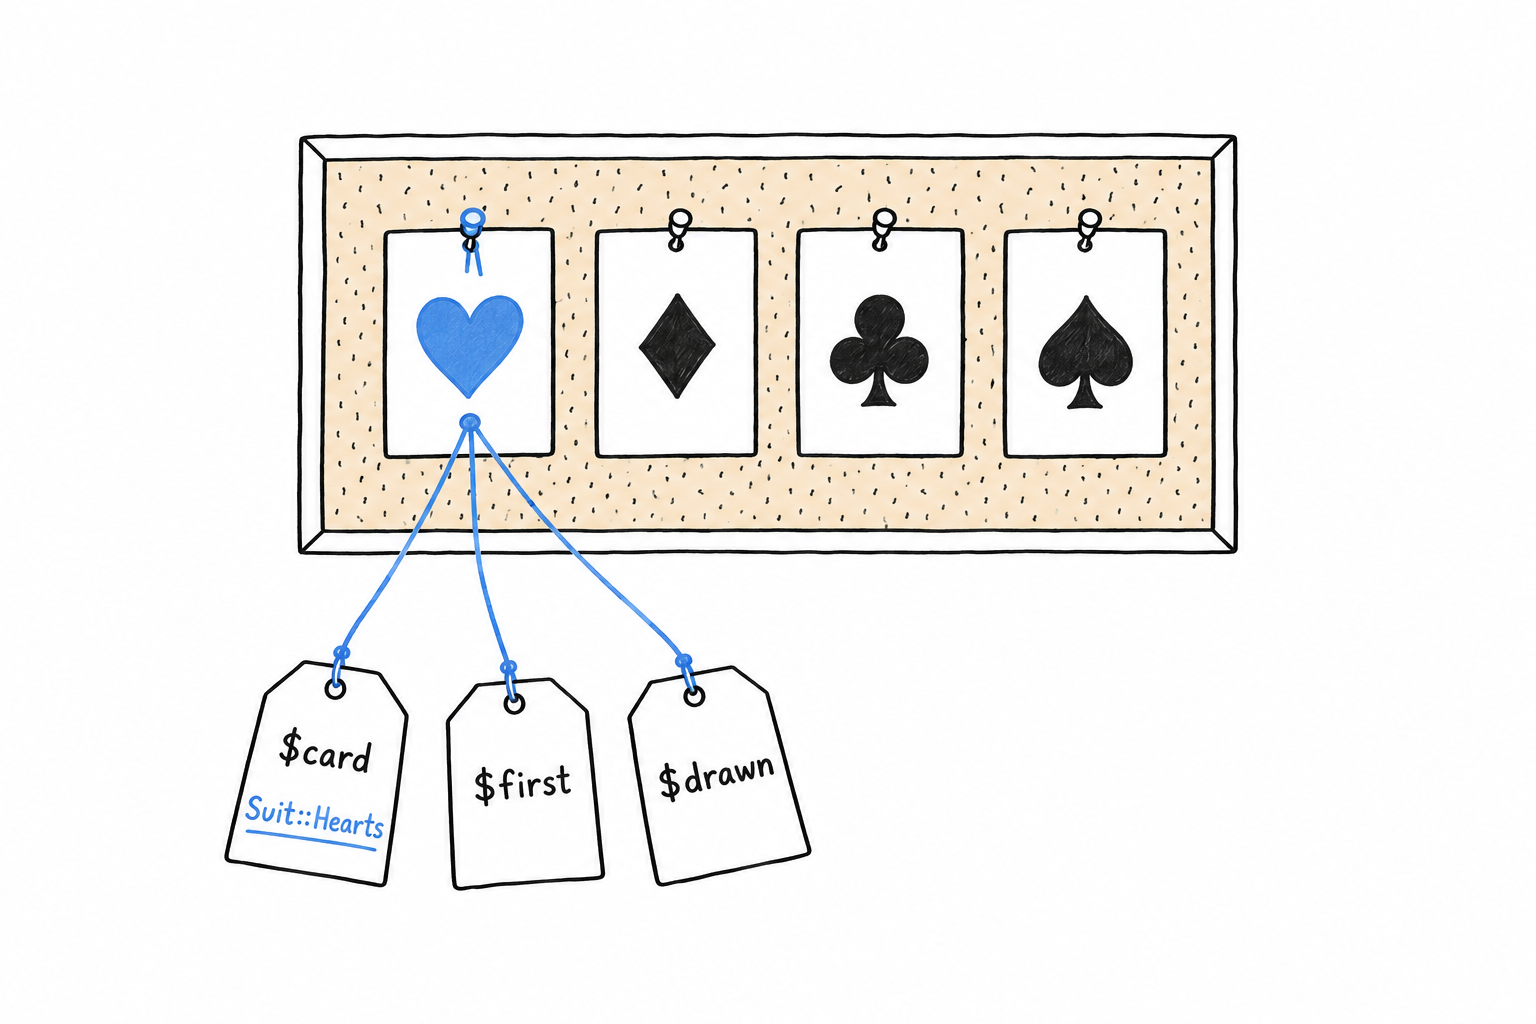
Cette unicité fait la sûreté du type. Un paramètre typé Suit ne peut rien contenir d’autre qu’un des quatre cas, et PHP arrête une valeur erronée au niveau du type, plutôt qu’avec un rapport de bogue trois semaines plus tard.
<?php
declare(strict_types=1);

function describe(Suit $suit): string
{
    return "You drew a {$suit->name}.";
}

echo describe(Suit::Spades); // You drew a Spades.
Chaque cas porte une propriété intégrée ->name : l’identifiant sous lequel vous l’avez déclaré, sous forme de chaîne. Pratique pour un journal, mais ce n’est qu’une étiquette. Y bâtir de la logique reviendrait à bâtir sur l’orthographe de votre propre code.
Essayez : appelez describe('Spades') avec une simple chaîne, et lisez la TypeError. Ce message, c’est l’énumération qui fait son travail.
Énumérations adossées
Les cas d’une énumération pure ne sont rien d’autre qu’eux-mêmes : Suit::Hearts n’est pas secrètement une chaîne ou un nombre. Puis une commande doit être enregistrée dans une colonne de base de données, ou envoyée en JSON à un autre programme, et le monde extérieur ignore ce qu’est Status::Shipped. Il connaît 'shipped'. Une énumération adossée attache à chaque cas une valeur scalaire de votre choix, une forme capable de quitter votre programme et d’y revenir.
<?php
declare(strict_types=1);

enum Status: string
{
    case Pending = 'pending';
    case Shipped = 'shipped';
    case Cancelled = 'cancelled';
}

$status = Status::Shipped;

echo $status->value; // shipped
: string après le nom déclare l’énumération adossée à des chaînes, et dès lors chaque cas doit annoncer sa valeur : PHP le vérifie en lisant la définition. Les entiers marchent de la même façon (enum Status: int). Les chaînes restent le choix habituel, parce que 'shipped' se comprend tout seul dans une ligne de base de données, là où un 2 nu vous renvoie à l’énumération pour savoir ce qu’il signifie.
Dans l’autre sens, d’une valeur brute vers un cas, il existe deux méthodes :
<?php

$status = Status::from('shipped');   // Status::Shipped
echo $status->name;                  // Shipped

$status = Status::tryFrom('bogus');  // null, no matching case
var_dump($status);
from() convertit une valeur en cas correspondant et lève une ValueError si rien ne correspond. tryFrom() renvoie null à la place. Choisir entre les deux, c’est se demander d’où vient la valeur. Si une valeur inconnue ne peut être qu’un bogue dans votre propre code, utilisez from() et laissez-la échouer bruyamment. Si elle arrive d’une saisie utilisateur ou d’une API externe, « statut invalide » est une issue normale, et tryFrom() vous la remet sous la forme d’un null à gérer.
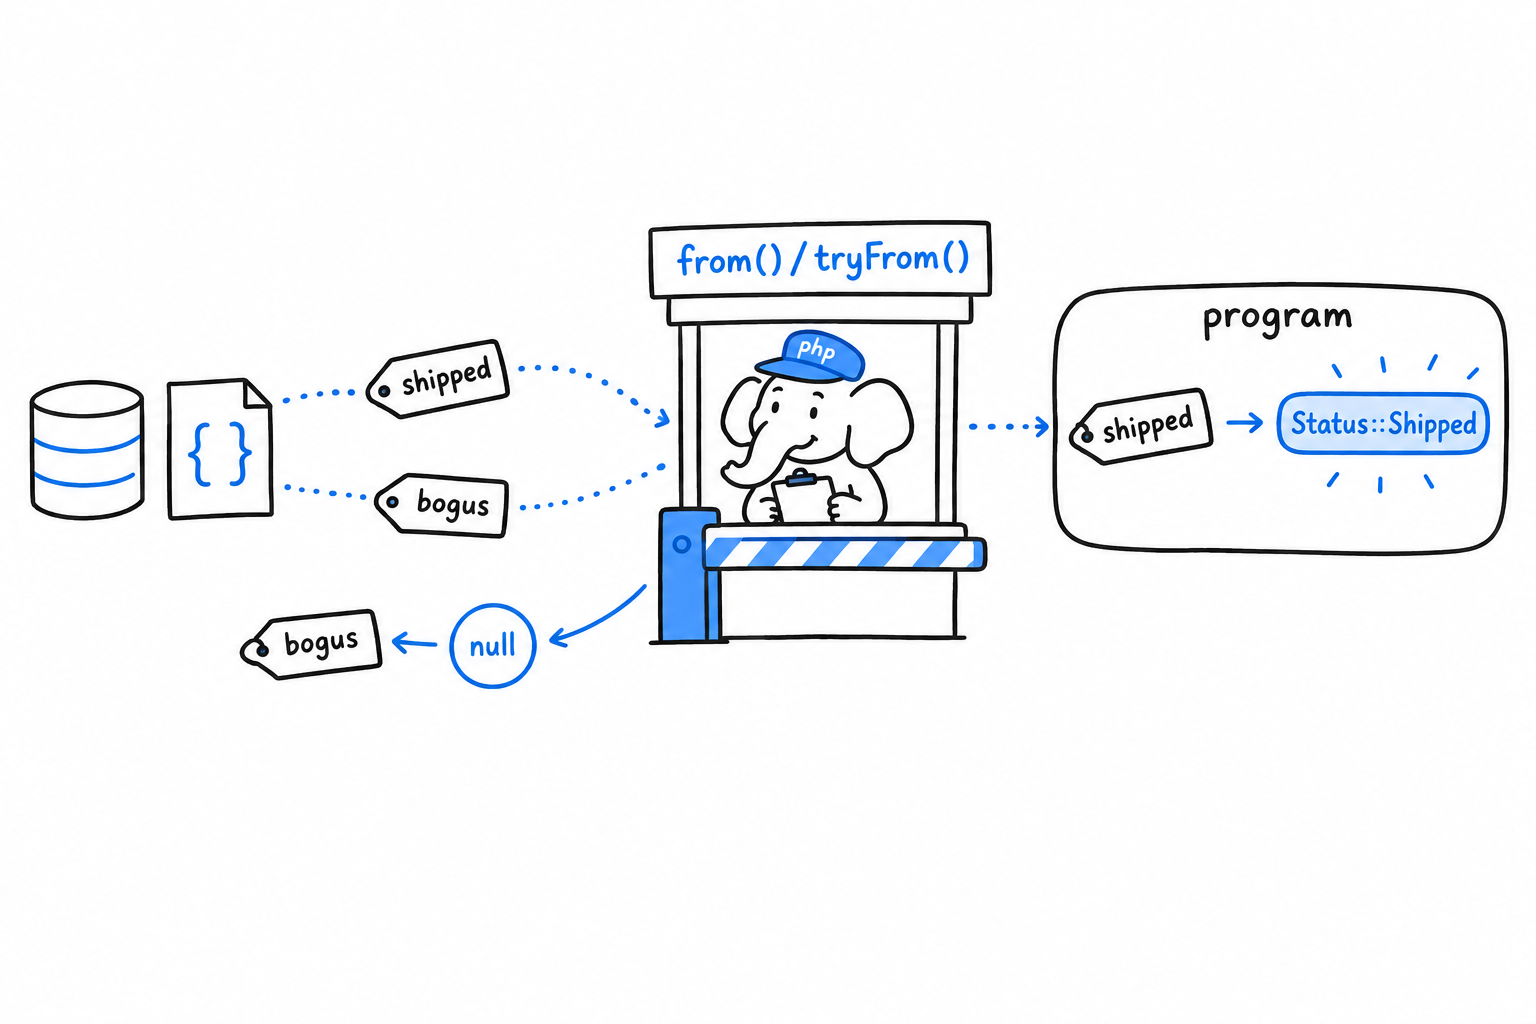
from()lève une exception sur une valeur inconnue.tryFrom()renvoienull. Choisissez en vous demandant qui a produit la valeur.
Une énumération peut avoir des méthodes
Une énumération n’est pas qu’une liste de noms. Elle peut porter du comportement, exactement comme une classe :
<?php
declare(strict_types=1);

enum Status: string
{
    case Pending = 'pending';
    case Shipped = 'shipped';
    case Cancelled = 'cancelled';

    public function label(): string
    {
        return match ($this) {
            Status::Pending => 'Awaiting shipment',
            Status::Shipped => 'On its way',
            Status::Cancelled => 'Order cancelled',
        };
    }
}

echo Status::Shipped->label(); // On its way
label() fonctionne comme n’importe quelle méthode du chapitre 5 : à l’intérieur, $this désigne le cas sur lequel la méthode a été appelée. La correspondance entre un cas et son libellé lisible vit désormais à un seul endroit, juste à côté des cas eux-mêmes, au lieu d’être éparpillée dans le code sous forme de tests if ($status === 'shipped') qui finissent par diverger.
Le match à l’intérieur de label() compare $this à chaque cas et renvoie le texte inscrit à côté de celui qui convient. C’est match dans son meilleur rôle, et la section suivante le démonte pièce par pièce.
L’expression match
match a fait une courte apparition au chapitre 3 sous la forme match(true), testant une condition après l’autre sur un code de statut HTTP. Une astuce utile, mais pas match à son meilleur. match brille quand une valeur est comparée à un petit ensemble connu de possibilités, et une énumération est précisément cet ensemble.
Comparer directement à un cas de l’énumération
<?php
declare(strict_types=1);

enum Status: string
{
    case Pending = 'pending';
    case Shipped = 'shipped';
    case Cancelled = 'cancelled';
}

function nextAction(Status $status): string
{
    return match ($status) {
        Status::Pending => 'Pack the order',
        Status::Shipped => 'Notify the customer',
        Status::Cancelled => 'Issue a refund',
    };
}

echo nextAction(Status::Pending); // Pack the order
Pas de true, pas d’opérateur de comparaison, pas de test d’intervalle. match ($status) compare la valeur entre parenthèses à chaque branche avec une comparaison stricte ===, et renvoie ce qui se trouve à droite de la flèche sur la première branche qui convient. Lue de haut en bas, la fonction est une table : une ligne par cas, une réponse par ligne.
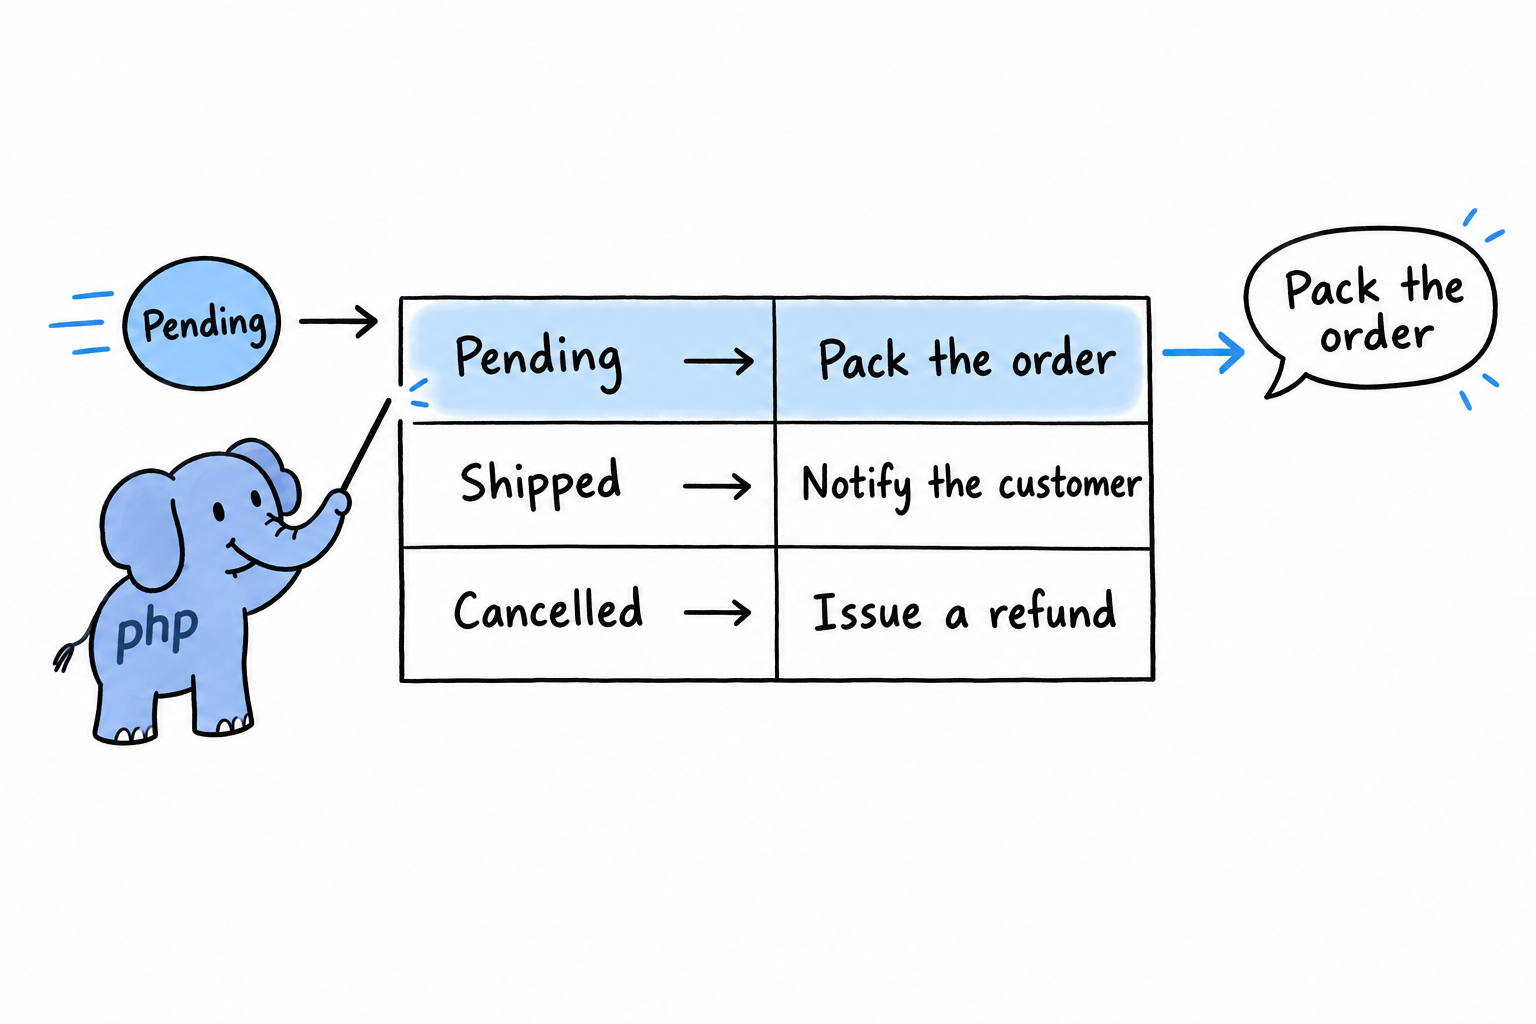
Remarquez le return devant match. match est une expression : il produit une valeur que vous pouvez renvoyer ou ranger dans une variable, là où switch et if se contentent d’exécuter du code. C’est pour cela que le corps entier de la fonction tient en une seule instruction.
Plusieurs conditions par branche
Une branche peut lister plusieurs valeurs, séparées par des virgules, et une seule suffit :
<?php
declare(strict_types=1);

function isFinal(Status $status): bool
{
    return match ($status) {
        Status::Shipped, Status::Cancelled => true,
        Status::Pending => false,
    };
}

var_dump(isFinal(Status::Shipped));   // true
var_dump(isFinal(Status::Cancelled)); // true
var_dump(isFinal(Status::Pending));   // false
Status::Shipped, Status::Cancelled => true se lit « l’un ou l’autre, même réponse ». C’est mieux que d’écrire la branche deux fois, et mieux qu’un || glissé dans un match(true).
L’exhaustivité est imposée
Voici ce qui fait de match plus qu’un switch mieux rangé. Chaque valeur possible doit être traitée, nommément ou par une branche default. Si aucune ne convient, match lève une exception. Supposons que la boutique se mette à accepter les retours :
<?php
declare(strict_types=1);

enum Status: string
{
    case Pending = 'pending';
    case Shipped = 'shipped';
    case Cancelled = 'cancelled';
    case Returned = 'returned'; // added later
}

function nextAction(Status $status): string
{
    return match ($status) {
        Status::Pending => 'Pack the order',
        Status::Shipped => 'Notify the customer',
        Status::Cancelled => 'Issue a refund',
        // forgot to add a Returned arm
    };
}

nextAction(Status::Returned); // UnhandledMatchError: Unhandled match case Status::Returned
L’énumération a grandi, le match non, et la première fois qu’une commande retournée atteint nextAction(), PHP lève une UnhandledMatchError sur cette ligne précise.
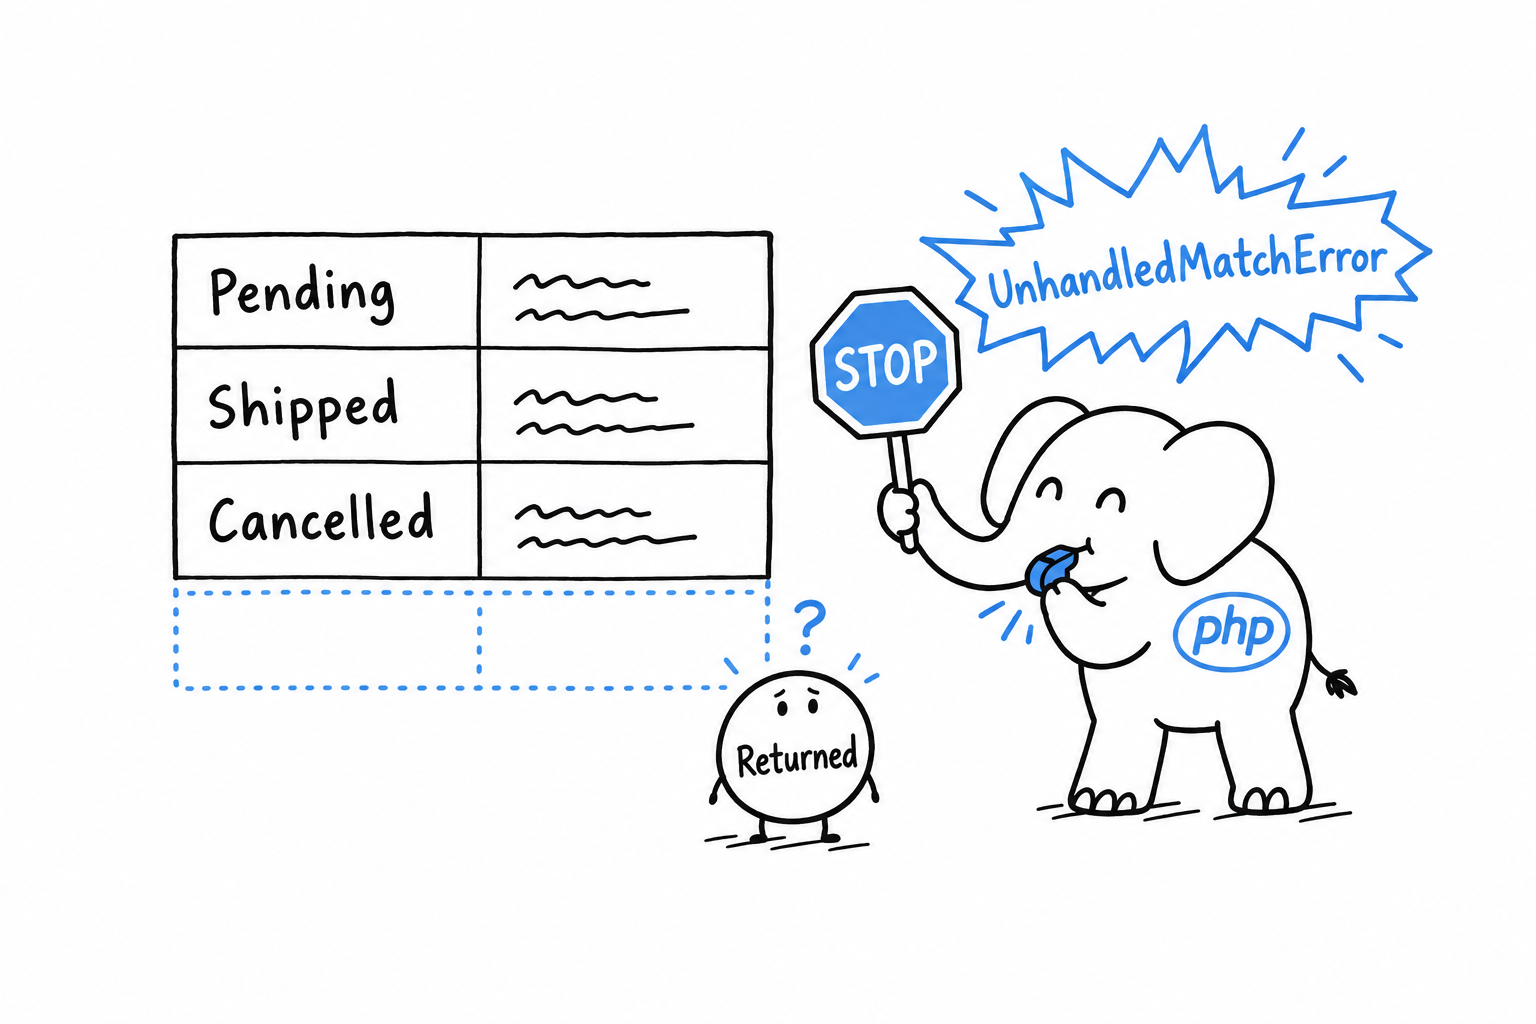
Cela paraît sévère, et c’est justement l’intérêt. Ajoutez un cas à une énumération dans six mois, oubliez l’une des expressions match qui la lisent, et PHP nomme l’endroit à corriger. Un switch sans branche correspondante ne fait rien et continue. Une chaîne de if exécute tranquillement son else pour une valeur que personne n’avait prévue. Un match refuse.
Essayez : ajoutez une branche Status::Returned => 'Restock the item' et relancez le fichier.
Quand la plupart des cas partagent vraiment un même comportement de repli, ajoutez une branche default, comme switch en a toujours eu. Elle récupère tout ce qui n’est pas nommé au-dessus, et dit au lecteur que vous avez choisi de traiter le reste de la même façon, plutôt qu’oublié.
Un
matchsansdefaultest une promesse de traiter chaque cas. PHP vous tient à cette promesse.
Un flux de contrôle concis avec match et ?->
Certaines valeurs n’ont pas trois ou quatre cas possibles. Elles en ont deux : quelque chose, ou rien du tout. C’est le dernier ensemble fermé de ce chapitre, et il mérite une syntaxe à lui.
L’opérateur nullsafe
null signifie « aucune valeur ici », comme le disait le chapitre 3, et -> va chercher une propriété ou une méthode dans un objet, comme au chapitre 5. Assemblez les deux et vous obtenez une question que tout programme finit par se poser : que se passe-t-il quand on utilise -> sur quelque chose qui pourrait être null ?
<?php
declare(strict_types=1);

class Address
{
    public function __construct(
        public string $city,
    ) {
    }
}

class Customer
{
    public function __construct(
        public string $name,
        public ?Address $address = null,
    ) {
    }
}

$customer = new Customer('Ada');

echo $customer->address->city; // Error: Attempt to read property "city" on null
Ada n’a pas d’adresse enregistrée, donc $customer->address vaut null, et aller un cran plus loin avec ->city échoue sur place : il n’y a aucune propriété à lire sur rien. La parade classique est une garde avant l’accès :
<?php

$city = null;
if ($customer->address !== null) {
    $city = $customer->address->city;
}

echo $city ?? 'No address on file';
Ça fonctionne, et ça ne passe pas à l’échelle. Ajoutez quelques niveaux, $order->customer->address->city par exemple, et il faut soit imbriquer une garde par maillon, soit écrire une longue condition qui vérifie trois choses à la fois sans en nommer aucune.
L’opérateur nullsafe, ?->, fait la garde à votre place :
<?php
declare(strict_types=1);

$city = $customer->address?->city;

echo $city ?? 'No address on file';
?-> regarde ce qui se trouve à sa gauche avant d’aller plus loin. Si c’est null, l’expression entière devient null à cet instant, sans erreur ni exception, prête pour ?? ou pour ce que vous faites d’habitude d’une valeur absente. Si ce n’est pas null, ?-> se comporte exactement comme ->. Dans une chaîne plus longue, $order?->customer?->address?->city s’arrête au premier null rencontré et donne null pour toute l’expression, sans tenter les accès suivants.
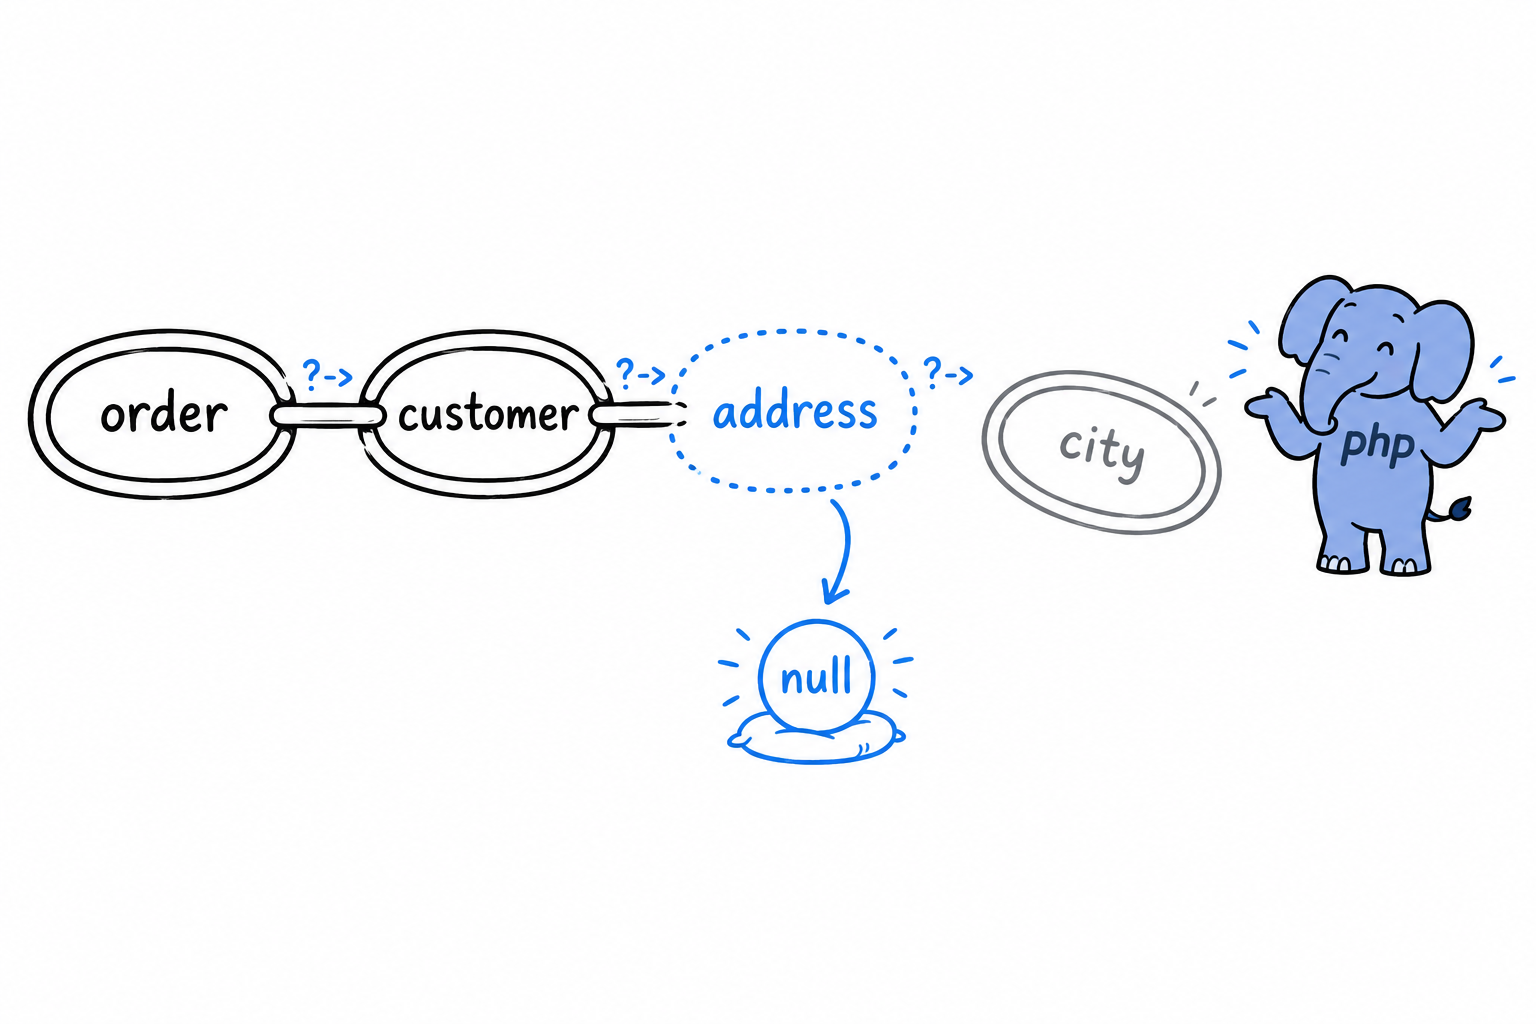
?->s’arrête au premiernullet le rend. Tout ce qui suit est ignoré.
Warning
?->est fait pour les valeurs qui ont le droit d’être absentes : une adresse facultative, un enregistrement lié qui n’existe pas encore. Ce n’est pas un moyen d’éviter de décider sinulla sa place à cet endroit. Semé partout par réflexe, il masque une conception qui n’a jamais tranché ce qui est facultatif. Là où l’absence n’est pas normale, gardez le->ordinaire et laissez l’erreur vous prévenir.
match, l’alternative propre à une longue chaîne de if/elseif
Les énumérations sont le terrain où match est le plus à son avantage, mais il n’en a pas besoin. match est la réponse de PHP à toute chaîne de if/elseif qui compare une valeur à plusieurs possibilités connues. Voici une chaîne de ce genre :
<?php
declare(strict_types=1);

function shippingCost(string $countryCode): float
{
    if ($countryCode === 'US') {
        return 5.00;
    } elseif ($countryCode === 'CA') {
        return 7.50;
    } elseif ($countryCode === 'FR' || $countryCode === 'DE') {
        return 9.00;
    } else {
        return 15.00;
    }
}
La même fonction en match :
<?php
declare(strict_types=1);

function shippingCost(string $countryCode): float
{
    return match ($countryCode) {
        'US' => 5.00,
        'CA' => 7.50,
        'FR', 'DE' => 9.00,
        default => 15.00,
    };
}
Plus court, oui. Surtout, chaque branche est visiblement une alternative aux autres, d’un coup d’œil, là où la version à elseif doit être lue dans l’ordre pour s’assurer que rien ne se glisse entre deux étapes.
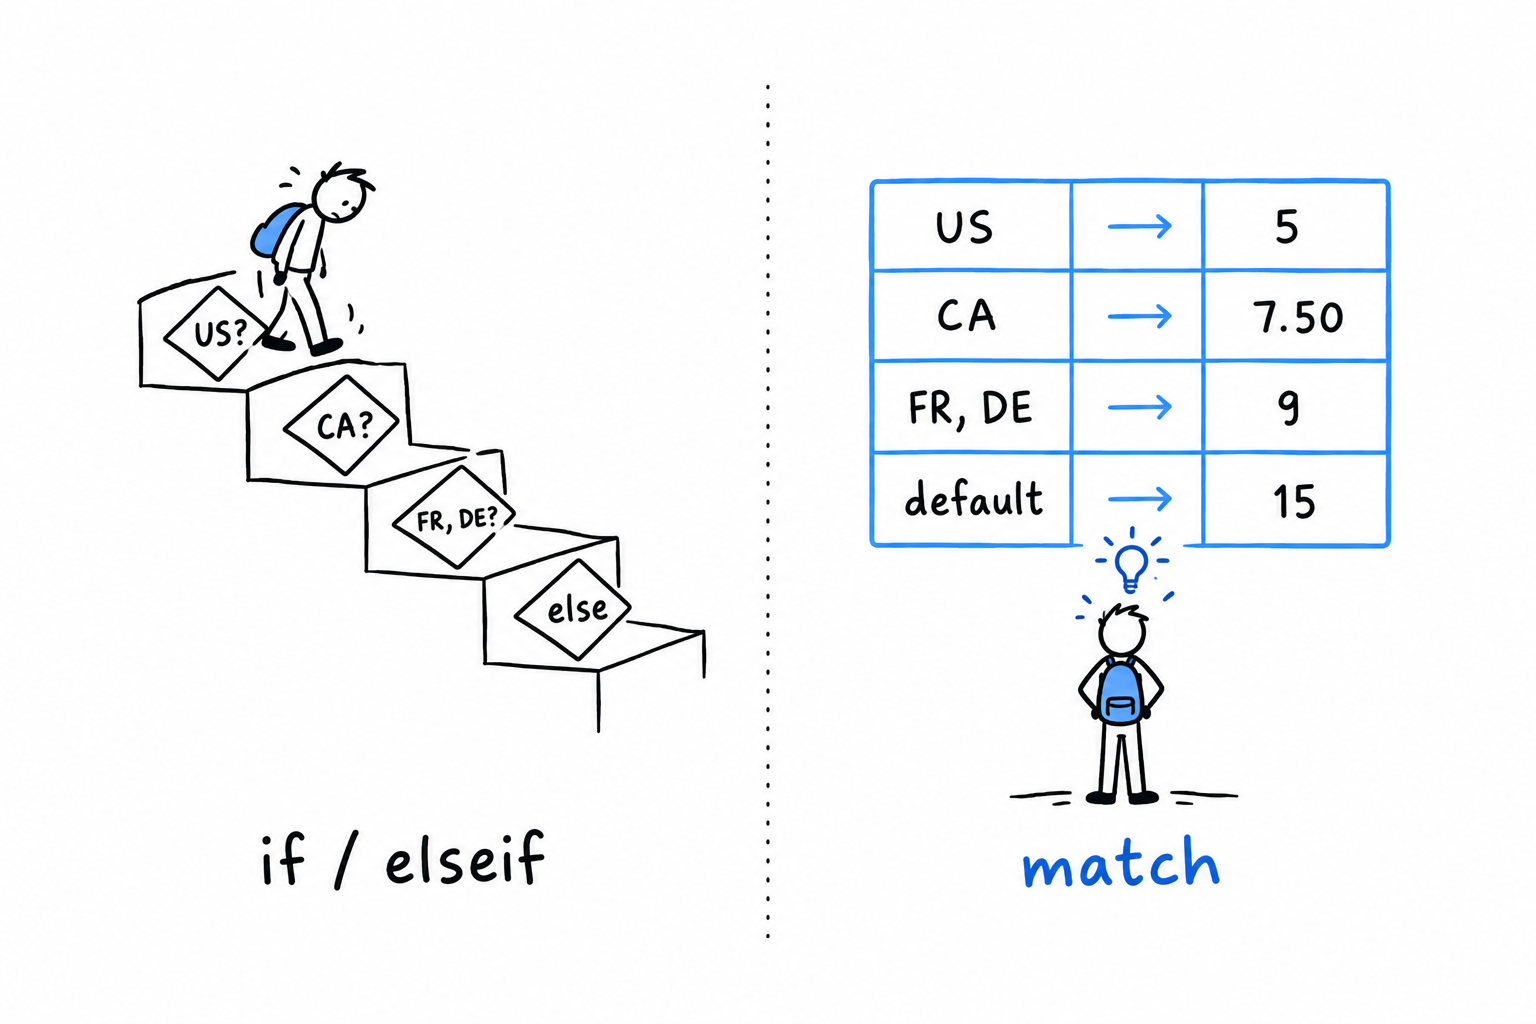
Vous tenez là une règle à garder pour toute la suite du livre. Prenez if/elseif quand les conditions sont réellement des vérifications de nature différente : un intervalle ici, une combinaison de deux drapeaux là. Prenez match dès que vous remarquez que la question est « laquelle de ces valeurs connues est-ce ? ». Les énumérations rendent cette question évidente. Elle se pose partout ailleurs aussi.
Espaces de noms, paquets et Composer
Jusqu’ici, chaque exemple tenait dans un fichier. C’est fini. Depuis le chapitre 5 et le chapitre 6, vous avez des classes et des énumérations, et un projet qui en compte une dizaine n’a rien à faire dans un script unique. Il vous faut répartir le code entre plusieurs fichiers, et faire en sorte que ces fichiers ne se marchent pas dessus.
Le piège, c’est le nommage. Le jour où vous installez un paquet avec Composer, le gestionnaire de paquets de PHP, vous partagez votre projet avec du code que vous n’avez pas écrit et que vous ne pouvez pas renommer. Si ce paquet définit une classe Product et que vous en avez une aussi, PHP n’a aucun moyen de les distinguer. Un espace de noms est un préfixe devant un nom, et c’est ce préfixe qui empêche App\Models\Product et Vendor\Package\Product de se télescoper. Deux noms différents, rien à deviner.
Composer vient en premier, parce que c’est lui qui justifie tout le reste. Vous donnez ensuite un espace de noms à vos propres classes, vous les importez avec use pour continuer à écrire des noms courts, et vous rangez le tout dans un dossier src/ qui reflète ces espaces de noms, comme dans les vrais projets PHP. PSR-4 noue le tout : une convention qui permet à Composer de retrouver n’importe quelle classe à partir de son seul nom.
Cette dernière pièce est la récompense. La ligne require 'vendor/autoload.php' trouve et charge déjà chaque paquet que vous installez. À la fin du chapitre, elle trouvera aussi vos propres classes. Vous ajoutez un fichier, vous utilisez la classe, et elle est là, tout simplement. Aucune liste de require à entretenir en tête de chaque fichier.
Hello, Composer!
hello.php n’a aucune dépendance, il n’a donc besoin de personne pour les gérer. Les vrais projets, si, et presque dès le premier jour : une bibliothèque de tests par ici, un client HTTP par là. Composer est le moyen, pour un projet PHP, de récupérer le code de quelqu’un d’autre sans le copier-coller dans le sien. Si vous avez déjà utilisé npm, pip ou cargo, vous connaissez le métier. Sinon, vous le connaîtrez à la fin de cette page.
Installer Composer
Sur macOS ou Linux, le plus rapide passe généralement par votre gestionnaire de paquets :
$ brew install composer
Partout ailleurs, ou pour la méthode officielle, la page de téléchargement propose un court script d’installation. Dans les deux cas, vérifiez qu’il répond :
$ composer --version
Composer version 2.7.6 2024-...
Démarrer un projet
Dans un répertoire vide, lancez :
$ composer init
Composer pose une poignée de questions : nom du paquet, description, auteur, licence. Appuyez sur Entrée à peu près partout, rien de tout cela n’est définitif. Ce qui compte, c’est le fichier qu’il laisse derrière lui, composer.json :
{
    "name": "you/hello-composer",
    "require": {}
}
composer.json est la liste de courses de votre projet. Elle nomme ce dont le projet a besoin, et elle va dans le gestionnaire de versions. Ce que Composer rapporte du magasin, lui, n’y va pas, comme vous allez le voir.
Installer un premier paquet
Ajoutons quelque chose de réel. nunomaduro/termwind est une petite bibliothèque pour mettre en forme la sortie du terminal. Rien d’indispensable, juste de quoi voir le mécanisme fonctionner :
$ composer require nunomaduro/termwind
Deux choses apparaissent. Un répertoire vendor/ contient le code téléchargé. Un fichier composer.lock note la version exacte qui a été installée, jusqu’au dernier commit, pour que vos collègues et votre serveur de production installent très précisément la même chose. composer.json dit ce que vous acceptez ; composer.lock dit ce que vous avez réellement obtenu. Versionnez aussi le fichier lock. vendor/ reste hors du gestionnaire de versions, puisque n’importe qui peut le reconstruire à partir du lock avec composer install.
Utilisons-le maintenant :
<?php

require 'vendor/autoload.php';

use function Termwind\render;

render('<div class="p-1 bg-green-400">Hello, Composer!</div>');
Lancez le fichier. Une bannière verte s’affiche dans votre terminal, dessinée par du code installé il y a trente secondes et que vous n’avez jamais lu.
La ligne du milieu est celle qui compte. require 'vendor/autoload.php' inclut un fichier généré par Composer : un autoloader, un bout de PHP qui sait trouver et charger n’importe quelle classe de n’importe quel paquet installé, à l’instant où votre code la mentionne pour la première fois. Incluez ce fichier, une fois, en tête de votre point d’entrée, et chaque paquet que vous ajouterez ensuite fonctionnera sans rien de plus. La ligne use function, qui vous permet d’appeler render() par son nom court, aura droit à sa propre explication plus loin dans ce chapitre.
Pour l’instant, l’autoloader n’a eu qu’un seul travail : charger Termwind. La suite du chapitre lui en confie un second. La même ligne, inchangée, trouvera aussi vos propres classes, une fois qu’elles seront réparties dans des fichiers comme les projets PHP s’y attendent.
Paquets et chargement automatique
composer require dépose un paquet dans vendor/, et require 'vendor/autoload.php' rend disponible chaque classe qu’il contient. Vous l’avez vu fonctionner. Ce que vous n’avez pas encore vu, c’est comment cette seconde moitié fonctionne, et la réponse explique pourquoi le reste de ce chapitre existe.
Le problème que résout l’autoloading
Imaginez PHP sans lui. Une classe Cart dans un fichier, une classe Product dans un autre, et un script qui a besoin des deux :
<?php

require 'Product.php';
require 'Cart.php';

$product = new Product('Keyboard', 49.00);
$cart = new Cart();
$cart->add($product);
Deux classes, deux lignes require, synchronisées à la main. Gérable. Imaginez maintenant quarante classes réparties dans une douzaine de paquets que vous n’avez pas écrits, chacune dépendant des autres dans un ordre qu’il vous faudrait reconstituer vous-même. Charger les fichiers à la main ne tient pas au-delà d’une poignée de classes, et tout casse le jour où vous en renommez une. Plus personne ne fait ça.
spl_autoload_register()
PHP a un crochet intégré pour exactement ce cas. spl_autoload_register() confie à PHP une fonction à appeler la première fois qu’il rencontre un nom de classe qu’il ne connaît pas. Au lieu d’échouer sur-le-champ, PHP laisse à votre fonction une chance d’aller chercher le fichier et de le charger :
<?php

spl_autoload_register(function (string $className): void {
    $file = __DIR__ . '/' . $className . '.php';

    if (file_exists($file)) {
        require $file;
    }
});

$cart = new Cart(); // Cart.php is loaded automatically, on first use
new Cart() s’exécute, PHP n’a jamais entendu parler de Cart, il appelle donc votre fonction avec la chaîne 'Cart'. La fonction construit un chemin, trouve Cart.php et l’inclut. La classe existe désormais, et new se poursuit comme si de rien n’était. Essayez : placez une classe Cart dans un fichier Cart.php à côté de ce script, lancez-le, puis renommez le fichier et relancez.
Beaucoup de projets ont écrit leur propre version de ce mécanisme avant que Composer n’existe. Ça marche, jusqu’au jour où un paquet dont vous dépendez livre son propre autoloader maison avec des règles légèrement différentes, et vous revoilà à tout coordonner à la main.
Ce que Composer génère réellement
Chaque composer install ou composer require régénère les fichiers de vendor/composer/. L’un d’eux, autoload_psr4.php, est un simple tableau PHP qui associe des préfixes d’espaces de noms à des répertoires. vendor/autoload.php construit un seul autoloader à partir de cette table et l’enregistre avec spl_autoload_register(). Dès lors, chaque classe de chaque paquet installé se résout toute seule.
Ça fonctionne parce que les paquets ne déversent pas leurs fichiers dans un tas commun. Chaque paquet déclare, dans son propre composer.json, quel préfixe d’espace de noms vit dans quel répertoire. Voici à quoi ressemble cette déclaration (vous écrirez la vôtre dans la section PSR-4) :
{
    "autoload": {
        "psr-4": {
            "App\\": "src/"
        }
    }
}
Un espace de noms est une promesse sur l’emplacement du fichier. PSR-4 est la règle qui transforme la promesse en chemin. L’autoloader de Composer ne fait qu’appliquer la règle, vite.
Pourquoi il faut des espaces de noms
Tout le système repose sur une condition : les noms de classes doivent rester uniques dans l’ensemble des paquets installés dans votre projet. Un Product venu de votre code et un Product venu d’un paquet de commerce en ligne seraient indiscernables. PHP ne saurait pas quel Product.php charger, et vous non plus, en relisant le code dans six mois.
Les espaces de noms suppriment la collision en faisant de Product le raccourci de quelque chose de plus précis : App\Models\Product d’un côté, Vendor\Ecommerce\Product de l’autre. Deux noms, deux fichiers, rien à deviner. C’est la section suivante.
Portée et visibilité avec les espaces de noms
Un espace de noms est un préfixe. C’est tout le concept, et il vaut mieux le dire avant que la syntaxe ne le fasse paraître plus gros qu’il n’est. App\Models\Product, c’est le nom Product, qui vit dans App\Models, exactement comme /home/damien/notes.txt est le fichier notes.txt, qui vit dans /home/damien. La classe elle-même ne change pas. Ce qui change, c’est la façon dont vous, et PHP, la désignez sans ambiguïté.
Déclarer un espace de noms
La ligne namespace est la première instruction du fichier. Seuls un commentaire ou un declare(strict_types=1) peuvent la précéder :
<?php

declare(strict_types=1);

namespace App\Models;

class Product
{
    public function __construct(
        public readonly string $name,
        public readonly float $price,
    ) {
    }
}
Tout ce que déclare ce fichier vit désormais sous App\Models : la classe Product, et toute classe, interface ou fonction que vous ajouterez dessous. Son nom complet est App\Models\Product. Dans ce fichier, et dans tout autre fichier qui s’ouvre lui aussi par namespace App\Models;, le simple Product continue de fonctionner, parce que PHP résout d’abord un nom nu par rapport à l’espace de noms courant.
Pourquoi s’embêter
Voici la situation pour laquelle les espaces de noms ont été conçus. Votre projet utilise une bibliothèque qui livre une classe Collection ; beaucoup le font, c’est le nom naturel pour « un ensemble de choses avec quelques méthodes utilitaires ». Vous voulez aussi votre propre Collection, pour une application de philatélie, disons. Sans espaces de noms, PHP tomberait sur deux classes qui se disputent le même nom et refuserait de charger la seconde. Une erreur fatale, et pas des plus discrètes.
Avec les espaces de noms, il n’y a pas de dispute :
<?php

namespace App\Models;

class Collection
{
    // your Collection, entirely unrelated to anyone else's
}
<?php

// Illuminate\Support\Collection, from a package you installed
namespace Illuminate\Support;

class Collection
{
    // their Collection
}
Même nom court, deux classes différentes, aucune collision : App\Models\Collection et Illuminate\Support\Collection sont simplement deux identifiants. Les espaces de noms existent parce que votre projet contiendra du code écrit par des gens que vous n’avez jamais rencontrés, et que personne ne s’est mis d’accord sur les noms à l’avance. Le rangement du code est un effet secondaire agréable. Éviter la collision, c’est la raison.
Noms pleinement qualifiés
Vous pouvez toujours désigner une classe par son chemin complet, quel que soit l’espace de noms où vous vous trouvez. Écrivez-le en entier, avec une barre oblique inverse en tête, et vous obtenez un nom pleinement qualifié :
<?php

namespace App\Services;

function makeProduct(): \App\Models\Product
{
    return new \App\Models\Product('Keyboard', 49.00);
}
Toute l’affaire tient dans ce \. Dans App\Services, un Product nu se résout par rapport à l’espace de noms courant : PHP cherche App\Services\Product, qui n’existe pas. Un \ en tête signifie « pars tout en haut », depuis l’espace de noms global.
Vous avez besoin de la même astuce pour les classes intégrées à PHP, dès que votre fichier a un espace de noms :
<?php

namespace App\Services;

function now(): \DateTimeImmutable
{
    return new \DateTimeImmutable();
}
DateTimeImmutable n’a pas d’espace de noms. Elle vit tout en haut, à côté d’Exception, d’ArrayObject et de toutes les autres classes intégrées, et depuis App\Services le seul moyen de l’atteindre est la barre oblique inverse en tête. Ou le mot-clé use, qui importe le nom une fois pour toutes et vous épargne le \ partout ailleurs. C’est la suite.
Un mot sur les fonctions et les constantes
Les espaces de noms couvrent aussi les fonctions et les constantes. namespace App\Helpers; suivi de function slugify(string $s): string { ... } vous donne App\Helpers\slugify(). Vous le croiserez moins souvent que prévu, pour une raison précise : pour un nom nu de fonction ou de constante, PHP se rabat sur l’espace de noms global quand aucune version dans l’espace courant n’existe. C’est pour cela que strlen() et array_map() continuent de fonctionner dans un fichier avec espace de noms, sans y penser. Les classes n’ont pas ce filet. Trompez-vous d’espace de noms pour une classe, et PHP ne la trouvera tout simplement pas.
Désigner du code avec le mot-clé use
Écrire \App\Models\Product chaque fois que vous avez besoin d’un Product lasse vite, et noie votre logique sous des chemins de fichiers. Le mot-clé use importe un nom une seule fois, en tête de fichier, et le nom court fonctionne ensuite jusqu’à la fin de ce fichier.
Imports de base
<?php

declare(strict_types=1);

namespace App\Services;

use App\Models\Product;

function makeProduct(string $name, float $price): Product
{
    return new Product($name, $price);
}
Une ligne use, et Product signifie App\Models\Product jusqu’à la fin du fichier. Pas de barre oblique inverse, pas de chemin complet, pas d’ambiguïté. Les instructions use se placent juste sous la déclaration namespace, avant tout le reste.
Voyez-le comme un post-it collé sur la première page : « quand je dis Product, je veux dire App\Models\Product ». Le post-it ne tient que sur ce fichier. Importer une classe dans un fichier n’a aucun effet sur les autres fichiers, si bien que chaque fichier qui a besoin de Product répète la même ligne use. Cette répétition est normale, ce n’est pas un signe que vous faites quelque chose de travers.
Renommer avec as
Parfois, le nom court est déjà pris. Deux paquets exportent chacun une Collection, ou une bibliothèque a choisi un nom qui se lit mal dans votre code. use ... as renomme l’import, pour ce fichier seulement :
<?php

declare(strict_types=1);

namespace App\Services;

use App\Models\Product;
use App\Models\Product as ProductModel;
use Vendor\Ecommerce\Product as ExternalProduct;

function convert(ExternalProduct $external): ProductModel
{
    return new ProductModel($external->title, $external->cost);
}
Hors de ce fichier, App\Models\Product et Vendor\Ecommerce\Product gardent leurs noms. Vous vous êtes simplement donné deux étiquettes locales bien distinctes, au seul endroit qui doit parler des deux à la fois.
Importer plusieurs noms d’un coup
Quand un fichier s’appuie beaucoup sur un même espace de noms, regroupez les imports au lieu de répéter le préfixe :
<?php

declare(strict_types=1);

namespace App\Services;

use App\Models\{Product, Category, Warehouse};
C’est exactement équivalent à trois lignes use séparées. Certaines équipes aiment la compacité, d’autres trouvent un import par ligne plus lisible dans un diff. Choisissez, et tenez-vous-y dans un même projet.
Importer des fonctions et des constantes
use ne sert pas qu’aux classes. Une fonction utilitaire ou une constante placée dans un espace de noms (plus rare qu’une classe, la section précédente l’a dit, mais ça arrive) s’importe avec use function et use const :
<?php

declare(strict_types=1);

namespace App\Services;

use function App\Helpers\slugify;
use const App\Helpers\DEFAULT_LOCALE;

$slug = slugify('Hello, Composer!');
Vous avez croisé cette forme au début du chapitre, dans Hello, Composer! : use function Termwind\render;. Elle ressemblait sans doute à un petit tour de magie à ce moment-là. C’est le même mécanisme que tout ce qui figure sur cette page, un import limité à un fichier, pour écrire un nom court à la place d’un nom long.
Ce que vous y gagnez vraiment
Une instruction use est de la tenue de registre, pas du comportement. Rien ne change dans la classe, la fonction ou la constante concernée. Ce que vous obtenez, c’est du code qui se lit comme vous pensez : new Product(...) plutôt que new \App\Models\Product(...), avec une ligne en tête de fichier qui porte toute la désambiguïsation. Avec namespace, vous avez maintenant tout ce qu’il faut pour écrire du code qui n’entre en collision avec celui de personne. Reste à le répartir entre fichiers et dossiers de manière sensée, et c’est la suite.
Organiser un projet en plusieurs fichiers
Vous savez déclarer un espace de noms et importer depuis un autre. Ce qui manque encore, c’est le lien entre les espaces de noms et le système de fichiers : pour l’instant, rien ne dit à PHP que App\Models\Product vit dans un fichier plutôt qu’un autre. Vous pourriez le mettre n’importe où. Vous ne devriez pas, et l’organisation décrite ici est ce qui rend « n’importe où » nettement moins tentant.
Une classe, un fichier
Une classe, interface, trait ou énumération par fichier, et le fichier porte son nom, à l’identique, casse comprise. Product vit dans Product.php. Pas product.php, pas models.php avec trois classes entassées dedans. Le langage n’impose rien de tel. L’écosystème suit cette convention de si près que la contourner déroutera la prochaine personne qui ouvrira votre projet.
Ça paraît contraignant après des scripts où tout tenait dans un seul fichier. Ça se rentabilise dès qu’un projet dépasse une poignée de classes : vous retrouvez n’importe quelle classe à partir de son seul nom, sans grep.
Un dossier qui reflète l’espace de noms
Seconde moitié de la convention : l’arborescence des dossiers reflète celle des espaces de noms. Un petit projet peut ressembler à ceci :
$ find src -type f
src/Models/Product.php
src/Models/Category.php
src/Services/Cart.php
src/Services/PricingCalculator.php
Et l’espace de noms dans chaque fichier correspond à son chemin sous src/ :
<?php

declare(strict_types=1);

namespace App\Models;

class Product
{
    public function __construct(
        public readonly string $name,
        public readonly float $price,
    ) {
    }
}
<?php

declare(strict_types=1);

namespace App\Models;

class Category
{
    public function __construct(
        public readonly string $name,
    ) {
    }
}
<?php

declare(strict_types=1);

namespace App\Services;

use App\Models\Product;

class Cart
{
    /** @var Product[] */
    private array $items = [];

    public function add(Product $product): void
    {
        $this->items[] = $product;
    }

    public function total(): float
    {
        return array_sum(array_map(
            fn (Product $product) => $product->price,
            $this->items,
        ));
    }
}
App\Models\Product se trouve dans src/Models/Product.php. App\Services\Cart se trouve dans src/Services/Cart.php. Remarquez que le préfixe App n’a pas de dossier App : il désigne src/ dans son ensemble. C’est une correspondance unique, déclarée une seule fois, et c’est le sujet de la section suivante.
Assembler le tout depuis un point d’entrée
Avec cette organisation en place, un script d’entrée (disons public/index.php, ou une commande ponctuelle que vous lancez avec php run.php) importe ce dont il a besoin et passe à l’action :
<?php

declare(strict_types=1);

require __DIR__ . '/vendor/autoload.php';

use App\Models\Product;
use App\Services\Cart;

$cart = new Cart();
$cart->add(new Product('Keyboard', 49.00));
$cart->add(new Product('Mouse', 25.00));

echo $cart->total() . "\n";
Pas un seul require pour Product.php ou Cart.php, rien que vendor/autoload.php, la ligne venue de Hello, Composer!. Ce n’est pas une coïncidence, et ce n’est pas de la magie non plus. Ça fonctionne grâce à un petit bloc de configuration qui relie le préfixe App\ au dossier src/. Ce bloc, c’est PSR-4, et une fois qu’il est en place ce script affiche 74.
Une classe par fichier (PSR-4)
Tout ce chapitre converge vers un petit bloc de JSON. Vos classes ont un espace de noms, vos fichiers les importent avec use, src/ reflète l’arborescence des espaces de noms, et pourtant rien n’a encore dit à Composer que tout cela est lié. PSR-4 est la règle publiée qui fait correspondre un espace de noms à un répertoire sur le disque. Elle vient du PHP-FIG, le groupe qui coordonne ce genre de conventions dans tout l’écosystème.
La règle, précisément
PSR-4 travaille sur des préfixes. Vous dites à Composer : « toute classe dont le nom commence par ce préfixe vit sous ce répertoire, et le reste du nom forme le reste du chemin ». Dans composer.json :
{
    "name": "you/your-project",
    "autoload": {
        "psr-4": {
            "App\\": "src/"
        }
    }
}
Avec cette correspondance, App\Models\Product se résout en trois gestes. Retirez le préfixe App\ : Models\Product. Remplacez les barres obliques inverses par des barres obliques et ajoutez .php : Models/Product.php. Placez le répertoire de base devant : src/Models/Product.php. C’est tout l’algorithme. Aucune configuration par classe, aucune liste de fichiers à entretenir, une règle appliquée à chaque fois.
Warning
Notez la double barre oblique inverse dans
"App\\". C’est une chaîne JSON, une barre oblique inverse littérale doit donc être échappée. Facile à oublier, et Composer vous le dira sans détour (un chemin d’autoload qui ne se résout pas) si ça vous arrive.
Brancher le tout
Si vous avez lancé composer init dans Hello, Composer!, ajoutez le bloc autoload à la main dans votre composer.json existant. Puis demandez à Composer d’en tenir compte :
$ composer dump-autoload
Generating autoload files
Generated autoload files
Cela régénère les fichiers de vendor/composer/, dont la table PSR-4 entrevue dans Paquets et chargement automatique. Dès lors, require 'vendor/autoload.php' trouve vos propres classes App\ exactement comme il trouvait déjà Termwind.
Essayez : lancez le point d’entrée de la section précédente. Il affiche 74. Ajoutez ensuite une nouvelle classe sous src/, utilisez-la depuis le même script, et relancez. Rien d’autre à faire.
Quand le relancer
L’autoloader PSR-4 résout les chemins par une règle, pas à partir d’une liste figée, si bien que dans la plupart des installations une nouvelle classe au bon endroit est trouvée immédiatement. Malgré tout, relancer composer dump-autoload après avoir ajouté des classes est une habitude qui vaut le coup. Certaines procédures de déploiement construisent une table de classes optimisée (composer dump-autoload --optimize, ou automatiquement avec composer install --no-dev sur un serveur de production) qui échange la règle à la volée contre de la vitesse, et cette table ne connaît que les classes qui existaient au moment où elle a été générée. Si vous ajoutez src/Models/Discount.php et que PHP ne trouve soudain plus App\Models\Discount, composer dump-autoload est la première chose à essayer. Ça ne coûte rien.
Vérifier votre travail
Composer remarque aussi quand fichiers et espaces de noms ne concordent plus : une faute de frappe dans une ligne namespace, une classe enregistrée dans le mauvais dossier :
$ composer dump-autoload
Generating autoload files
Warning: Ambiguous class resolution, "App\Models\Product" was found in
both "src/Models/Product.php" and "src/Models/product.php", the first
will be used.
Generated autoload files
C’est tout le système, et le meilleur est le peu de place qu’il prend dans vos journées. Donnez un espace de noms à la classe, placez le fichier là où l’espace de noms l’indique, et l’autoloader (cette ligne écrite dans Hello, Composer! et jamais retouchée depuis) la trouve. À partir d’ici, chaque exemple multi-fichiers de ce livre suppose exactement cette organisation : un dossier src/, un espace de noms App\, et un seul require auquel on n’en ajoute jamais un second.
Les collections courantes
Une liste de courses, un annuaire, une boîte de fiches, une ligne d’une base de données. Dans la plupart des langages, ce sont quatre types différents. En PHP, c’est une seule et même chose : un tableau.
Vous utilisez des tableaux depuis le chapitre 3, un $fruits = ["apple", "banana"] par-ci, un foreach par-là, juste assez pour faire avancer un exemple. C’était à crédit. Les tableaux sont la structure dont les programmes PHP sont faits, et ils méritent d’être compris pour de bon, une fois, plutôt qu’attrapés au passage.
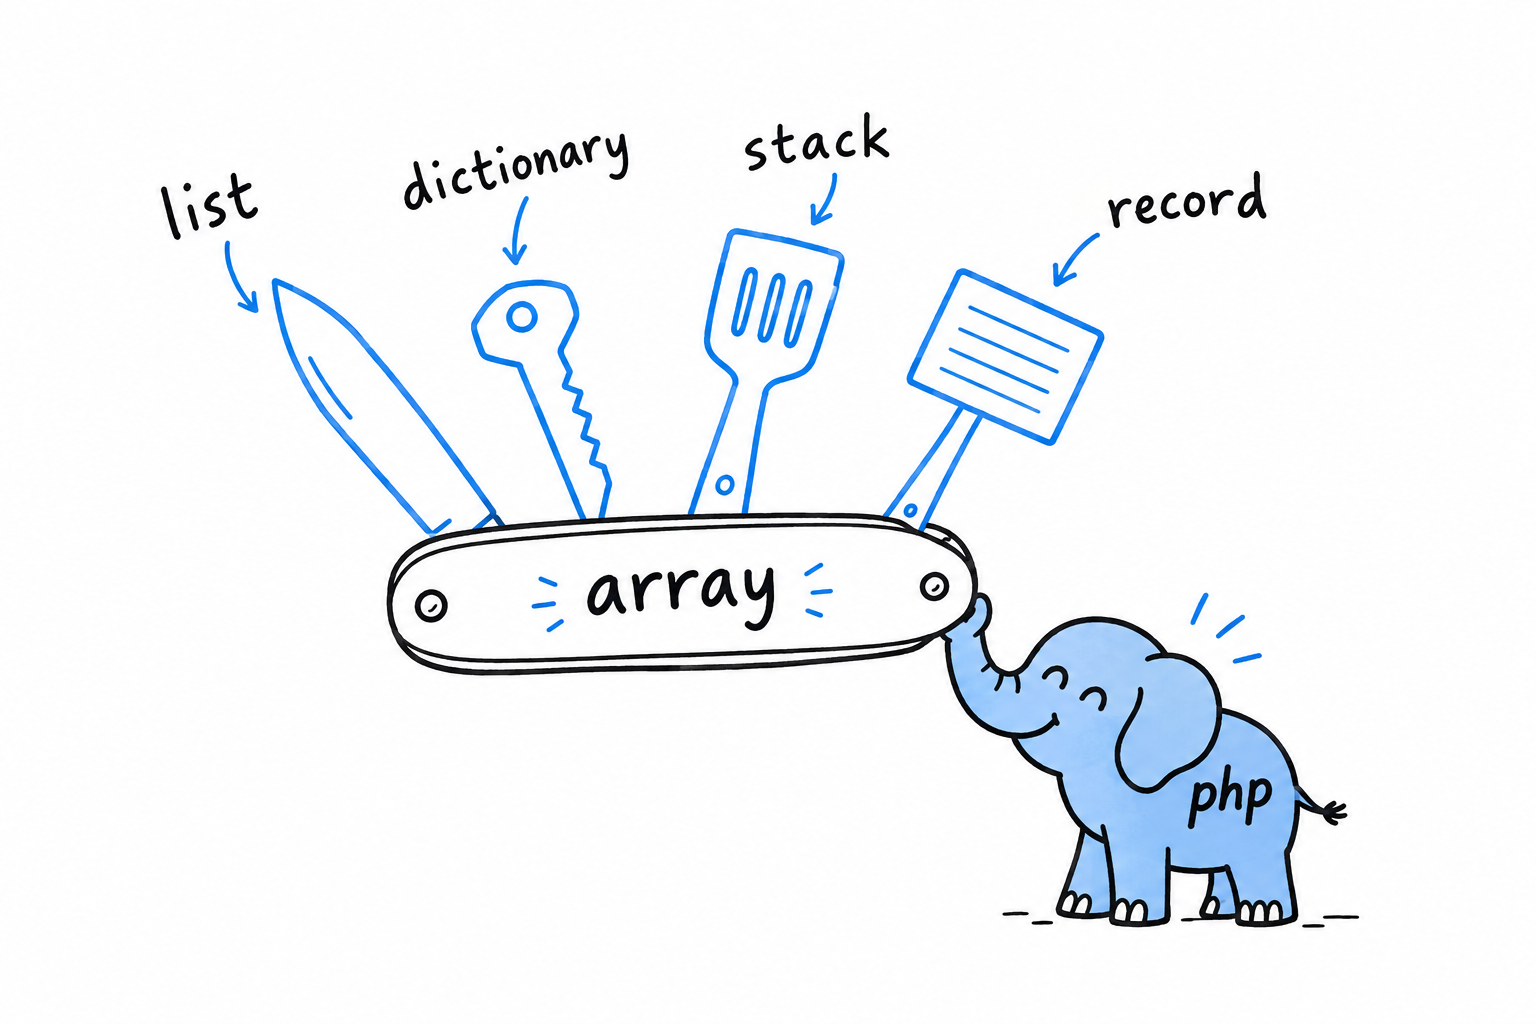
Si une seule structure suffit à tant de choses, la raison tient en une phrase, et c’est la clé de tout le chapitre. Un tableau PHP est toujours une table ordonnée : des clés, chacune pointant vers une valeur, conservées dans l’ordre où vous les avez ajoutées. Prenez 0, 1, 2 comme clés et cela ressemble à une liste. Prenez des mots et cela ressemble à un dictionnaire. En dessous, rien n’a changé. Gardez ce fait en tête et bien des comportements déroutants (pourquoi l’ordre est conservé, pourquoi array_filter() laisse des trous dans les clés, pourquoi count() est instantané) deviennent évidents.
Une liste et un dictionnaire, c’est le même tableau PHP avec d’autres clés.
Le chapitre fait aussi halte sur les chaînes de caractères, et ce n’est pas un changement de sujet. Chaînes et tableaux vivent côte à côte dans le PHP de tous les jours : on découpe une chaîne en tableau et on recolle des tableaux de chaînes à longueur de journée. Et dès qu’une chaîne contient autre chose que de l’anglais sans accent (un prénom accentué, un symbole monétaire, un emoji), vous rencontrez UTF-8, que PHP gère bien, à condition de le lui demander correctement.
Les tableaux indexés ouvrent le bal, puisque vous avez déjà l’intuition des listes. Puis les chaînes de caractères, avec un regard honnête sur les octets et les caractères, la distinction qui piège presque tout le monde une fois. Puis les tableaux associatifs, où des clés choisies par vous transforment la même structure en une petite fiche souple.
Stocker des listes de valeurs avec les tableaux indexés
Trois fruits, dans un ordre fixe, chacun accessible par sa position. C’est un tableau indexé, ce que la plupart des langages appellent simplement un tableau ou une liste, et il se construit avec des crochets :
<?php

declare(strict_types=1);

$fruits = ['apple', 'banana', 'cherry'];

echo $fruits[0] . "\n"; // apple
echo $fruits[2] . "\n"; // cherry
echo count($fruits) . "\n"; // 3
Les positions commencent à 0, pas à 1. $fruits[0] est le premier élément, $fruits[2] le troisième et dernier.
count() donne le nombre d’éléments, et vous l’appellerez sans arrêt. C’est une lecture instantanée, pas un parcours du tableau, alors n’hésitez jamais à le mettre dans la condition d’une boucle.
Ajouter à la fin
On construit rarement un tableau d’un bloc. Le plus souvent, on part de vide et on le fait grandir, et la façon de dire « ajoute ça à la fin » en PHP, c’est une paire de crochets vides :
<?php

declare(strict_types=1);

$shoppingList = [];

$shoppingList[] = 'milk';
$shoppingList[] = 'eggs';
$shoppingList[] = 'bread';

print_r($shoppingList);
// Array
// (
//     [0] => milk
//     [1] => eggs
//     [2] => bread
// )
$shoppingList[] = 'milk' ressemble à un accès à rien du tout. Lisez-le comme un idiome à part entière : « donne-lui la prochaine position libre et range-le là ». PHP garde le compte de cette prochaine position ; vous n’avez jamais à le faire.
Essayez : affichez count($shoppingList) après chaque ligne. 1, 2, 3.
Le modèle mental : un tableau est une table ordonnée
Voici le fait qui met en place tout le reste du chapitre. Il n’existe pas de type liste à part en PHP. ['apple', 'banana', 'cherry'] est un raccourci pour [0 => 'apple', 1 => 'banana', 2 => 'cherry'] : un tableau indexé est un tableau dont les clés se trouvent être 0, 1, 2. En dessous, tous les tableaux PHP sont la même structure, une table de clés vers des valeurs qui retient l’ordre d’insertion.
Cela explique un comportement qui, sinon, passerait pour une bizarrerie. Filtrez un tableau indexé, et les survivants gardent leurs clés d’origine :
<?php

declare(strict_types=1);

$numbers = [10, 15, 20, 25, 30];

$even = array_filter($numbers, fn (int $n) => $n % 2 === 0);

print_r($even);
// Array
// (
//     [0] => 10
//     [2] => 20
//     [4] => 30
// )
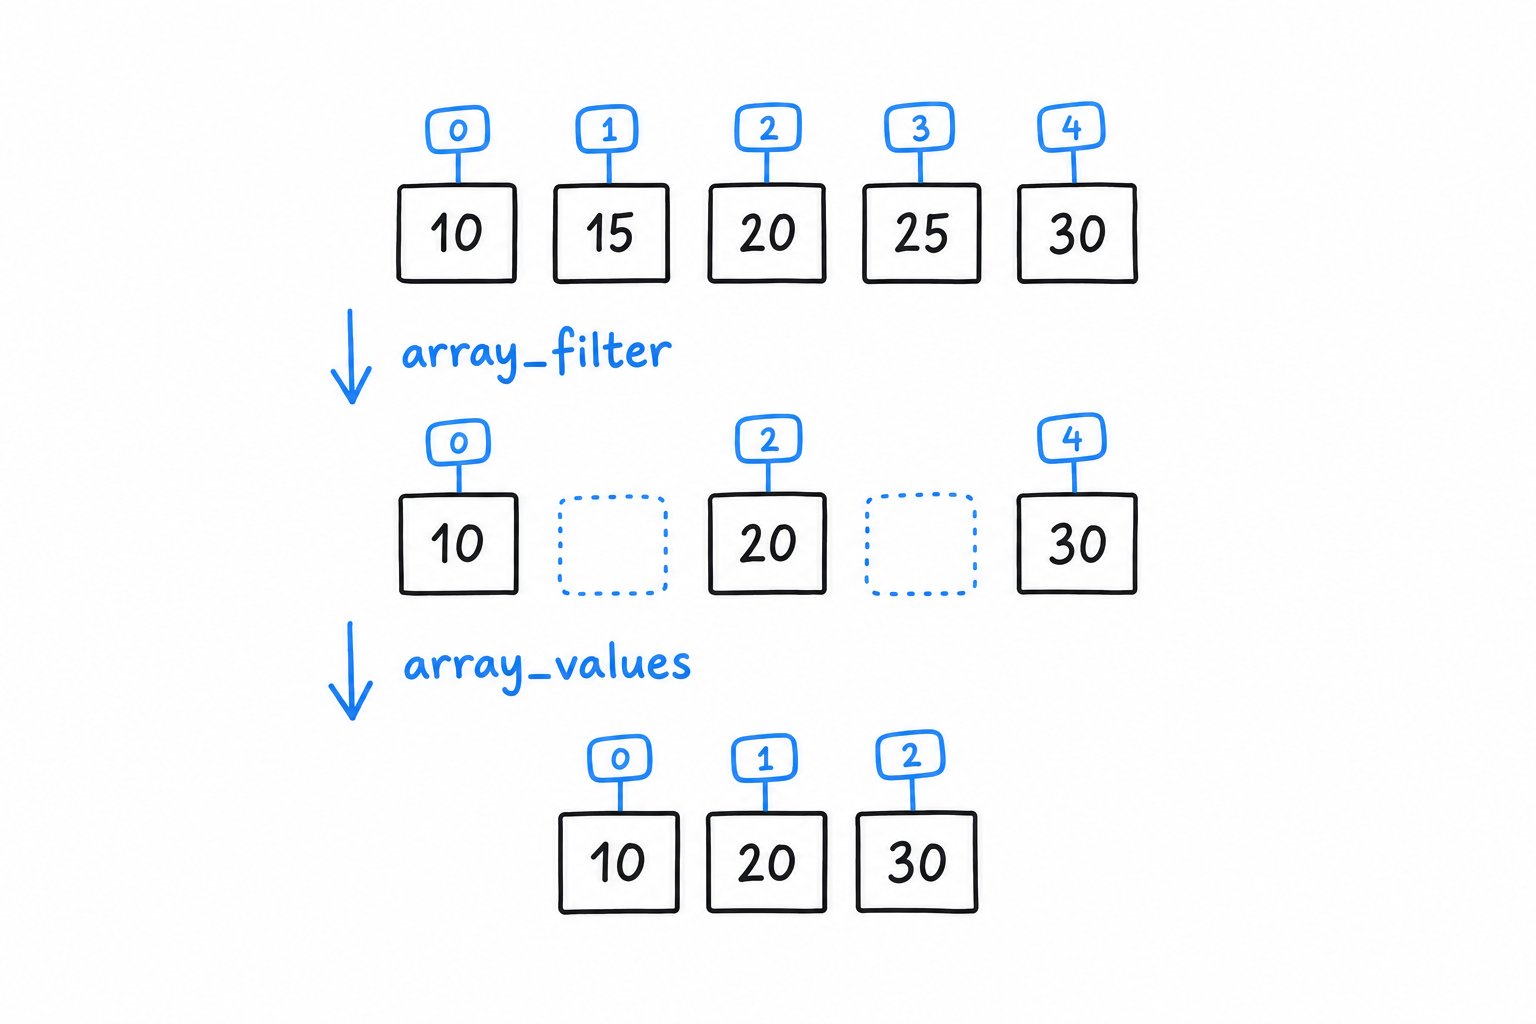
Les clés 1 et 3 ont disparu, elles n’ont pas été renumérotées. array_filter() a retiré deux entrées d’une table, et une table n’a aucune raison de rester contiguë. S’il vous faut ensuite une suite propre 0, 1, 2, array_values() renumérote :
<?php

$reindexed = array_values($even); // [10, 20, 30]
Un tableau indexé est une table dont les clés se trouvent être 0, 1, 2. Retirez une entrée, les autres ne bougent pas.
Les fonctions que vous utiliserez sans cesse
Une poignée de fonctions couvre l’essentiel de ce qu’on fait avec des listes au quotidien :
<?php

declare(strict_types=1);

$scores = [88, 92, 74, 95, 60];

array_push($scores, 100);        // append (same as $scores[] = 100, but explicit)
$last = array_pop($scores);      // removes and returns the last element (100)

$passing = array_filter($scores, fn (int $s) => $s >= 60);
$grades = array_map(fn (int $s) => $s >= 90 ? 'A' : 'B', $passing);

sort($scores); // sorts in place, re-indexes from 0

$hasTopScore = in_array(95, $scores, strict: true);

echo implode(', ', $grades) . "\n";
array_map() transforme chaque élément et renvoie un tableau de même longueur. array_filter() garde les éléments qui passent un test et, vous venez de le voir, garde aussi leurs clés. sort() fait autrement : il modifie le tableau sur place et le renumérote à partir de 0, ce qui compte si vous teniez aux anciennes clés.
in_array() cherche une valeur. Passez strict: true pour qu’il compare avec === plutôt qu’avec la comparaison souple par défaut de PHP, pour la même raison qui a valu à === son propre encadré dans Types de données. Faites-en une habitude.
array_push() et $scores[] = ... font le même travail pour une seule valeur. array_push() accepte plusieurs valeurs d’un coup, et « push » se lit bien quand on pense au tableau comme à une pile. Prenez celui qui se lit le mieux à l’endroit où vous l’écrivez.
Stocker du texte encodé en UTF-8 avec les chaînes de caractères
Demandez à PHP la longueur du mot café, et il répond cinq.
Vous avez rencontré les chaînes de caractères dans Hello, World! et utilisé l’interpolation dans le jeu de devinette sans cérémonie. Ce que nous avons passé sous silence, à raison, c’est la partie qui finit par mordre tous ceux qui manipulent des chaînes en PHP. Une chaîne PHP n’est pas faite de caractères. Elle est faite d’octets. La plupart du temps, la différence est invisible. Jusqu’au jour où elle ne l’est plus.
Les guillemets, en bref
Vous utiliserez les deux sortes sans arrêt, alors voici la règle une fois encore. Les guillemets simples sont ce que PHP a de plus littéral : pas d’interpolation, pas de séquence d’échappement en dehors de \' et \\. Les guillemets doubles remplacent les variables par leur valeur et comprennent les séquences comme \n et \t :
<?php

declare(strict_types=1);

$name = 'Damien';

echo 'Hello, $name\n';   // Hello, $name\n  (literal, no processing)
echo "Hello, $name\n";   // Hello, Damien  (interpolated, newline applied)
Choisissez les guillemets simples quand il n’y a rien à interpoler. C’est un peu plus rapide, PHP ne parcourt pas le texte à la recherche de $ ou de \, mais le vrai bénéfice est pour le prochain lecteur : les guillemets simples disent « rien de malin ici ».
Octets et caractères
Voici le fait qui compte. Les fonctions classiques de PHP sur les chaînes (strlen(), strtoupper(), substr() et leurs cousines) travaillent sur des octets, point. C’était une hypothèse raisonnable dans un monde ASCII, où un octet est un caractère. Elle s’effondre dès que le texte n’est plus de l’ASCII, et en UTF-8, ce que produit à peu près tout le PHP moderne, ça arrive vite :
<?php

declare(strict_types=1);

$name = 'café';

echo strlen($name) . "\n";     // 5, not 4!
echo mb_strlen($name) . "\n";  // 4, correct
café a quatre caractères, mais UTF-8 range le é sur deux octets, si bien que strlen(), qui compte des octets, dit cinq. Ce n’est pas faux, à proprement parler. C’est la réponse à une question que vous ne vouliez pas poser. mb_strlen() (mb pour multibyte, multi-octets) comprend UTF-8 et compte des caractères, ce que vous vouliez dire.
Essayez : remplacez café par un seul emoji. strlen() dit quatre, mb_strlen() dit un.
La règle pratique tient en une phrase. Si une chaîne peut un jour contenir quelque chose tapé par un utilisateur (un nom, un commentaire, une recherche), utilisez la variante mb_. strlen() reste juste pour le travail réellement orienté octets : la taille du contenu d’un fichier, ou une chaîne que vous avez construite vous-même en ASCII connu. Dans le doute, mb_strlen() ne vous coûte rien, et il vous épargne un bug qui n’apparaît que chez certains de vos utilisateurs, en général ceux qui ont un accent dans leur nom. C’est le genre qui fait honte.
Warning
strlen()compte des octets.mb_strlen()compte des caractères. Pour tout ce qu’un humain a tapé, ce sont des caractères que vous voulez.
Les fonctions de tous les jours
Une poignée de fonctions couvre le gros du travail réel sur les chaînes :
<?php

declare(strict_types=1);

$message = 'PHP is not dead, it just smells funny.';

if (str_contains($message, 'not dead')) {
    echo "Reassuring.\n";
}

$corrected = str_replace('not dead', 'thriving', $message);
echo $corrected . "\n";

$excerpt = substr($message, 0, 12);
echo $excerpt . "...\n"; // PHP is not d...

$formatted = sprintf('%s scored %d%% on the test.', 'Alice', 92);
echo $formatted . "\n"; // Alice scored 92% on the test.
str_contains() (PHP 8.0 et suivants) demande si une chaîne apparaît dans une autre et renvoie un booléen, sans plus. Elle a remplacé le vieil idiome strpos($haystack, $needle) !== false que vous croiserez encore dans du code ancien, avec son false à part qui n’attend que de vous faire trébucher. str_replace() remplace chaque occurrence d’une sous-chaîne. substr() découpe une portion par position de départ et longueur, et comme strlen(), elle a une jumelle mb_substr() qui compte des caractères, selon la même règle que plus haut.
sprintf() construit une chaîne à partir d’un modèle et d’une liste de valeurs. Passé une ou deux valeurs, c’est bien plus lisible qu’une suite de concaténations, et cela donne un contrôle que l’interpolation n’offre pas : %d%% ci-dessus force 92 à être traité comme un entier, puis affiche un % littéral. printf() fait la même chose, moins la partie « renvoyer une chaîne » : il affiche directement.
L’interpolation, une dernière fois
Vous connaissez les bases depuis le chapitre 2. La forme complète mérite d’être sous la main : {$expr} entre guillemets doubles accepte plus qu’une simple variable, un accès de tableau, une propriété, un appel de méthode, tout ce qui se résout en une valeur :
<?php

declare(strict_types=1);

$user = ['name' => 'Alice', 'age' => 30];

echo "{$user['name']} is {$user['age']} years old.\n";
Sans les accolades, "$user['name']" ne fait pas ce que vous attendez : PHP s’arrêterait à $user en lisant le nom de la variable et afficherait le reste tel quel. Les accolades lèvent l’ambiguïté, alors faites-en votre réflexe dès qu’une interpolation dépasse une simple $variable.
Associer des clés à des valeurs avec les tableaux associatifs
Reprenez la rangée de boîtes de la section précédente et remplacez les étiquettes numérotées par des mots. C’est un tableau associatif, et c’est toute la différence.
Un tableau associatif est un tableau dont vous avez choisi les clés vous-même, des chaînes le plus souvent, au lieu de laisser PHP distribuer 0, 1, 2. Même structure, la table ordonnée de PHP, autres étiquettes :
<?php

declare(strict_types=1);

$prices = [
    'apple' => 0.50,
    'banana' => 0.30,
    'cherry' => 3.20,
];

echo $prices['banana'] . "\n"; // 0.3
$prices['date'] = 4.10; // add a new key
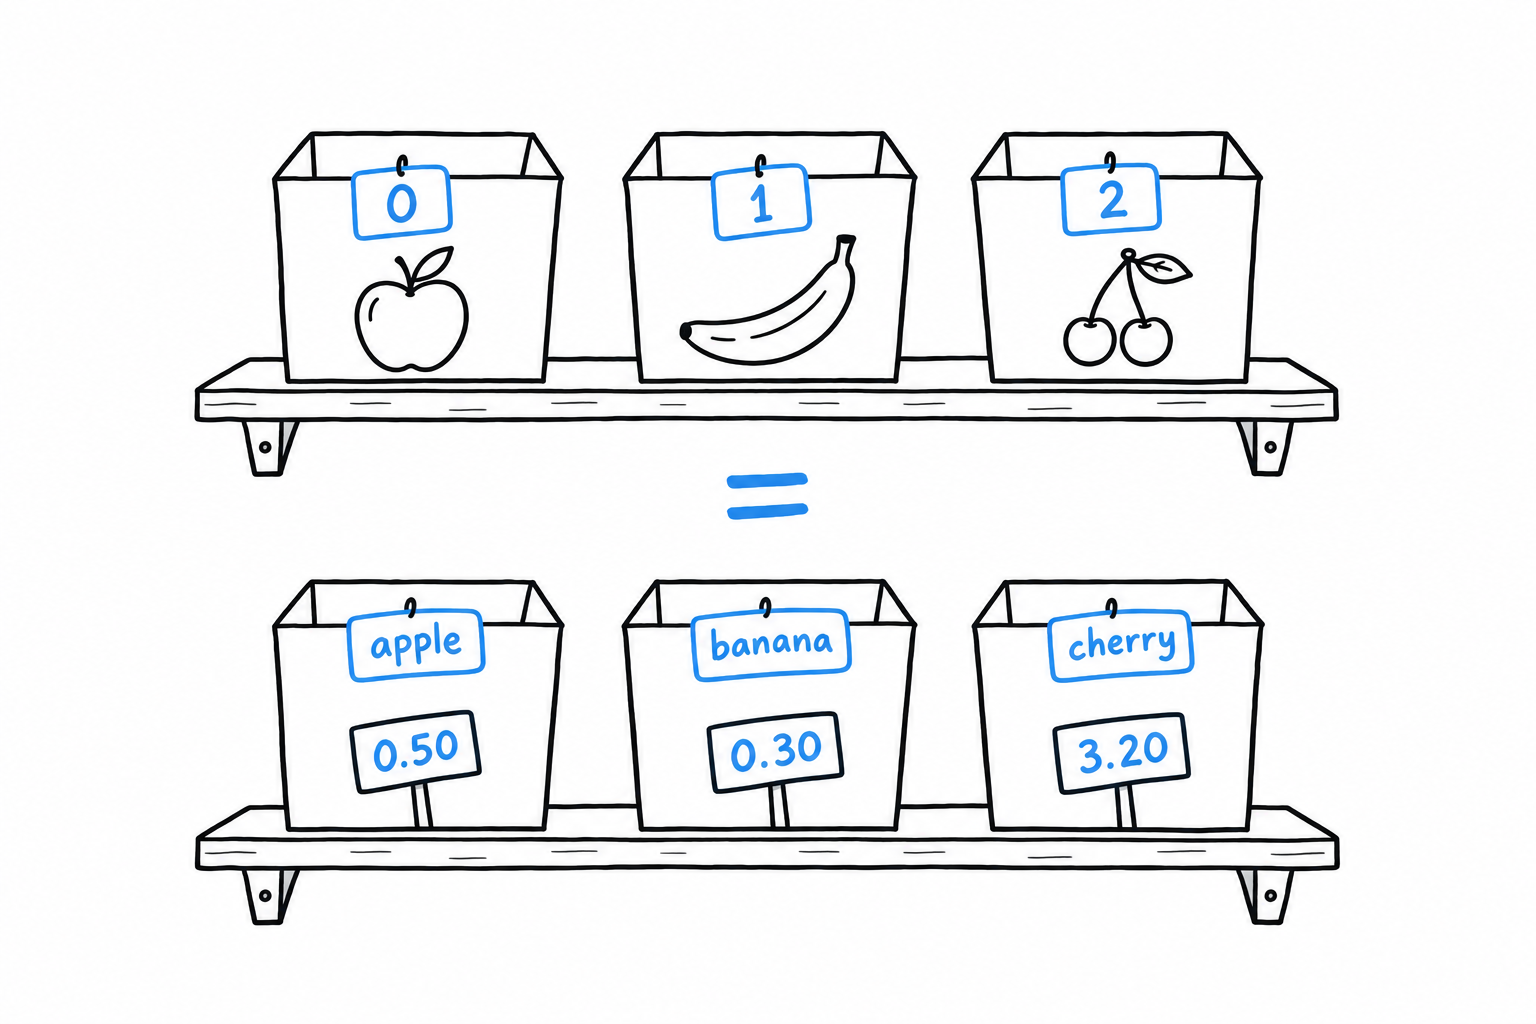
Les clés peuvent être des chaînes ou des entiers, et PHP mélange les deux dans un même tableau sans broncher. Elles doivent être uniques, en revanche : affectez une clé qui existe déjà et vous écrasez sa valeur, au lieu d’ajouter une seconde entrée.
isset() contre array_key_exists(), et le piège entre les deux
Les deux fonctions répondent à une version de « cette clé est-elle là ? », et elles ne sont pas interchangeables. La différence a causé de vrais bugs, alors autant la comprendre une fois plutôt que de s’en souvenir à moitié.
<?php

declare(strict_types=1);

$user = [
    'name' => 'Alice',
    'nickname' => null,
];

var_dump(isset($user['name']));               // true
var_dump(isset($user['nickname']));           // false, surprising!
var_dump(array_key_exists('nickname', $user)); // true
Imaginez le tableau comme une rangée de tiroirs étiquetés. isset() ouvre le tiroir et demande s’il y a quelque chose dedans. Le tiroir nickname existe, mais il contient null, et pour isset() c’est comme s’il n’y avait pas de tiroir du tout. array_key_exists() ne lit que les étiquettes. Peu lui importe le contenu, seule compte l’existence du tiroir.
Cela compte chaque fois que null est une valeur à part entière plutôt qu’une absence : une fiche utilisateur où « pas de surnom » est volontairement rangé comme null, par exemple. Prenez isset() dans le cas courant (est-ce que ça existe et contient quelque chose d’utilisable), et array_key_exists() quand vous devez distinguer « jamais défini » de « défini à null ». Les confondre coûte une heure la première fois, et plus jamais ensuite. Croyez-moi sur parole.
Parcourir avec foreach
Vous avez vu foreach dans Structures de contrôle, surtout sur des tableaux indexés. Sur un tableau associatif, c’est la forme clé-valeur qui prend tout son sens :
<?php

declare(strict_types=1);

$prices = [
    'apple' => 0.50,
    'banana' => 0.30,
    'cherry' => 3.20,
];

foreach ($prices as $fruit => $price) {
    echo "{$fruit}: \${$price}\n";
}
// apple: $0.5
// banana: $0.3
// cherry: $3.2
L’ordre de parcours est l’ordre d’insertion, toujours. Encore une conséquence directe du fait que les tableaux sont des tables ordonnées et non de vraies tables de hachage sans ordre. Vous n’avez jamais à trier un tableau associatif pour obtenir un ordre prévisible ; il en a déjà un.
Imbriquer : des tableaux de tableaux associatifs
La forme que vous rencontrerez sans cesse dans du vrai code est la liste de fiches : un tableau indexé dont chaque élément est lui-même un tableau associatif, qui tient lieu de ligne de données :
<?php

declare(strict_types=1);

$books = [
    ['title' => 'The Pragmatic Programmer', 'author' => 'Hunt & Thomas', 'year' => 1999],
    ['title' => 'Refactoring', 'author' => 'Martin Fowler', 'year' => 2018],
    ['title' => 'Clean Code', 'author' => 'Robert C. Martin', 'year' => 2008],
];

foreach ($books as $book) {
    echo "{$book['title']} ({$book['year']}): {$book['author']}\n";
}

$recent = array_filter($books, fn (array $book) => $book['year'] >= 2008);
$titles = array_map(fn (array $book) => $book['title'], $books);

echo implode(', ', $titles) . "\n";
Imaginez une boîte de fiches cartonnées. Chaque fiche porte les trois mêmes lignes (titre, auteur, année), et la boîte les garde dans l’ordre. Tableau indexé dehors, tableau associatif dedans : c’est exactement ce que renvoie une requête de base de données, une réponse JSON décodée avec json_decode($json, true), ou un fichier CSV lu ligne par ligne.
Ça paraît presque trop simple pour mériter un nom, et ça en mérite un quand même. Le temps d’arriver au chapitre 14 et au-delà, c’est sous cette forme que vous tiendrez la plupart des données réelles avant qu’elles ne deviennent quelque chose de plus structuré, comme les objets du chapitre 5.
Gérer les erreurs
Un fichier manque. Un appel réseau ne répond plus. Quelqu’un passe une chaîne de caractères à une fonction qui attendait un nombre, et quelque part, une division tombe sur un zéro. Aucun programme n’échappe aux ennuis ; ce qui distingue les langages, c’est ce qui se passe au moment où l’ennui arrive, et le mot que vous avez à dire dessus. La réponse de PHP a beaucoup changé au fil des versions, et la réponse moderne vaut nettement mieux que sa réputation.
Le vieux PHP, et il en tourne encore beaucoup, échouait en silence. Un avertissement partait dans un journal que personne ne lisait, une fonction renvoyait false sans dire pourquoi, et le script continuait en boitant, avec des données à moitié construites, parce que rien ne l’avait arrêté. PHP 7 et 8 ont changé cela. La plupart des échecs produisent désormais un véritable objet que vous pouvez attraper et inspecter, et le langage trace une frontière nette entre deux sortes d’ennuis.
D’un côté, quelque chose est cassé : une méthode appelée sur null, un type qui ne correspond pas, une division par zéro. PHP lève une Error, et la seule réponse sensée est de corriger le code. De l’autre, quelque chose demande une décision : un fichier de configuration absent, un âge arrivé négatif, une API qui a refusé la requête. PHP, ou votre propre code, lève une exception, et quelqu’un, plus haut dans la pile d’appels, décide de la suite.
Une
Errordit « c’est cassé, corrigez ». Une exception dit « voilà un problème, décidez ».
Cette frontière traverse tout le chapitre. Erreurs fatales et Error couvre la première sorte, et explique pourquoi il vaut mieux la laisser tranquille. Les exceptions couvrent la seconde : try, catch, finally, lancer les vôtres, et la hiérarchie intégrée où se joue l’essentiel de votre gestion d’erreurs au quotidien. Lancer ou ne pas lancer parle de jugement : quand lancer, quand renvoyer null et laisser l’appelant décider, et quand la bonne réponse est de laisser le programme s’arrêter.
Rien de tout cela ne reste théorique. L’outil en ligne de commande du chapitre 14 s’appuie sur chacun de ces schémas, y compris une exception sur mesure écrite ici et retrouvée là-bas. La syntaxe s’apprend en un après-midi. L’instinct qui sépare « je gère » de « je laisse échouer » prend plus de temps, et il commence ici.
Erreurs irrécupérables : erreurs fatales et Error
Certains problèmes n’ont rien à voir avec la malchance. Aucun fichier n’a disparu, aucun utilisateur n’a tapé n’importe quoi : c’est votre code qui est faux. Vous avez appelé une méthode qui n’existe pas. Vous avez passé une chaîne de caractères à une fonction qui exigeait un entier, avec les types stricts activés. Vous avez divisé par zéro. Face à un bug, un programme n’a rien de sensé à faire, sinon s’arrêter et vous laisser corriger.
PHP représente cette famille avec la classe Error et ses sous-classes. En voici trois que vous croiserez sans arrêt :
<?php

declare(strict_types=1);

function half(int $n): int
{
    return $n / 0; // DivisionByZeroError
}

function double(int $n): int
{
    return $n * 2;
}

double("four"); // TypeError: strict_types is on, no silent conversion

$user = null;
$user->getName(); // Error: Call to a member function getName() on null
DivisionByZeroError, TypeError et la simple Error obtenue en appelant une méthode sur null font toutes le même travail : vous dire, aussi précisément que possible, que le programme a atteint un état où il n’avait rien à faire. Lancez le fichier. Il s’arrête à double("four"), la première chose fausse qu’il exécute vraiment. Mettez cette ligne en commentaire, relancez, et c’est l’appel sur null qui prend le relais ; appelez half(3) et ce sera la division. C’est exactement à cela que sert declare(strict_types=1), rencontré dans Les types de données : faire échouer un appel incorrect bruyamment, sur place, au lieu de le laisser passer.
Pourquoi c’était pire avant
Le code écrit avant PHP 7 est truffé de vérifications de null et de gardes is_int() semées dans les corps de fonctions, et il y avait une raison. À l’époque, la plupart de ces situations ne lançaient rien que l’on puisse attraper. Appeler une méthode sur null était une erreur fatale qui arrêtait le script, point final ; aucun try au monde ne pouvait s’interposer. Un type qui ne correspondait pas était converti sans bruit, ou provoquait un avertissement dans un journal que personne ne surveillait, et le programme continuait avec des données absurdes.
PHP 7 a introduit Error pour corriger cela, et PHP 8 a affûté le mécanisme. Presque tout, dans cette famille, est désormais un véritable objet qui implémente Throwable, la même interface que Exception. Vous pouvez donc écrire catch (Error $e) et laisser le programme continuer. Très souvent, vous ne devriez pas.
Attrapable ne veut pas dire « à attraper »
La question n’est pas de savoir si PHP peut vous tendre le problème sous forme d’objet. Depuis PHP 8, il le peut presque toujours. La question est de savoir si l’attraper répare quoi que ce soit. Comparez :
<?php

declare(strict_types=1);

// Reasonable: the input is genuinely unpredictable, and there's a sensible fallback.
try {
    $config = json_decode($configJson, associative: true, flags: JSON_THROW_ON_ERROR);
} catch (\JsonException $e) {
    $config = [];
}

// Unreasonable: papering over a bug instead of fixing it.
try {
    $total = $order->getTotal(); // $order might be null due to a bug upstream
} catch (\Error $e) {
    $total = 0; // now every bug in this code path just... returns zero, silently
}
Le premier try gère une situation qui peut vraiment se produire : du JSON venu de l’extérieur est parfois mal formé, et se rabattre sur une configuration vide est un choix défendable. Le second try attrape le symptôme d’un bug et le cache derrière un nombre plausible. Six mois plus tard, quelqu’un se demande pourquoi les totaux tombent parfois à zéro, sans exception, sans ligne de journal, sans le moindre indice, parce que le bloc catch a avalé la seule preuve.
Warning
Un large
catch (\Error $e)n’est pas un filet de sécurité. C’est une déchiqueteuse pour la trace d’appels dont vous aurez besoin plus tard.
N’attrapez Error et ses sous-classes qu’avec une bonne raison et un type étroit, précis. Si votre propre code produit une TypeError, la correction consiste à réparer l’appel, pas à l’envelopper dans un try. Lancer ou ne pas lancer trace cette frontière plus finement. Pour l’instant, lisez Error comme PHP vous disant que quelque chose est cassé, et les exceptions, juste après, comme PHP vous disant que quelque chose demande une décision.
Erreurs récupérables avec les exceptions
La section précédente parlait de bugs. Celle-ci parle des ennuis que votre code doit s’attendre à rencontrer : un fichier qui peut ne pas exister, un âge qui peut être négatif, une API qui peut refuser la requête. Rien de tout cela ne signifie que le programme est cassé. Il y a une décision à prendre, et la fonction qui repère le problème est rarement celle qui est en position de trancher. Une exception, c’est la manière pour une fonction de dire « voilà un problème, et voilà ce que j’en sais » à qui, plus haut dans la pile d’appels, saura quoi en faire.
try, catch, finally
La forme est la même que dans la plupart des langages qui ont des exceptions :
<?php

declare(strict_types=1);

function readConfig(string $path): array
{
    if (!file_exists($path)) {
        throw new \RuntimeException("Config file not found: {$path}");
    }

    return json_decode(file_get_contents($path), associative: true);
}

try {
    $config = readConfig('config.json');
    echo "Loaded " . count($config) . " settings.\n";
} catch (\RuntimeException $e) {
    echo "Couldn't load config: {$e->getMessage()}\n";
    $config = [];
} finally {
    echo "Config load attempt finished.\n";
}
Lancez-le sans config.json à côté du fichier. readConfig() atteint le throw, et l’exécution normale s’arrête là : rien après le throw ne s’exécute, et le echo "Loaded..." de l’appelant non plus. Le contrôle saute au catch englobant le plus proche dont le type correspond, en ignorant tout ce qui se trouve entre les deux, quel que soit le nombre d’appels de fonctions à traverser.
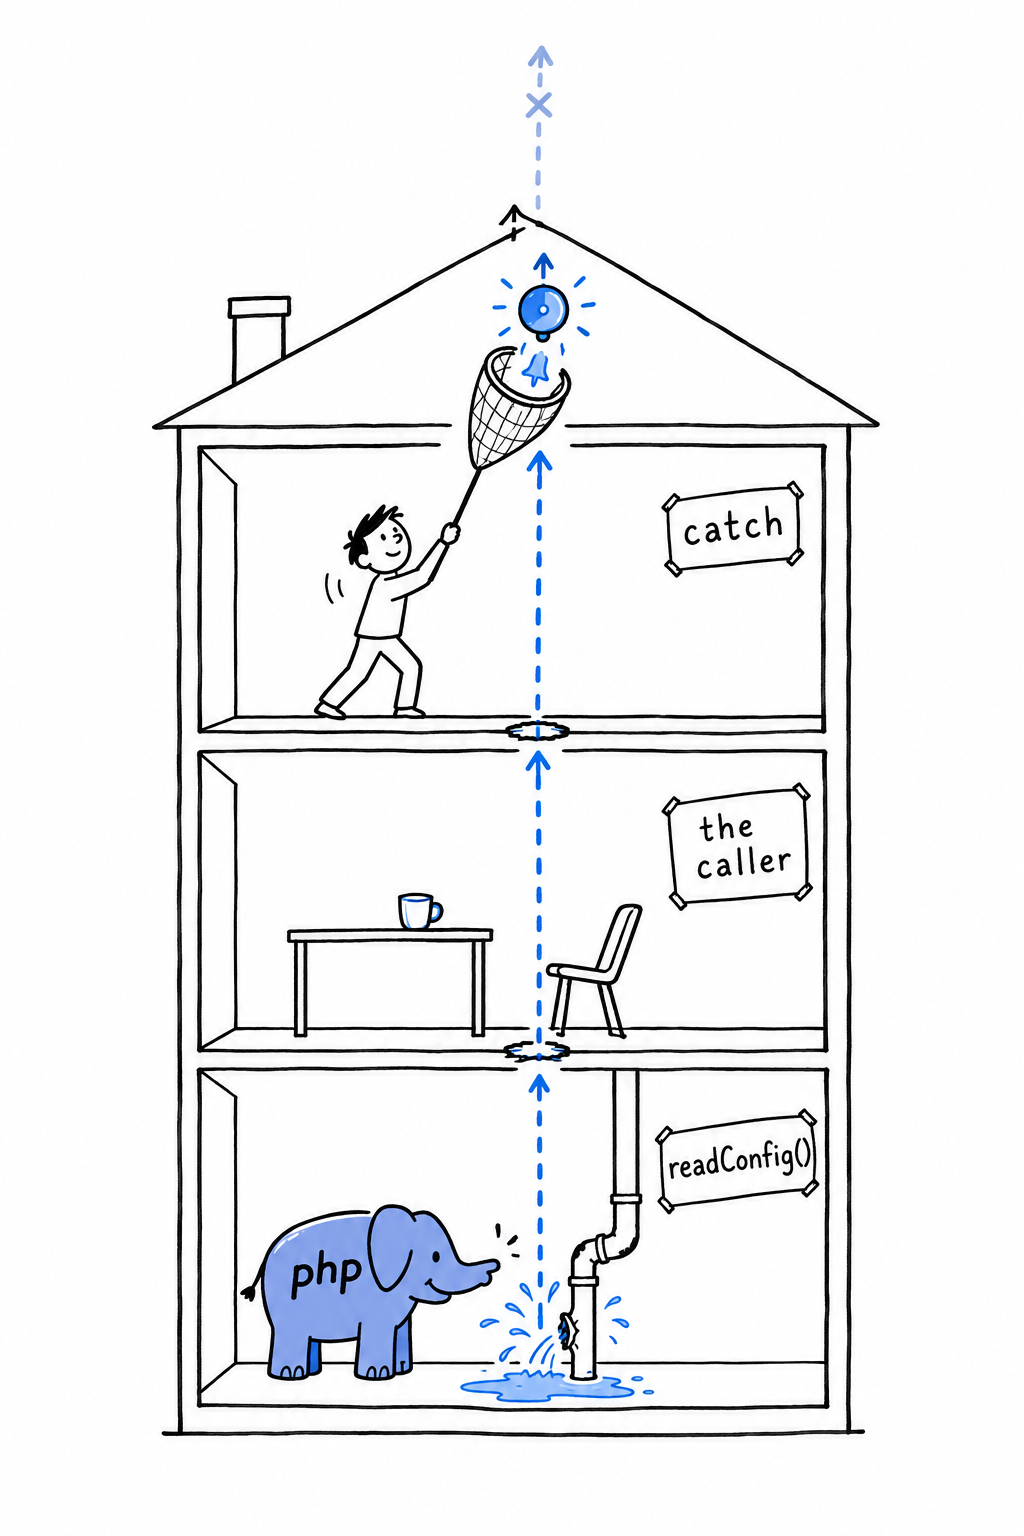
Pensez à une fuite au rez-de-chaussée d’un immeuble. Personne sur place ne peut la réparer, alors l’alarme monte, étage par étage, et chaque étage traversé lâche ce qu’il faisait, jusqu’à ce que quelqu’un l’attrape au filet. Si personne ne le fait, l’alarme atteint le toit, et PHP arrête le programme en affichant le message et le chemin que l’exception a parcouru.
finally s’exécute quoi qu’il soit arrivé : exception attrapée, exception non attrapée, ou pas d’exception du tout. C’est donc l’endroit pour le nettoyage qui doit avoir lieu dans tous les cas, comme fermer un fichier ou libérer un verrou.
Tip
Essayez : créez un
config.jsoncontenant{"debug": true}et relancez. Cette fois, le bloccatchest ignoré, etfinallyaffiche quand même sa ligne.
Exception contre Error, et Throwable
La hiérarchie des exceptions de PHP a deux branches parallèles, qui poussent depuis la même interface, Throwable.
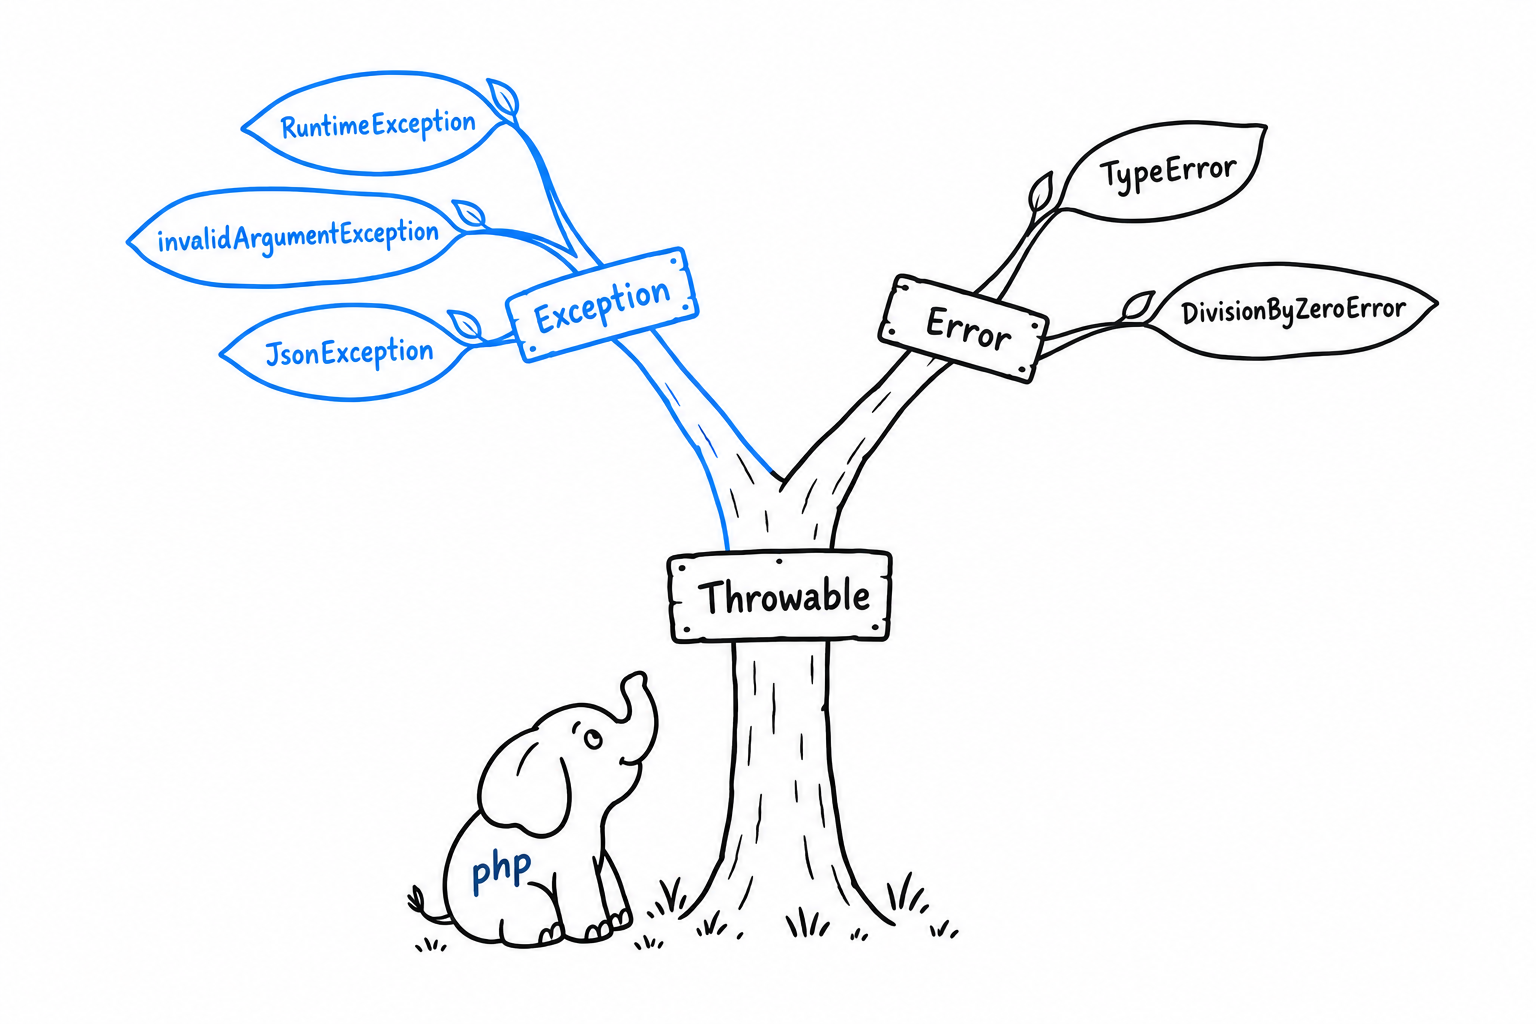
Exception et ses sous-classes (InvalidArgumentException, RuntimeException, JsonException) servent aux situations qu’un programme bien écrit peut anticiper et surmonter. Error et ses sous-classes (TypeError, DivisionByZeroError) sont les bugs de la section précédente.
Cette séparation est ce qui permet à un catch d’être précis. catch (\Exception $e) attrape les exceptions et laisse passer une Error ; catch (\Throwable $e) attrape les deux. Ne sortez \Throwable qu’à la lisière d’une application, dans un gestionnaire de dernier recours qui journalise ce que personne d’autre n’a traité avant que le processus ne se termine. Jamais comme type de catch ordinaire dans du code courant : l’attraper par réflexe, c’est ainsi que des bugs deviennent des cas « gérés » que personne ne corrige jamais.
Attraper plusieurs types à la fois
Un seul catch peut lister plusieurs types séparés par |, quand vous voulez les traiter de la même façon :
<?php

declare(strict_types=1);

try {
    $result = $client->send($request);
} catch (ConnectionException|TimeoutException $e) {
    echo "Network problem, retrying: {$e->getMessage()}\n";
    $result = retry($request);
}
Si le traitement diffère entre les deux, écrivez deux blocs catch. Le | sert quand la réponse est vraiment identique, pas à s’épargner un second bloc.
Écrire sa propre exception
RuntimeException et InvalidArgumentException couvrent beaucoup de terrain, mais nommer vos propres exceptions est l’une des choses les plus courantes que vous ferez en PHP. Un type d’exception précis dit à l’appelant exactement ce qui a échoué, et lui permet d’attraper cela et rien d’autre, au lieu de deviner à partir d’un message :
<?php

declare(strict_types=1);

class InvalidAgeException extends \Exception
{
    public function __construct(
        public readonly int $age,
    ) {
        parent::__construct("Invalid age: {$age}. Must be between 0 and 150.");
    }
}

function registerUser(string $name, int $age): void
{
    if ($age < 0 || $age > 150) {
        throw new InvalidAgeException($age);
    }

    echo "Registered {$name}, age {$age}.\n";
}

try {
    registerUser('Alice', -5);
} catch (InvalidAgeException $e) {
    echo "Registration failed: {$e->getMessage()}\n";
    echo "Offending value was: {$e->age}\n";
}
Étendre \Exception apporte d’un coup toute la mécanique standard : getMessage(), getCode(), getPrevious(), et une trace d’appels via getTraceAsString(). L’appel à parent::__construct() est ce qui branche votre message sur cette mécanique ; sautez-le et getMessage() revient vide. Au-delà, la classe est à vous. InvalidAgeException garde l’$age fautif dans une propriété en lecture seule, si bien que le bloc catch reçoit une donnée structurée, pas seulement une chaîne à décortiquer.
Ce petit motif, une exception précise qui transporte le contexte qui l’a provoquée, revient au chapitre 14. Autant vous y sentir à l’aise dès maintenant, car la question difficile n’est pas comment lancer. C’est quand.
Lancer ou ne pas lancer
La syntaxe de try et catch, c’est la partie facile. La partie difficile, celle qui sépare un code lisible d’un labyrinthe de vérifications défensives, c’est de décider quand une fonction doit lancer une exception, quand elle doit renvoyer null, false ou un tableau vide, et quand il est acceptable de laisser tout s’écrouler. Aucun compilateur ne tranchera à votre place. C’est du jugement, celui qu’on se forge en se brûlant dans les deux sens. Voici comment j’en suis venu à y réfléchir.
Introuvable n’est pas exceptionnel
L’erreur la plus fréquente que je rencontre, c’est de lancer une exception pour quelque chose qui n’a rien d’exceptionnel, juste une issue normale que l’appelant doit gérer. Chercher un utilisateur par un identifiant qui n’existe pas n’est pas une crise. Cela arrive toute la journée, aussi banalement que n’importe quelle autre branche de votre code :
<?php

declare(strict_types=1);

function findUserById(array $users, int $id): ?array
{
    foreach ($users as $user) {
        if ($user['id'] === $id) {
            return $user;
        }
    }

    return null; // not found, a completely normal outcome, not an error
}

$user = findUserById($users, 42);

if ($user === null) {
    echo "No such user.\n";
} else {
    echo "Found: {$user['name']}\n";
}
Renvoyer null dit à l’appelant exactement à quoi s’attendre, et le laisse décider ce que « introuvable » signifie là où il se trouve : afficher une 404, créer une valeur par défaut, redemander. Le type de retour ?array inscrit cette possibilité dans la signature, là où tout le monde la voit. Lancer une UserNotFoundException à la place forcerait chaque appelant à écrire un try pour quelque chose qui se produit sans arrêt et n’a rien de faux.
Gardez les exceptions pour ce qui est vraiment exceptionnel.
Lancer quand l’appelant avait une précondition à respecter
L’envers : lancez quand ce que l’appelant était censé garantir avant d’appeler, une précondition, ne tient pas, et qu’aucune valeur par défaut raisonnable n’existe. C’est l’InvalidAgeException de la section précédente. Un âge négatif n’est pas une issue normale sur laquelle brancher, c’est une promesse rompue. La fonction ne peut pas deviner ce que vous vouliez dire, alors elle le dit, fort et précisément :
<?php

declare(strict_types=1);

function withdraw(float $balance, float $amount): float
{
    if ($amount > $balance) {
        throw new \RuntimeException(
            "Cannot withdraw {$amount}: balance is only {$balance}."
        );
    }

    return $balance - $amount;
}
Ramener silencieusement le retrait au solde disponible, ou renvoyer 0 sans rien dire, cacherait un bug (ou pire, une vraie erreur financière) derrière un nombre plausible, exactement le défaut de l’exemple catch (\Error $e) d’il y a deux sections. Lancer force celui qui appelle withdraw() à regarder la situation en face au lieu de la laisser filer.
Laisser planter quand c’est un bug, pas un cas
Parfois, la bonne réponse n’est ni null ni un catch. C’est de laisser le programme s’arrêter. Si votre propre code appelle une fonction avec le mauvais type, ou atteint une branche de match qui devrait être impossible, ce n’est pas une situation à prévoir dans le design. C’est un bug à corriger, et faire comme si de rien n’était ne fait qu’enterrer les preuves :
<?php

declare(strict_types=1);

enum Status
{
    case Draft;
    case Published;
    case Archived;
}

function statusLabel(Status $status): string
{
    return match ($status) {
        Status::Draft => 'Draft',
        Status::Published => 'Published',
        Status::Archived => 'Archived',
    };
}
Un match sans branche default lance une UnhandledMatchError quand rien ne correspond, et UnhandledMatchError est une Error, pas une Exception. Avec un enum, chaque cas est couvert aujourd’hui, donc la seule façon de déclencher cela, c’est que quelqu’un ajoute plus tard un quatrième Status et oublie cette fonction. Essayez : ajoutez case Deleted; à l’énumération et appelez statusLabel(Status::Deleted). C’est exactement l’échec que vous voulez bruyant et immédiat, à la ligne du bug, pas avalé trois fichiers plus loin. Ne l’enveloppez pas dans un try « au cas où ». Laissez échouer, laissez la trace d’appels pointer la branche manquante, et allez corriger statusLabel().
Un ordre de décision approximatif
Quand vous hésitez entre les trois, posez-vous les questions dans cet ordre.
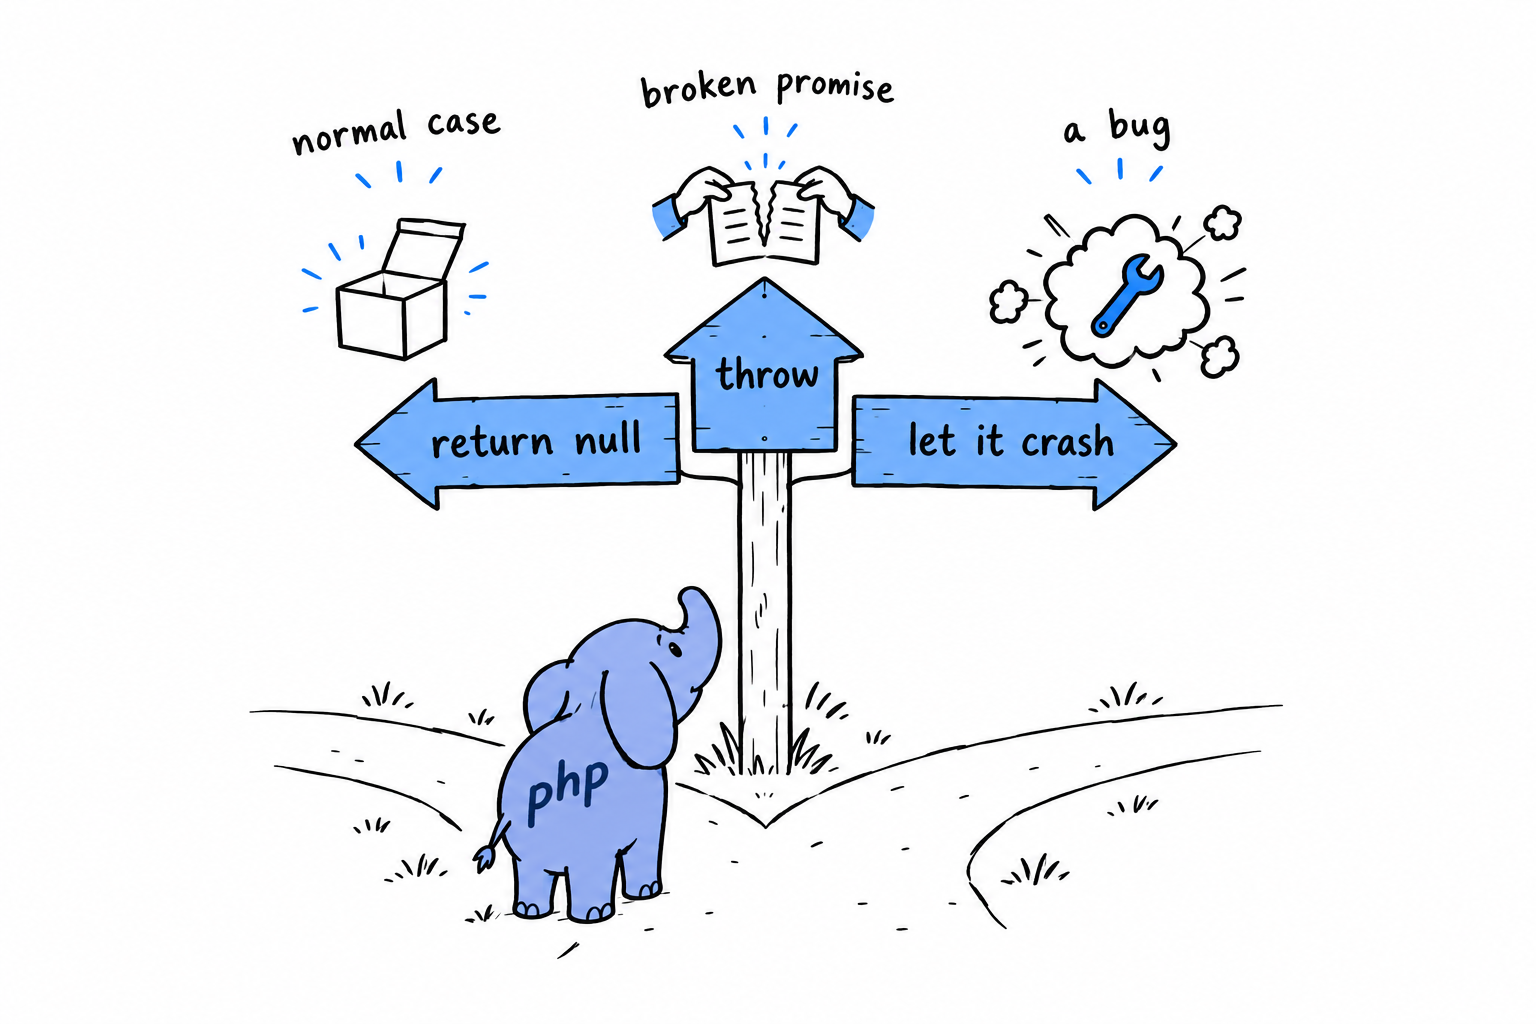
- « Introuvable » ou « vide » est-il ici une issue normale, attendue ? Renvoyez
null,falseou un tableau vide, et donnez à la fonction un type de retour qui montre cette possibilité (?array, pasarray). - L’appelant a-t-il rompu une précondition, sans valeur par défaut raisonnable ? Lancez une exception précise : une exception intégrée si elle convient (
InvalidArgumentException,RuntimeException), une petite classe sur mesure si l’appelant a besoin de contexte structuré en retour, comme avecInvalidAgeException. - Est-ce impossible, sauf si le code lui-même est faux ? Ne vous en défendez pas du tout. Laissez la mécanique
Errorde PHP faire son travail, ou utilisezassert()pendant le développement. Un échec bruyant à l’endroit du bug coûte bien moins cher qu’un échec silencieux trois couches decatchplus loin.
Rien de tout cela ne s’applique mécaniquement. Beaucoup de code réel vit dans la zone grise entre « attendu » et « précondition rompue », et des développeurs raisonnables ne tranchent pas tous pareil. Mais poser la question à voix haute, fonction par fonction, vaut mieux que de garder celui des deux, throw ou return null, que vos doigts ont tapé en premier. Vous prendrez cette décision dans presque chaque fonction que vous écrirez désormais, à commencer par plusieurs dans l’outil en ligne de commande du chapitre 14.
Les bases du développement web
Ouvrez un navigateur, tapez une adresse, appuyez sur Entrée. Quelque part, un script PHP se réveille, lit ce que votre navigateur a demandé, construit une page et la renvoie. Jusqu’ici, tous les programmes de ce livre tournaient dans un terminal : vous tapiez quelque chose, la réponse s’affichait sur la ligne suivante. Sur le web, ce que vous tapez est une requête HTTP, et la réponse est une page HTML. Le langage est le même. Seules l’entrée et la sortie changent.
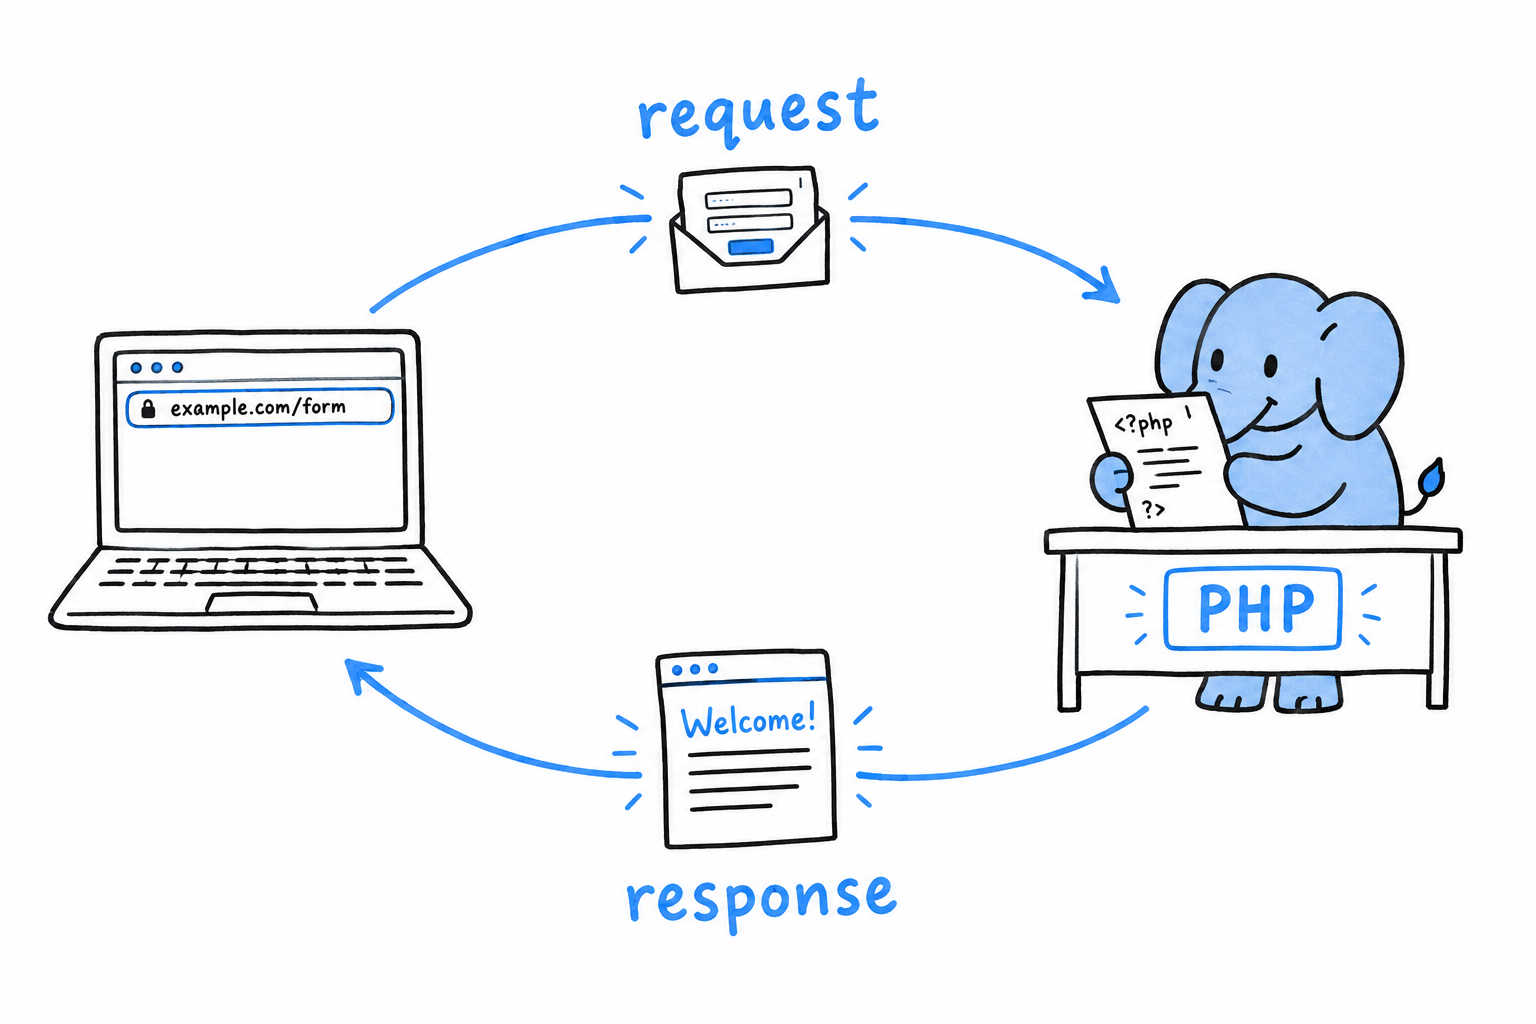
Ce chapitre construit un livre d’or : une page avec un formulaire, un nom et un message, et un script qui lit ce qui a été envoyé, le vérifie, le range, puis affiche tout ce que les visiteurs ont écrit jusque-là. Trois sections, trois couches. D’abord, faire entrer les données du formulaire dans votre script, par les tableaux que PHP remplit pour vous avant même que votre code démarre. Ensuite, s’assurer que ce que vous renvoyez ne permet pas à un visiteur d’en attaquer un autre. Enfin, conserver les messages d’une requête à l’autre, dans une vraie base de données, au lieu de les perdre dès que la réponse est partie.
Rien de tout cela n’aura l’air impressionnant, et c’est voulu. Pas de framework JavaScript, pas de framework CSS, pas d’étape de build : un seul <form> HTML, quelques lignes de style, PHP pour le reste, servi par php -S, le serveur de développement intégré que le projet final du livre utilise lui aussi. La leçon porte sur ce que PHP fait d’une requête, pas sur la configuration d’un bundler.
Tout ce qui suit resservira dans le projet final : lire $_SERVER, échapper la sortie avant qu’elle n’atteigne le HTML, stocker des données sans danger. C’est la matière ordinaire du PHP sur le web, et elle mérite d’être vue pour elle-même, dans la plus petite forme qui ait un sens, avant qu’un routeur et une hiérarchie de classes ne poussent autour.
Recevoir des données avec les formulaires HTML et les superglobales
PHP n’a aucune syntaxe particulière pour dire « ce script est une page web ». Un script web est un script ordinaire. Ce qui change, c’est d’où viennent ses données : avant même votre première ligne, PHP a déjà déballé la requête dans une poignée de tableaux, et votre code les lit comme n’importe quel autre tableau. On les appelle superglobales parce qu’elles sont accessibles partout, y compris à l’intérieur des fonctions, sans mot-clé global et sans paramètre. Elles sont là, c’est tout.
Un formulaire HTML tout simple
Commencez par le formulaire lui-même. Créez guestbook.php :
<!DOCTYPE html>
<html>
<head>
    <title>Guestbook</title>
    <style>
        body { font-family: sans-serif; max-width: 40em; margin: 2em auto; }
        textarea { width: 100%; }
    </style>
</head>
<body>
    <h1>Guestbook</h1>

    <form method="post">
        <p><label>Name: <input type="text" name="name"></label></p>
        <p><label>Message: <textarea name="message"></textarea></label></p>
        <p><button type="submit">Sign the guestbook</button></p>
    </form>
</body>
</html>
Il n’y a pas encore une ligne de PHP. C’est un <form> avec method="post" et sans attribut action, donc l’envoyer déclenche une requête POST vers cette même URL. L’autre choix courant est method="get", et la différence compte. Une requête GET écrit ses données dans l’URL (?name=Alice), visibles dans la barre d’adresse et dans les journaux du serveur : très bien pour un champ de recherche, mauvais pour tout ce qui est privé, et mauvais pour tout ce qui modifie des données. Une requête POST transporte ses données dans le corps de la requête, à l’abri des regards. Une entrée de livre d’or a sa place là.
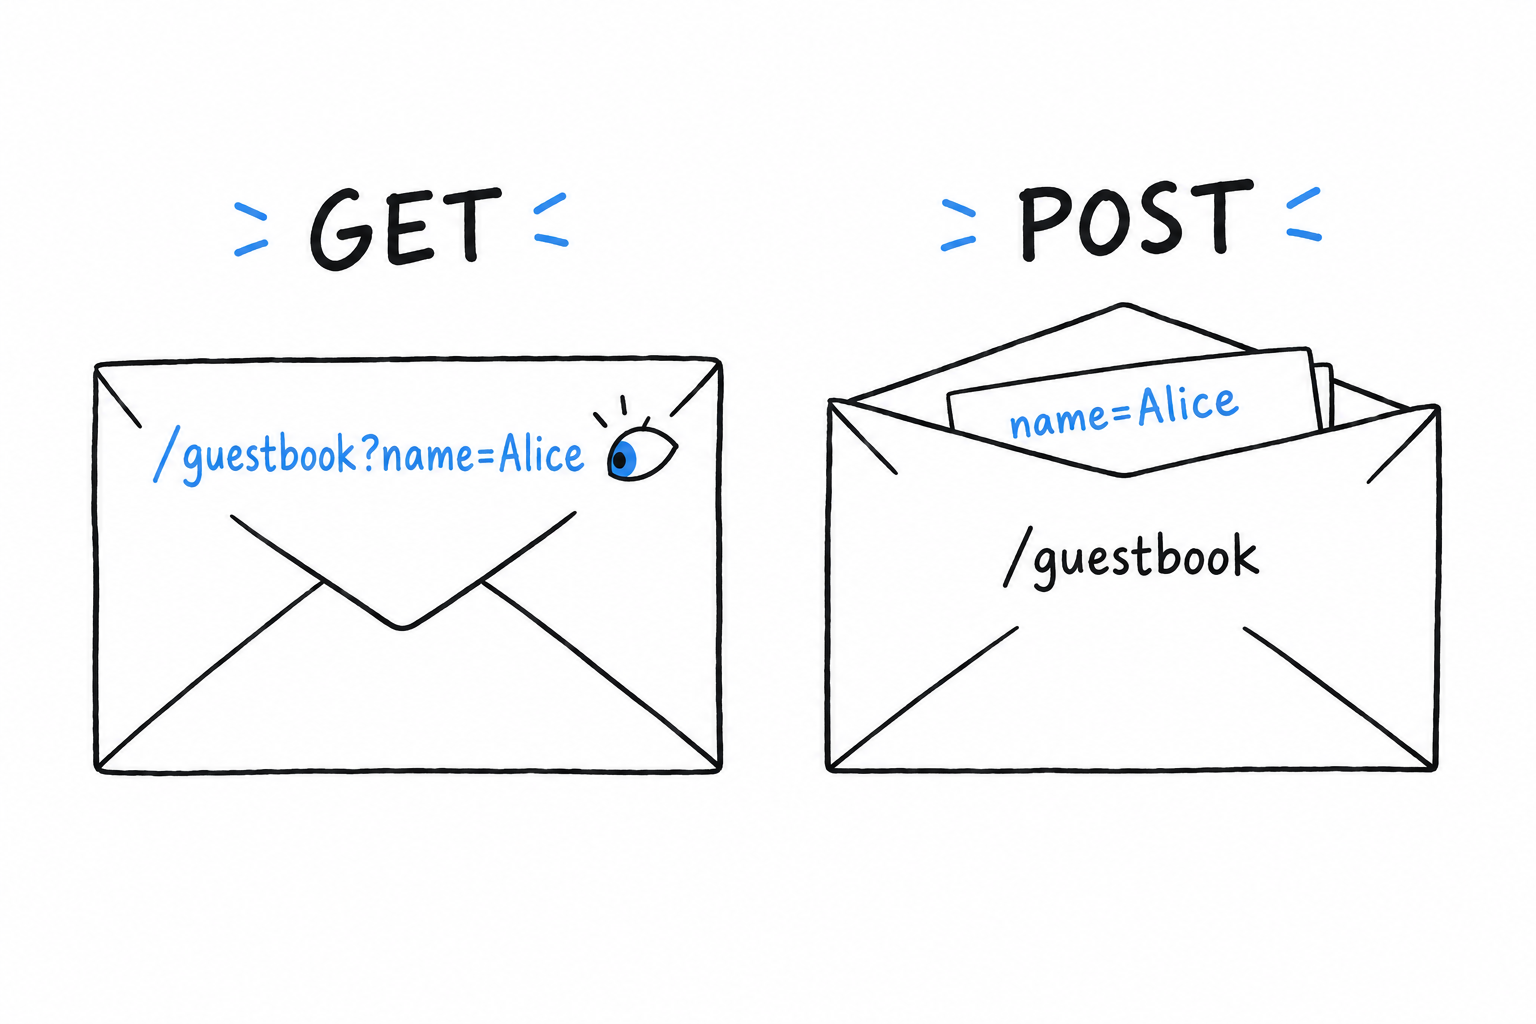
Servez-le avec le serveur de développement intégré de PHP :
$ php -S localhost:8000
Ouvrez http://localhost:8000 : le formulaire s’affiche. Remplissez-le, envoyez-le, et il ne se passe rien. La même page se recharge, et ce que vous avez tapé a disparu. Lire ce qui a été envoyé, c’est le travail de PHP, et personne ne le lui a encore demandé.
Les superglobales : $_GET, $_POST, $_SERVER
Trois d’entre elles comptent pour un script comme celui-ci. $_POST contient les champs du formulaire envoyés dans le corps d’une requête POST, sous forme de tableau associatif, une clé par nom de champ. $_GET contient les paramètres de la chaîne de requête, la partie de l’URL après le ? ; il est rempli pour toute requête, mais par convention on le lit sur les requêtes GET. $_SERVER décrit la requête et le serveur lui-même, et une seule de ses entrées fait presque tout le travail ici : $_SERVER['REQUEST_METHOD'], qui vaut 'GET' ou 'POST', permet à un seul script d’afficher un formulaire vide et de traiter un formulaire envoyé.
Il existe aussi $_REQUEST, qui fusionne $_GET, $_POST et les cookies en un seul tableau. C’est pratique, et il vaut mieux s’en passer : avec lui, votre script ne sait plus si une valeur est arrivée par l’URL ou par le corps de la requête, et cette distinction pèse plus qu’il n’y paraît dès que la sécurité entre en jeu, à la section suivante.
Lire ce qui a été envoyé
Ajoutez du PHP en tête de guestbook.php, avant la ligne <!DOCTYPE html> :
<?php

$name = '';
$message = '';
$submitted = false;

if ($_SERVER['REQUEST_METHOD'] === 'POST') {
    $name = $_POST['name'] ?? '';
    $message = $_POST['message'] ?? '';
    $submitted = true;
}
?>
Le if, c’est le script qui demande « un formulaire a-t-il été envoyé, ou quelqu’un regarde-t-il seulement ? ». L’opérateur de fusion null ?? (vu au chapitre 3) couvre le cas d’un champ absent : une requête forgée à la main ne doit pas provoquer un avertissement « undefined array key ». Plus bas dans le fichier, affichez le message quand il y en a un :
<body>
    <h1>Guestbook</h1>

    <?php if ($submitted) { ?>
        <p>Thanks, <?= $name ?>. You wrote: <?= $message ?></p>
    <?php } ?>

    <form method="post">
<?= $name ?> est un raccourci pour <?php echo $name ?>, fait exactement pour ça : glisser une valeur au milieu du HTML. Rechargez, remplissez le formulaire, envoyez. La page vous salue avec exactement ce que vous avez tapé. Pour voir la requête elle-même, sans navigateur, essayez curl :
$ curl -X POST -d "name=Alice&message=Hello there" http://localhost:8000/
La réponse contient Thanks, Alice. You wrote: Hello there. Même salutation, construite entièrement à partir de $_POST, et le navigateur s’est révélé facultatif. Tout ce qui sait envoyer une requête HTTP peut remplir votre formulaire.
Un formulaire, c’est une requête avec des données dedans. PHP les déballe dans
$_POSTavant que votre code démarre.
Le problème qu’on voit déjà venir
Ce <?= ?> imprime $name et $message tels quels dans la page, sans aucun filtre. Essayez : envoyez <b>bold</b> comme nom. La page affiche votre nom en gras, pas avec des chevrons. Le livre d’or exécute pour l’instant n’importe quel HTML tapé par un visiteur, pas seulement le vôtre. La section suivante referme cette brèche, avant que quoi que ce soit ne soit rangé quelque part pour de bon.
Valider les entrées et prévenir le cross-site scripting
Envoyez <script>alert('hello from your own guestbook')</script> comme message. Le navigateur l’exécute. Un livre d’or qui imprime les valeurs de $_POST directement dans le HTML laisse n’importe quel visiteur poser n’importe quel balisage sur la page, et le balisage inclut les scripts. C’est le cross-site scripting, XSS pour faire court : un attaquant fait tourner son propre JavaScript dans votre page, dans le navigateur de vos visiteurs, avec la confiance de votre site derrière lui. Un livre d’or qui enregistre des messages et les montre à tout le monde est le cas d’école, ce qui en fait le bon endroit pour apprendre à s’en protéger.
Échapper la sortie
Le remède n’est pas d’interdire les chevrons. C’est de s’assurer que tout texte venu d’un utilisateur est échappé avant d’atterrir dans le HTML, pour que le navigateur l’affiche comme du texte au lieu de le lire comme du balisage. L’outil de PHP pour ça s’appelle htmlspecialchars(). Il convertit les quelques caractères qui intéressent un analyseur HTML (<, >, & et les guillemets) en leurs entités (<, >, & et ainsi de suite), que le navigateur affiche comme les caractères d’origine sans agir dessus :
<?php if ($submitted) { ?>
    <p>Thanks, <?= htmlspecialchars($name) ?>. You wrote: <?= htmlspecialchars($message) ?></p>
<?php } ?>
Renvoyez le message <script>. La page affiche maintenant le texte littéral <script>alert('hello from your own guestbook')</script>, et rien ne s’exécute. Depuis PHP 8.1, htmlspecialchars() échappe par défaut les guillemets en plus des chevrons, ce qu’on veut presque à chaque fois.
La règle tient en une phrase. Toute valeur venue de l’extérieur de votre script, imprimée n’importe où dans du HTML, passe d’abord par htmlspecialchars(). Pas d’exception pour les valeurs « probablement » inoffensives : un champ nom a l’air anodin jusqu’au jour où quelqu’un y glisse une balise <script>.
Échappez à la sortie. Chaque valeur, à chaque fois.
Valider avant de faire confiance aux données
L’échappement protège la sortie. La validation est une autre question : cette entrée est-elle seulement acceptable ? Un nom de deux mille caractères, ou un message fait uniquement d’espaces, n’est pas dangereux, juste faux, et le script doit le dire avant d’en faire quoi que ce soit. Étendez le traitement du formulaire pour repérer les problèmes et les collecter :
<?php

$name = '';
$message = '';
$submitted = false;
$errors = [];

if ($_SERVER['REQUEST_METHOD'] === 'POST') {
    $name = trim($_POST['name'] ?? '');
    $message = trim($_POST['message'] ?? '');
    $submitted = true;

    if ($name === '') {
        $errors[] = 'Name cannot be empty.';
    } elseif (mb_strlen($name) > 60) {
        $errors[] = 'Name is too long.';
    }

    if ($message === '') {
        $errors[] = 'Message cannot be empty.';
    } elseif (mb_strlen($message) > 500) {
        $errors[] = 'Message is too long.';
    }
}
?>
trim() retire les espaces aux deux bouts, si bien qu’un message fait uniquement d’espaces ne passe pas le test du vide. mb_strlen() plutôt que strlen() compte des caractères et non des octets, ce qui importe dès qu’un nom contient autre chose que de l’ASCII pur, la même question d’UTF-8 que le chapitre 8 a traitée pour les chaînes en général. Et les erreurs s’accumulent dans un tableau au lieu d’arrêter tout à la première, pour que le visiteur voie tous les problèmes d’un coup plutôt que de les découvrir un envoi après l’autre.
Affichez les erreurs, et remettez les valeurs envoyées dans le formulaire (échappées, comme toujours), pour que personne n’ait à retaper un long message parce que son nom était trop court :
<?php if ($errors) { ?>
    <ul>
        <?php foreach ($errors as $error) { ?>
            <li><?= htmlspecialchars($error) ?></li>
        <?php } ?>
    </ul>
<?php } elseif ($submitted) { ?>
    <p>Thanks, <?= htmlspecialchars($name) ?>. You wrote: <?= htmlspecialchars($message) ?></p>
<?php } ?>

<form method="post">
    <p><label>Name: <input type="text" name="name" value="<?= htmlspecialchars($name) ?>"></label></p>
    <p><label>Message: <textarea name="message"><?= htmlspecialchars($message) ?></textarea></label></p>
    <p><button type="submit">Sign the guestbook</button></p>
</form>
Regardez value="<?= htmlspecialchars($name) ?>" dans la balise <input>. L’échappement compte autant à l’intérieur d’un attribut HTML que dans le corps de la page : un " non échappé dans la valeur permettrait à un visiteur de fermer l’attribut avant l’heure et d’écrire le sien.
Un risque voisin qu’il faut nommer
Le XSS, c’est le navigateur d’un visiteur qui exécute le script d’un attaquant dans votre page. Son cousin s’appelle CSRF, cross-site request forgery : un autre site pousse le navigateur d’un visiteur à envoyer un formulaire à votre site en son nom, avec la session dans laquelle il est déjà connecté. La parade habituelle, un jeton caché généré par formulaire et vérifié à l’envoi, dépasse ce dont ce petit livre d’or a besoin. Gardez le nom en mémoire pour le jour où vous construirez quelque chose où un envoi forgé coûterait vraiment.
Le livre d’or se tient bien, le temps d’une requête : il valide ce qui entre et échappe ce qui sort. Ce qu’il ne sait toujours pas faire, c’est se souvenir. Rechargez la page et chaque message disparaît, parce que rien n’a jamais été rangé nulle part. C’est la suite.
Parler à une base de données avec PDO
Signez le livre d’or, rechargez la page, et votre message a disparu. Ce n’est pas un bug. PHP, dans sa forme classique et toujours la plus répandue, offre à chaque requête un départ à neuf : il exécute le script depuis le haut et jette tout une fois la réponse envoyée, variables comprises. Rien ne survit d’une requête à la suivante, sauf ce qu’on a pris soin de ranger quelque part, et jusqu’ici, rien ne l’a été. Pour qu’un message survive à la requête qui l’a envoyé, il doit vivre quelque part où PHP pourra le relire plus tard : une base de données. (Le chapitre 18 revient posément sur ce modèle de requête sans mémoire partagée, et sur les raisons qui font que PHP a rarement besoin de threads.)
PDO et SQLite
PHP parle aux bases de données par plusieurs extensions. PDO, pour PHP Data Objects, est celle vers laquelle se tourner en premier : elle offre une seule interface pour de nombreux moteurs, si bien que le même code fonctionne que les données soient dans MySQL, PostgreSQL ou, comme ici, SQLite. SQLite range une base de données entière dans un seul fichier ordinaire. Aucun serveur à installer, rien à configurer, ce qui garde la technologie autour de ce chapitre aussi simple que le PHP qu’il contient.
Ouvrez une connexion en tête de guestbook.php :
<?php

$pdo = new PDO('sqlite:' . __DIR__ . '/guestbook.db');
$pdo->setAttribute(PDO::ATTR_ERRMODE, PDO::ERRMODE_EXCEPTION);

$pdo->exec('
    CREATE TABLE IF NOT EXISTS entries (
        id INTEGER PRIMARY KEY AUTOINCREMENT,
        name TEXT NOT NULL,
        message TEXT NOT NULL,
        created_at TEXT NOT NULL
    )
');
La chaîne 'sqlite:' . __DIR__ . '/guestbook.db' est un DSN, un data source name : quel pilote utiliser, et où se trouve la base. Le fichier est créé à la première exécution s’il n’existe pas encore. CREATE TABLE IF NOT EXISTS peut rester dans le script et tourner à chaque requête sans risque, puisqu’il ne fait rien une fois la table en place.
La deuxième ligne mérite de devenir un réflexe. Mettez PDO::ATTR_ERRMODE à PDO::ERRMODE_EXCEPTION chaque fois que vous ouvrez une connexion. Sans cela, PDO peut échouer en silence et vous rendre un simple false, exactement le genre d’échec discret contre lequel le chapitre 9 vous a mis en garde. Avec, une mauvaise requête lève une PDOException, à attraper comme n’importe quelle autre.
La mauvaise façon de construire une requête
Avant d’écrire l’insertion, regardez la version à éviter :
// Don't do this.
$pdo->exec("INSERT INTO entries (name, message, created_at) VALUES ('$name', '$message', '" . date('c') . "')");
Lisez la requête comme la base de données la lira. Si $message contient une apostrophe suivie du SQL de son choix, cette apostrophe ferme la chaîne avant l’heure et la suite fait partie de ce qui s’exécute vraiment. C’est l’injection SQL, de la même famille que le XSS de la section précédente, mais dirigée contre votre base de données plutôt que contre le navigateur d’un visiteur. Construire une requête en collant du texte non fiable dans une chaîne n’est jamais sûr, si soigneusement assemblée qu’elle paraisse.
Les requêtes préparées
La réponse de PDO, c’est la requête préparée. La requête part d’abord vers la base, avec des marqueurs à la place des valeurs, et les valeurs voyagent séparément ensuite. La base ne lit jamais une valeur comme un morceau de la syntaxe de la requête, donc il n’y a aucune chaîne d’où s’échapper, et l’injection est fermée pour de bon :
if ($submitted && !$errors) {
    $statement = $pdo->prepare(
        'INSERT INTO entries (name, message, created_at) VALUES (:name, :message, :created_at)'
    );
    $statement->execute([
        'name' => $name,
        'message' => $message,
        'created_at' => date('c'),
    ]);
}
:name, :message et :created_at sont des marqueurs nommés. prepare() envoie la forme de la requête une fois ; execute() l’exécute avec un jeu de valeurs, donné sous forme de tableau associatif avec une clé par marqueur. PDO s’occupe des guillemets pour le moteur qui se trouve dessous, et c’est précisément la partie qu’on rate facilement à la main.
La requête, c’est la phrase. Les valeurs sont remplies après coup, et ne peuvent jamais changer la phrase.
Relire ce qui a été écrit
Relire les entrées suit la même forme prepare() puis execute(), ou, pour une requête sans valeur à insérer, le plus simple query() :
$entries = $pdo->query('SELECT name, message, created_at FROM entries ORDER BY id DESC')
    ->fetchAll(PDO::FETCH_ASSOC);
fetchAll(PDO::FETCH_ASSOC) renvoie chaque ligne sous forme de tableau associatif indexé par nom de colonne, le tout dans un tableau ordinaire : la même forme de données que le chapitre 8 vous a appris à manipuler. Parcourez-le dans le HTML, en échappant chaque valeur exactement comme avant :
<h2>Previous entries</h2>
<ul>
    <?php foreach ($entries as $entry) { ?>
        <li>
            <strong><?= htmlspecialchars($entry['name']) ?></strong>:
            <?= htmlspecialchars($entry['message']) ?>
            <em>(<?= htmlspecialchars($entry['created_at']) ?>)</em>
        </li>
    <?php } ?>
</ul>
L’échappement s’applique toujours, pour la même raison qu’avant. Ces valeurs viennent d’un visiteur, en passant par la base, et la base ne sait pas, et ne cherche pas à savoir, si elles peuvent s’afficher en HTML sans danger. Ranger une valeur sans risque et l’afficher sans risque sont deux travaux distincts, et en sauter un rouvre la brèche que la section précédente a refermée.
Ce que vous avez construit
Rechargez le livre d’or, signez-le plusieurs fois, puis arrêtez php -S et relancez-le. Les entrées sont toujours là. Elles n’ont jamais vécu en mémoire ; elles vivent dans guestbook.db, sur le disque, indépendantes de toute requête. C’est la silhouette complète d’une vraie application web, si petite soit-elle : recevoir les données par les superglobales, les valider, les échapper à la sortie, les ranger par des requêtes préparées. Le projet final du livre construit quelque chose de plus grand sur la même fondation, avec plus de routes, des classes contrôleur et une vraie couche de vues, et rien ne change dans les idées de fond. Vous avez déjà fait la partie qui compte.
Interfaces, traits et code de style générique
Une classe, c’est facile. Les ennuis commencent avec la deuxième.
Deux classes qui n’ont rien à voir l’une avec l’autre doivent quand même se mettre d’accord sur certaines choses. Votre ligne de facture et vos frais de port ont tous deux un résumé à afficher. Votre processeur de paiement et votre générateur de rapports veulent tous deux écrire une ligne dans un journal. Comment des classes sans lien s’entendent-elles pour travailler ensemble, et comment partager une méthode entre elles sans la retaper cinq fois ? PHP répond avec deux outils, et chacun règle une moitié opposée de la question.
Une interface est un contrat. Elle dit « toute classe qui se réclame de ce nom promet d’avoir ces méthodes », et ne dit rien du tout sur la façon dont ces méthodes sont écrites. Un trait, c’est l’inverse : un vrai morceau d’implémentation, copié dans toutes les classes qui le demandent, sans aucune promesse sur ce que sont ces classes ni sur leurs liens de parenté. L’un est une forme dans laquelle vous acceptez de rentrer. L’autre est un bout de code que vous empruntez. Les débutants les confondent, et bon nombre de développeurs aguerris venus d’autres langages aussi, d’où cette distinction posée aussi crûment, aussi tôt.
Il y a un troisième sujet dans ce chapitre, et il demande un peu de franchise. PHP n’a pas de génériques. Vous ne pouvez pas écrire Collection<Product> et compter sur le langage pour refuser qu’une Banana s’y glisse. Ce que PHP a à la place, c’est une convention bien rodée, des docblocks lus par un outil d’analyse statique, qui vous offre l’essentiel de la même sécurité. La vérification est faite par un programme à part, que vous lancez avant de livrer, et non par PHP lui-même.
Les interfaces d’abord, parce que vous les utiliserez bien plus souvent que les deux autres.
Définir un comportement commun avec les interfaces
Supposons que vous deviez afficher le résumé lisible d’un objet : une ligne de facture, un produit, une entrée de journal, ce que la semaine vous apporte. Vous pourriez donner à chaque classe une méthode describe() et espérer que tout le monde retienne le nom. Ou vous pourriez en faire une règle que PHP lui-même vérifie. C’est à ça que sert une interface.
<?php

interface Formattable
{
    public function format(): string;
}
Une interface ressemble à une classe dont on aurait retiré tous les corps de méthode. format(): string est une signature, pas une implémentation : pas d’accolades, pas de logique, juste une promesse. Toute classe qui déclare implémenter Formattable doit avoir une méthode publique format() qui renvoie une chaîne, et PHP la tient à cette promesse. Oubliez la méthode, ou renvoyez le mauvais type, et le code ne s’exécute pas.
L’implémenter
Une classe s’engage avec implements :
<?php

readonly class Product
{
    public function __construct(
        public string $name,
        public float $price,
    ) {
    }
}

readonly class InvoiceLine implements Formattable
{
    public function __construct(
        private Product $product,
        private int $quantity,
    ) {
    }

    public function format(): string
    {
        $total = $this->product->price * $this->quantity;
        return sprintf('%dx %s, $%.2f', $this->quantity, $this->product->name, $total);
    }
}
InvoiceLine implements Formattable est une affirmation que PHP vérifie pour vous. Si format() manquait, ou était déclarée comme renvoyant un int, vous auriez une erreur fatale à l’instant où PHP charge la classe, pas trois appels plus loin, en production. Essayez : renommez format() en describe() et lancez le fichier.
Une classe peut implémenter plusieurs interfaces, séparées par des virgules. C’est l’une des façons dont PHP compense le fait qu’une classe n’a qu’un seul parent.
Pourquoi s’embêter : programmer contre l’interface
Voici la partie qui rembourse l’effort. Écrivez une fonction qui type son paramètre avec l’interface, pas avec la classe concrète :
<?php

function printSummary(Formattable $item): void
{
    echo $item->format() . "\n";
}

printSummary(new InvoiceLine(new Product('Keyboard', 49.90), 2));
printSummary() ne sait pas qu’elle a reçu une InvoiceLine, et s’en moque. Elle sait qu’elle a reçu quelque chose qui sait se format(). Ajoutez demain une classe Refund, ou Discount, ou ShippingFee, implémentez Formattable dessus, et printSummary() n’a pas besoin de bouger d’une ligne. Elle fonctionne déjà, parce qu’elle n’a jamais été écrite pour une classe en particulier.
Une prise murale se moque de savoir si vous y branchez une lampe ou un ordinateur portable ; elle exige seulement que la fiche ait la bonne forme. Formattable est la forme, et printSummary() est la prise.
Les tests font monter les enjeux. Si printSummary() avait exigé une InvoiceLine, la tester seule voudrait dire construire une vraie InvoiceLine avec un vrai Product derrière. Avec Formattable, un test peut lui passer n’importe quel objet qui honore le contrat, y compris un faux fabriqué pour l’occasion, sans le moindre Product en vue. Le chapitre 12 s’en sert directement.
Typez sur le contrat, pas sur la classe. La fonction marche alors avec toutes les classes qui le signent, y compris celles que vous n’avez pas encore écrites.
instanceof
De temps en temps, vous devez demander, à l’exécution, si un objet satisfait une interface :
<?php

if ($item instanceof Formattable) {
    echo $item->format() . "\n";
}
Servez-vous-en rarement. Une pile de tests instanceof avant un appel de méthode signifie presque toujours que la méthode a sa place dans une interface sur laquelle vous devriez typer, et non qu’il vous faut davantage d’instanceof.
Une remarque sur les noms
PHP n’a aucune syntaxe particulière pour distinguer une interface « simple contrat » d’une interface plus structurelle. Formattable, Countable, Stringable, ArrayAccess sont toutes des interfaces ordinaires, certaines fournies par le langage, d’autres écrites par vous. La convention préfère un adjectif en -able pour un contrat à capacité unique (Formattable, Comparable, Sortable). PHP ne l’impose pas, mais le prochain lecteur vous en saura gré. Plusieurs interfaces natives de PHP font leur apparition au chapitre 20.
Réutiliser du code avec les traits
Une interface ne promet rien sur l’implémentation : c’est une forme pure. Un trait, ce sont de vrais corps de méthode que PHP colle dans une classe pour vous, comme si vous les y aviez tapés vous-même. Pas de contrat, pas de polymorphisme, pas de « ces classes sont interchangeables ». Du copier-coller, rendu officiel et rendu sûr par le langage.
Prenez deux classes qui n’ont rien en commun, un PaymentProcessor et un ReportGenerator, qui veulent toutes deux écrire quelque part des messages horodatés. Elles ne partagent aucune classe parente, et elles ne devraient pas : ce ne sont pas des choses de même nature. Mais elles veulent les mêmes quelques lignes de journalisation.
<?php

trait LoggableTrait
{
    private array $log = [];

    public function log(string $message): void
    {
        $this->log[] = sprintf('[%s] %s', date('H:i:s'), $message);
    }

    public function getLog(): array
    {
        return $this->log;
    }
}
trait ressemble à une classe, mais vous ne pourrez jamais écrire new LoggableTrait(). Un trait n’est pas un type. Il n’apparaît dans aucun test instanceof ni dans aucune déclaration de type. Il n’existe que pour être aspiré dans d’autres classes avec use :
<?php

class PaymentProcessor
{
    use LoggableTrait;

    public function charge(float $amount): void
    {
        $this->log("Charging \${$amount}");
    }
}

class ReportGenerator
{
    use LoggableTrait;

    public function generate(): void
    {
        $this->log('Generating monthly report');
    }
}

$processor = new PaymentProcessor();
$processor->charge(42.00);

var_dump($processor->getLog());
// array(1) { [0]=> string(...) "[14:32:01] Charging $42" }
PaymentProcessor et ReportGenerator ont maintenant tous deux une méthode log() qui fonctionne, une méthode getLog() et une propriété privée $log, et aucune des deux classes n’en a écrit une ligne. Une fois use LoggableTrait; en place, tout se passe exactement comme si vous aviez tapé ces trois membres dans le corps de la classe.
Ce qu’elles ne gagnent pas, c’est un lien de parenté. Demander $processor instanceof LoggableTrait ne vous mène nulle part : un trait donne un comportement, pas une identité. PaymentProcessor et ReportGenerator restent deux classes sans rapport qui partagent un peu de code, pas deux sœurs dans une hiérarchie de types.
Un trait donne du code à une classe, pas une identité.
Pourquoi pas simplement l’héritage ?
Parce que ces classes n’ont rien d’autre en commun. Forcer PaymentProcessor et ReportGenerator à étendre une classe LoggableBase partagée, dans le seul but d’obtenir une méthode log(), reviendrait à modéliser une relation qui n’existe pas. PHP ne donne d’ailleurs qu’un seul parent à chaque classe, et vous dépenseriez cette unique cartouche pour de la journalisation. Un trait esquive toute la question : pas « est un », mais « a ce comportement, emprunté ici ».
Conflits entre traits
Une classe peut use plusieurs traits à la fois. Si deux d’entre eux définissent une méthode du même nom, PHP ne devinera pas laquelle vous vouliez. Il lève une erreur fatale tant que vous n’avez pas tranché vous-même :
<?php

class Report
{
    use LoggableTrait, TimestampableTrait {
        LoggableTrait::log insteadof TimestampableTrait;
        TimestampableTrait::log as logTimestampOnly;
    }
}
insteadof désigne le gagnant. as donne un nouveau nom à la version du perdant au lieu de la jeter. Vous n’en aurez pas souvent besoin, la plupart des traits sont assez étroits pour que les collisions restent rares, mais connaître la syntaxe évite qu’une base de code qui l’utilise vous paraisse mystérieuse la première fois que vous la croisez.
Convention de nommage
Vous croiserez des traits nommés aussi bien Loggable que LoggableTrait. Ce livre ajoute le suffixe Trait pour les distinguer d’un coup d’œil des interfaces qui les accompagnent souvent. Associer une interface Loggable (le contrat : « cette classe sait journaliser ») à un LoggableTrait (l’implémentation partagée qui le remplit) est sans doute le meilleur usage des traits dans du vrai code. PHP n’impose ni l’une ni l’autre convention. Choisissez-en une par base de code et tenez-vous-y.
Interfaces et traits travaillent tous deux à l’échelle de la classe. Le prochain trou dans le système de types de PHP se trouve un étage plus bas, à l’intérieur du tableau, et celui-là, le langage vous le laisse.
Du code générique avec les docblocks et l’analyse statique
PHP n’a pas de génériques. Beaucoup de documentations tournent autour de cette phrase, alors la voici, sans détour. Dans un langage qui en a (le List<String> de Java, le Array<Product> de TypeScript), le compilateur refuse de laisser entrer le mauvais type dans un conteneur typé. Le système de types de PHP s’arrête à la frontière du tableau. Vous pouvez typer un paramètre array, mais « un tableau de quoi » est une question à laquelle le langage ne répondra jamais à l’exécution.
<?php

function totalPrice(array $products): float
{
    $total = 0.0;
    foreach ($products as $product) {
        $total += $product->price;
    }
    return $total;
}
Rien ne vous empêche d’appeler totalPrice([1, 2, 3]) ou totalPrice(['not', 'products']). PHP déroule la boucle sans broncher et explose sur $product->price dès qu’il tombe sur quelque chose qui n’a pas de propriété price. À l’exécution, en production si vous n’avez pas de chance, au lieu du moment où vous avez écrit le bug. Essayez : ajoutez totalPrice([1, 2, 3]); en bas du fichier et lisez ce que PHP vous répond.
Le contournement : des docblocks que les outils d’analyse statique comprennent
La réponse de l’écosystème PHP n’est pas une fonctionnalité du langage. C’est une convention. Vous écrivez ce que contient le tableau dans un commentaire docblock, et un outil à part, lancé avant de livrer, confronte cette promesse à l’usage réel du code.
<?php

/**
 * @param Product[] $products
 */
function totalPrice(array $products): float
{
    $total = 0.0;
    foreach ($products as $product) {
        $total += $product->price;
    }
    return $total;
}
@param Product[] $products ne veut rien dire pour l’interpréteur PHP. C’est un commentaire, et php totalPrice.php s’exécute à l’identique avec ou sans. En revanche, cela veut dire beaucoup pour PHPStan ou Psalm, les deux outils d’analyse statique qui dominent le monde PHP. Lancez l’un des deux sur ce fichier et il remonte chaque site d’appel. Si une autre fonction passe un tableau contenant un int, ou un Refund là où un Product était promis, l’analyseur le signale. La même famille d’erreurs qu’un compilateur à génériques attraperait, attrapée par un programme à part plutôt que par le langage.
Deux postes de contrôle jalonnent la route de la production. L’analyseur lit votre docblock et arrête tout ce qui ne correspond pas ; php lui-même laisse tout passer sans regarder. Seul le premier poste refuse une banane, et il n’existe que si vous l’avez installé.
Un docblock est une promesse. PHP l’ignore. L’analyseur vous y tient.
@template : au plus près des vrais génériques
Pour les structures vraiment génériques, disons une classe de collection capable de contenir n’importe quel type, mais un seul à la fois, les deux outils comprennent une annotation plus riche, calquée sur la façon dont les génériques s’écrivent dans d’autres langages :
<?php

/**
 * @template T
 */
final class TypedCollection
{
    /** @var T[] */
    private array $items = [];

    /**
     * @param T $item
     */
    public function add(mixed $item): void
    {
        $this->items[] = $item;
    }

    /**
     * @return T[]
     */
    public function all(): array
    {
        return $this->items;
    }
}
Avec l’annotation @var correspondante au point d’utilisation :
<?php

/** @var TypedCollection<Product> $products */
$products = new TypedCollection();
$products->add(new Product('Keyboard', 49.90));
PHPStan suit T comme étant Product pendant toute la vie de cette variable, et proteste dès que vous lui add() autre chose. Regardez la vraie signature : mixed. C’est ce que PHP voit et autorise à l’exécution, absolument n’importe quoi. L’annotation @template T est la couche du dessus, comprise seulement par l’analyseur, qui réduit mixed à un type précis tant que l’analyse statique regarde.
Ce que ça change pour vous
Rien dont il faille s’excuser. C’est ainsi que fonctionne le système de types de PHP aujourd’hui, et l’écosystème s’en est très bien accommodé. Les vrais projets lancent PHPStan ou Psalm comme étape obligatoire de leur intégration continue, souvent à un niveau strict, et traitent un docblock non respecté comme une erreur de compilation : la construction échoue. L’exécution reste permissive, par choix, une habitude aussi vieille que le langage, mais rien ne vous oblige à livrer du code que seule l’exécution a vérifié. Annotez chaque paramètre array dont le contenu compte, installez l’un des deux outils, et vous obtenez l’essentiel de ce qu’offre un langage à génériques, une étape plus tôt plutôt qu’à l’intérieur de php lui-même.
Écrire des tests automatisés
Jusqu’ici, vous avez vérifié chaque programme de ce livre de la même façon : vous le lancez, vous regardez la sortie, vous hochez la tête. Pour un jeu de devinette, ça suffit. Ça cesse de suffire le jour où votre projet compte trente fonctions et où vous modifiez une ligne, parce que la question n’est plus « cette ligne marche-t-elle ? » mais « qu’est-ce que je viens de casser d’autre ? », et cette réponse-là ne tient dans aucune tête.
Un test automatisé est une vérification que vous écrivez une fois et que l’ordinateur refait pour vous, à chaque fois, sans se lasser et sans oublier. Vous décrivez ce qu’un morceau de code doit faire, et PHP vous dit s’il le fait toujours. Mille exécutions plus tard, il est aussi attentif qu’à la première.
Pensez au détecteur de fumée de votre cuisine. Vous ne reniflez pas l’air toutes les minutes ; vous installez un appareil qui le fait, et il ne se manifeste qu’en cas de problème. Les tests jouent ce rôle pour votre code. Le silence veut dire que tout marche encore.
PHP a un outil par défaut pour ce travail, et un seul : PHPUnit. Il est le standard depuis près de vingt ans, presque toutes les bibliothèques et tous les frameworks du monde PHP l’utilisent en interne, et c’est un paquet Composer, qui s’installe comme vous l’avez appris au chapitre 7.
Un premier test tient en dix lignes, et vous écrirez le vôtre dans quelques minutes. Choisir lesquels lancer, puis garder de l’ordre quand ils se multiplient, demande un peu plus de réflexion, et c’est à cela que sert le reste du chapitre. À la fin, tester ne sera plus une étape collée après coup sur du code fini, mais une partie de la façon dont vous l’écrivez. C’est l’habitude sur laquelle s’appuie le chapitre 14 quand il construit un petit projet en écrivant les tests d’abord.
Un test, c’est une question que vous posez une fois à votre code. L’ordinateur continue de la poser à votre place.
Écrire des tests avec PHPUnit
Créez un projet vierge, comme au chapitre 7 :
$ composer init --no-interaction
$ composer require --dev phpunit/phpunit
L’option --dev compte. PHPUnit est un outil que vous utilisez pendant que vous construisez le projet, pas quelque chose dont le projet a besoin pour tourner. Composer garde les dépendances de développement à part pour cette raison : elles ne partent jamais en production.
Le code à tester
Voici une petite classe qui mérite un test, du genre de celles que vous écrivez depuis le chapitre 5 :
<?php
// src/Rectangle.php

declare(strict_types=1);

final class Rectangle
{
    public function __construct(
        private readonly float $width,
        private readonly float $height,
    ) {
    }

    public function area(): float
    {
        return $this->width * $this->height;
    }

    public function isSquare(): bool
    {
        return $this->width === $this->height;
    }
}
Rien de nouveau : une classe readonly, deux propriétés, deux méthodes. La question à laquelle un test répond est simple. Fait-elle vraiment ce qu’elle prétend ?
Votre premier test
Un test est une classe qui étend le TestCase de PHPUnit, avec des méthodes dont le nom commence par test. Chaque méthode met en place une situation, puis affirme quelque chose sur le résultat :
<?php
// tests/RectangleTest.php

declare(strict_types=1);

use PHPUnit\Framework\TestCase;

final class RectangleTest extends TestCase
{
    public function testAreaOfARectangle(): void
    {
        $rectangle = new Rectangle(8.0, 7.0);

        $this->assertEquals(56.0, $rectangle->area());
    }
}
Lisez la méthode comme une phrase : construire un rectangle de 8 sur 7, puis affirmer que son aire vaut 56. assertEquals(expected, actual) est l’affirmation. Si les deux valeurs diffèrent, le test échoue et PHPUnit vous montre les deux côtés. Lancez-le :
$ vendor/bin/phpunit tests
PHPUnit 10.5.0 by Sebastian Bergmann and contributors.

.                                                                   1 / 1 (100%)

Time: 00:00.012, Memory: 6.00 MB

OK (1 test, 1 assertion)
Un point par test réussi. C’est toute la boucle de travail jusqu’à la fin du chapitre : modifier le code, lancer les tests, compter les points.
Essayez : remplacez 56.0 par 57.0 et relancez. Le point devient un F, et PHPUnit vous dit quelle affirmation a cassé, avec la valeur attendue et la valeur obtenue.
Un test est une affirmation sur votre code. PHPUnit vérifie qu’elle tient toujours.
#[Test], l’alternative au préfixe test
Les attributs de PHP 8 (le chapitre 20 les traite pour de bon) donnent à PHPUnit une deuxième façon de marquer une méthode comme test, sans contrainte sur le nom :
<?php

use PHPUnit\Framework\Attributes\Test;
use PHPUnit\Framework\TestCase;

final class RectangleTest extends TestCase
{
    #[Test]
    public function itCalculatesArea(): void
    {
        $rectangle = new Rectangle(8.0, 7.0);

        $this->assertEquals(56.0, $rectangle->area());
    }
}
Les deux styles se valent ; choisissez-en un par projet et tenez-vous-y. Ce livre garde le préfixe test : pas de use à ajouter, et le nom dit tout seul ce qu’il est.
D’autres assertions : assertTrue, et assertEquals contre assertSame
<?php

final class RectangleTest extends TestCase
{
    public function testASquareIsDetected(): void
    {
        $square = new Rectangle(5.0, 5.0);

        $this->assertTrue($square->isSquare());
    }

    public function testEqualsVsSame(): void
    {
        $this->assertEquals(1, "1");   // passes, loose comparison, like ==
        $this->assertSame(1, "1");     // fails, strict comparison, like ===
    }
}
assertTrue() fait ce que son nom dit. La deuxième méthode est la plus intéressante, parce qu’une de ses deux lignes échoue.
assertEquals() compare comme ==, et assertSame() compare comme ===. C’est exactement la distinction du chapitre 3, déguisée en assertion. Pour assertEquals(), 1 et "1" sont assez égaux. assertSame() refuse : il vérifie le type et la valeur ensemble.
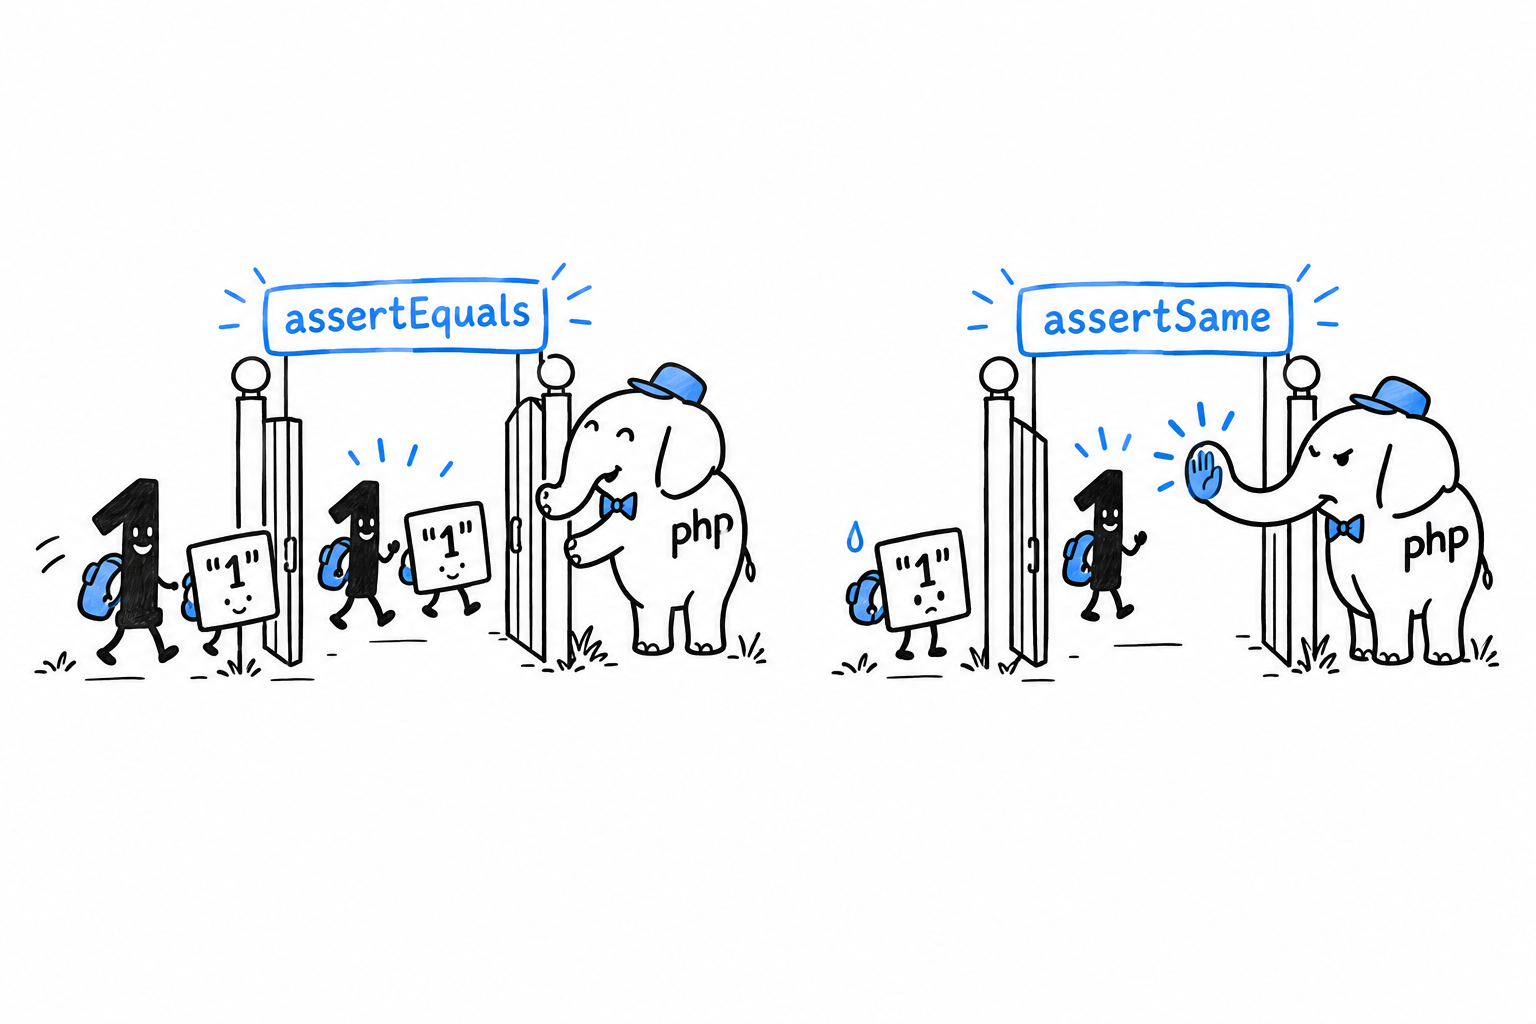
Prenez assertSame() par défaut. Il attrape toute une famille de bugs, une fonction qui renvoie une chaîne là où vous attendiez un entier, que assertEquals() laisse passer sans un mot. Ne revenez à assertEquals() que lorsque la comparaison souple est vraiment ce que vous voulez tester.
Une assertion qui échoue vous dit exactement ce qui a cloché :
$ vendor/bin/phpunit tests
1) RectangleTest::testEqualsVsSame
Failed asserting that 1 is identical to '1'.
Ce message travaille pour vous : « pas identique » plutôt que « différent » pointe droit sur le type. Lisez les messages d’échec de près ; PHPUnit est plus précis qu’il n’en a l’air.
Contrôler l’exécution des tests
vendor/bin/phpunit tests lance tout, à chaque fois. Avec cinq tests, très bien. Avec cinq cents, attendre la suite entière à chaque fichier enregistré devient pénible, et l’essentiel de la sortie parle de code auquel vous n’avez pas touché. PHPUnit sait ne lancer qu’une tranche de la suite, et un fichier de configuration rend le tout reproductible.
Filtrer par nom
--filter ne lance que les tests dont le nom correspond à un motif :
$ vendor/bin/phpunit --filter testAreaOfARectangle tests
Le motif est une expression régulière comparée au nom de la méthode, donc --filter Area attrape testAreaOfARectangle et tout ce qui contient « Area ». C’est le mode qu’il vous faut quand vous êtes plongé dans une fonctionnalité : lancer les deux ou trois tests qui comptent, et garder le reste pour plus tard.
Grouper les tests
Pour découper plus large qu’un test à la fois, étiquetez les tests avec un groupe, soit par l’ancienne annotation en docblock, soit par l’attribut moderne :
<?php

use PHPUnit\Framework\Attributes\Group;
use PHPUnit\Framework\TestCase;

final class RectangleTest extends TestCase
{
    #[Group('geometry')]
    public function testAreaOfARectangle(): void
    {
        $rectangle = new Rectangle(8.0, 7.0);

        $this->assertSame(56.0, $rectangle->area());
    }
}
Puis lancez seulement ce groupe :
$ vendor/bin/phpunit --group geometry tests
L’usage quotidien, c’est la vitesse. Marquez les tests lents (base de données, système de fichiers, réseau) avec #[Group('slow')] et tenez-les hors de votre boucle de travail avec --exclude-group slow. Le passage complet attend l’intégration continue, où quelques secondes de plus ne coûtent rien à personne.
phpunit.xml
Taper tests et se souvenir de ses options préférées à chaque lancement finit aussi par lasser. Un fichier phpunit.xml à la racine du projet règle ça, et PHPUnit le lit sans qu’on le lui demande :
<?xml version="1.0" encoding="UTF-8"?>
<phpunit bootstrap="vendor/autoload.php"
         colors="true">
    <testsuites>
        <testsuite name="default">
            <directory>tests</directory>
        </testsuite>
    </testsuites>
</phpunit>
Deux choses y vivent. bootstrap nomme le fichier que PHPUnit charge avant tout le reste, presque toujours l’autoloader de Composer, pour que vos tests puissent citer Rectangle sans require manuel. testsuites définit ce que « la suite » veut dire : ici, tout ce qui se trouve sous tests/. Une fois le fichier en place, la commande se réduit à sa forme la plus courte :
$ vendor/bin/phpunit
--filter et --group se posent toujours par-dessus quand vous voulez un passage plus étroit. Si vous préférez répondre à quelques questions plutôt qu’écrire du XML à la main, vendor/bin/phpunit --generate-configuration produit une première version. Dans les deux cas, committez le fichier. C’est de la configuration de projet, pas une préférence personnelle : toute l’équipe, et le pipeline d’intégration continue, doivent lancer la même suite de la même façon.
La suite est définie une fois, dans
phpunit.xml. Les options la rétrécissent pour l’instant présent.
Organiser ses tests
L’endroit où vivent les tests ne change rien pour PHPUnit et tout pour la personne qui les cherche, vous compris dans six mois. La convention PHP tient en une phrase : un dossier tests/ qui reflète src/, une classe de test par classe, nommée comme la classe suivie de Test.
src/
    Rectangle.php
    GrepOptions.php
tests/
    RectangleTest.php
    GrepOptionsTest.php
src/Rectangle.php a droit à tests/RectangleTest.php. src/Http/Client.php aurait tests/Http/ClientTest.php, les dossiers alignés des deux côtés. Rien n’impose cela : PHPUnit lance ce que phpunit.xml lui désigne, nommé comme bon vous semble. Mais presque tous les projets PHP suivent cette convention, et s’en écarter sans bonne raison ne fait que compliquer la vie de la prochaine personne qui ouvrira votre code. L’autoloading PSR-4 de Composer, vu au chapitre 7, associe en général un espace de noms Tests\ à tests/, de la même manière qu’il associe l’espace de noms de votre application à src/.
Tests unitaires et tests d’intégration
Un test unitaire exerce une classe ou une fonction seule, sans rien d’extérieur : pas de base de données, pas de système de fichiers, pas de réseau. RectangleTest en est un. Il construit un Rectangle et vérifie ses méthodes, rien de plus. Les tests unitaires sont rapides. Des milliers d’entre eux tournent en quelques secondes, et c’est précisément ce qui vous permet de lancer la suite entière à tout bout de champ sans qu’elle vous ralentisse.
Un test d’intégration vérifie que plusieurs pièces fonctionnent ensemble : votre code qui parle à une vraie base de données, à un vrai fichier sur le disque, à un autre service par un vrai appel HTTP. Il attrape une famille de bugs qu’un test unitaire ne peut structurellement pas voir, quand deux pièces sont chacune correcte de leur côté et se trompent l’une sur l’autre. Le prix, c’est la vitesse, souvent de plusieurs ordres de grandeur, et une tendance à échouer pour des raisons sans rapport avec votre code : un disque lent, un réseau qui hoquette.
<?php

use PHPUnit\Framework\TestCase;

final class FindMatchingLinesIntegrationTest extends TestCase
{
    public function testFindsLinesInARealFile(): void
    {
        $path = tempnam(sys_get_temp_dir(), 'lines');
        file_put_contents($path, "apple\nbanana\ncherry\n");

        $lines = findMatchingLines($path, 'banana');

        $this->assertSame(['banana'], $lines);

        unlink($path);
    }
}
Rien d’exotique ici. C’est toujours un TestCase, toujours plein d’assertions. Ce qui en fait un test d’intégration, c’est qu’il touche le vrai système de fichiers, en créant un vrai fichier temporaire puis en le supprimant, au lieu d’en simuler un. La différence est dans ce que le test touche, pas dans sa syntaxe.
Un partage pratique
La plupart des projets gardent les deux sortes dans le même dossier tests/ et les séparent par répertoire (tests/Unit/ et tests/Integration/) ou par groupe (l’attribut #[Group('integration')] de la section précédente). La suite unitaire, rapide, tourne alors sans arrêt pendant que vous travaillez, et la suite d’intégration, plus lente, attend un commit ou l’intégration continue. Aucune ne remplace l’autre. Les tests unitaires vous disent qu’une pièce marche seule ; les tests d’intégration vous disent que les pièces marchent encore une fois qu’elles se parlent, et c’est la seule façon dont votre programme tourne pour de vrai.
Déboguer du PHP
Tôt ou tard, un de vos programmes s’exécutera sans la moindre erreur et donnera quand même une mauvaise réponse. Pas d’exception, pas d’avertissement, juste un total décalé de un ou une page qui salue la mauvaise personne. Relire le code aide rarement, parce que le code dit exactement ce que vous vouliez dire. Déboguer, c’est découvrir ce que le programme fait vraiment, par opposition à ce que vous vouliez qu’il fasse. C’est une compétence à part entière, qui mérite d’être apprise exprès.
Jusqu’ici, chaque programme de ce livre était assez court pour se lire de haut en bas et repérer le bug à l’œil nu. Le jeu de devinette et le livre d’or ont déjà dépassé ce stade.
Il existe deux façons de regarder à l’intérieur d’un programme qui tourne, et vous aurez besoin des deux.
La première est le débogage par affichage, la plus vieille astuce du métier. Vous glissez au milieu de votre code quelque chose qui vous montre une valeur, vous relancez le programme, vous lisez la sortie. C’est une lampe torche : vous voyez le seul endroit où vous la pointez. Il ne faut rien d’autre que PHP, et var_dump() et print_r() sont les outils du genre.
La seconde est le débogage pas à pas. Vous mettez le programme en pause sur une ligne précise, vous regardez chaque variable telle qu’elle était à cet instant, et vous avancez une ligne à la fois. Un bouton pause plutôt qu’une lampe torche : plus besoin de deviner où regarder. Il faut un outil, Xdebug, et quelques minutes d’installation, remboursées dès le premier bug qui ne vous laisse aucune valeur évidente à afficher.
Aucune des deux ne remplace la gestion des erreurs du chapitre 9. Une exception bien placée vous dit que quelque chose a mal tourné. Le débogage sert à découvrir pourquoi, surtout quand rien n’a été levé et que le programme a simplement produit, sans bruit, une mauvaise réponse. L’outil en ligne de commande du chapitre 14 est exactement le genre de programme en plusieurs fichiers où les deux outils gagnent leur place.
Déboguer par affichage avec var_dump() et print_r()
echo $count affiche 5. Est-ce que $count contient le nombre cinq, ou le texte "5" ? echo ne vous le dira jamais, et cette différence est souvent tout le bug.
Vous avez croisé var_dump() brièvement au chapitre 3 : la fonction montre le type d’une valeur en même temps que la valeur elle-même. var_dump($count) affiche int(5) ou string(1) "5", et vous voilà fixé. C’est ce qui en fait un outil de débogage et pas seulement d’inspection : un bug, c’est très souvent une valeur du mauvais type, pas du mauvais contenu.
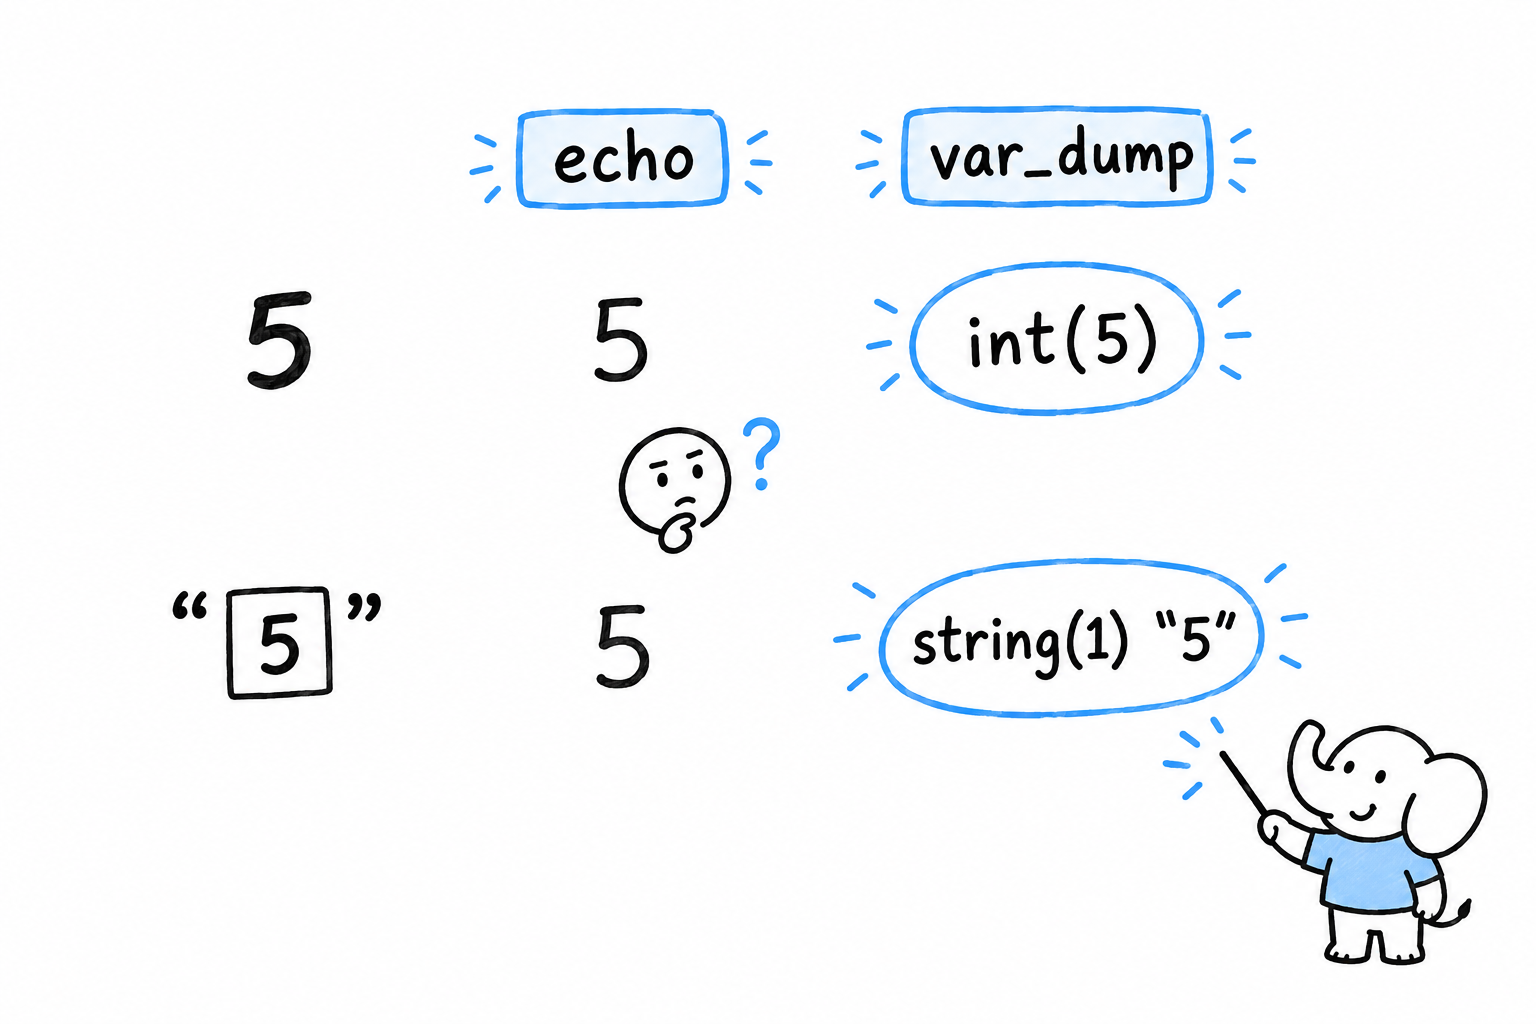
var_dump() sur des données structurées
var_dump() ne se limite pas à une valeur simple. Donnez-lui un tableau ou un objet, et il le parcourt en entier pour vous en montrer la forme :
<?php

$user = [
    'name' => 'Alice',
    'age' => '32',
    'active' => true,
    'roles' => ['admin', 'editor'],
];

var_dump($user);
array(4) {
  ["name"]=>
  string(5) "Alice"
  ["age"]=>
  string(2) "32"
  ["active"]=>
  bool(true)
  ["roles"]=>
  array(2) {
    [0]=>
    string(5) "admin"
    [1]=>
    string(6) "editor"
  }
}
Regardez "age" : il ressort en string(2) "32", pas en int(32). Si ce tableau vient d’un formulaire (le genre de données que le chapitre 10 lit dans $_POST), c’est attendu, parce que tout ce qui arrive dans $_POST est du texte. Le code plus bas qui suppose que $user['age'] est déjà un entier est un bug en attente. var_dump() attrape en quelques secondes ce qu’une mauvaise réponse silencieuse, trois fonctions plus loin, vous coûterait une heure à remonter.
Essayez : remplacez '32' par 32 dans le tableau et relancez le script. La ligne "age" devient int(32).
var_dump($name, $age, $roles) affiche les trois valeurs l’une après l’autre, en plus court que trois appels séparés.
print_r() : plus lisible, moins précis
print_r() montre la même structure sans les types, dans un format nettement plus facile à parcourir quand le tableau est grand :
<?php

print_r($user);
Array
(
    [name] => Alice
    [age] => 32
    [active] => 1
    [roles] => Array
        (
            [0] => admin
            [1] => editor
        )

)
Notez ce qui a disparu. true est devenu 1, et rien ne dit si 32 est un nombre ou du texte. C’est le compromis : prenez print_r() pour voir vite la forme de quelque chose, et var_dump() dès que le type exact d’une valeur est en question, ce qui est presque toujours le cas quand on traque un bug.
print_r() a un tour de plus dans son sac. Passez-lui true en second argument et il renvoie le texte formaté au lieu de l’afficher, ce qui permet d’envoyer un instantané vers un journal plutôt qu’à l’écran :
<?php

$snapshot = print_r($user, true);
error_log("user state: {$snapshot}");
Une troisième fonction, var_export(), se place entre les deux. Elle montre à peu près ce que montre print_r(), mais sous la forme de code PHP valide : var_export($user) affiche quelque chose que vous pourriez recoller tel quel dans un script comme littéral de tableau. Pratique pour capturer une vraie valeur et en faire une fixture de test.
Les limites de l’affichage
Les trois fonctions partagent la même faiblesse. Il faut déjà soupçonner où est le problème pour savoir où poser l’appel, et chaque fois que vous voulez regarder ailleurs, vous modifiez le fichier et relancez le programme. Pointer la lampe, regarder, la déplacer, regarder encore.
Pour un script de la taille de ceux du livre jusqu’ici, ça marche. Ça cesse de marcher quand un bug dépend de l’enchaînement exact de plusieurs appels de fonctions, ou n’apparaît qu’au cinquième tour d’une boucle, ou se cache dans une bibliothèque que vous préféreriez ne pas modifier. À ce stade, l’affichage n’a plus rien de chirurgical et devient du tâtonnement. Xdebug est l’outil de ce moment-là : il vous laisse mettre un script en pause et regarder autour de vous, au lieu de deviner à l’avance où pointer la lampe.
Déboguer pas à pas avec Xdebug
Imaginez appuyer sur pause dans votre programme, exactement sur la ligne qui vous intrigue, puis lire chaque variable telle qu’elle était à cet instant. C’est ce que Xdebug vous donne.
Xdebug n’est pas un programme à part, ni une fonction que vous appelez comme var_dump(). C’est une extension PHP : une fois installée, elle change le comportement de PHP lui-même. Cela demande un peu plus d’installation que la section précédente, en échange de la seule chose que l’affichage ne sait pas faire : regarder tout ce qui est à portée sans avoir deviné à l’avance quoi afficher.
L’installer
Xdebug n’est pas livré avec PHP, il faut donc l’installer séparément. La méthode générique passe par PECL :
$ pecl install xdebug
La plupart des gestionnaires de paquets le proposent aussi (apt install php-xdebug sur Debian et Ubuntu, brew install php puis pecl install xdebug sur macOS avec le PHP de Homebrew). Quelle que soit la voie choisie, il faut ensuite l’activer dans php.ini par une ligne qui ressemble à :
zend_extension=xdebug
Vérifiez qu’il est chargé :
$ php -v
PHP 8.3.0 (cli) (built: ...)
    with Xdebug v3.3.0, Copyright (c) 2002-2024, by Derick Rethans
Si le nom de Xdebug apparaît là, il est actif.
xdebug.mode : n’allumer que ce qu’il faut
Xdebug fait plusieurs choses sans rapport entre elles, et un seul réglage, xdebug.mode, dit lesquelles sont allumées. Il prend une liste séparée par des virgules dans php.ini :
xdebug.mode=develop,debug
develop mérite de rester allumé en permanence. Il ne demande aucun autre outil et améliore discrètement des sorties que vous produisez déjà : var_dump() affiche en couleur et indique le fichier et la ligne d’où il a été appelé, et une exception non rattrapée vient avec une trace complète, arguments compris, au lieu du format plus sec de PHP. debug est le mode dont parle cette section : il permet à un outil extérieur de mettre l’exécution en pause et de l’inspecter.
Brancher un éditeur
Le débogage pas à pas fait dialoguer deux bouts. D’un côté, PHP exécute votre script. De l’autre, un éditeur attend que PHP lui dise « je suis en pause, viens voir ». PhpStorm et VS Code (avec l’extension « PHP Debug ») savent le faire d’office, par un protocole nommé DBGp, sur le port 9003 par défaut.
La mise en place a la même forme dans les deux éditeurs. Vous lui demandez d’écouter les connexions Xdebug. Vous cliquez dans la marge à côté d’une ligne de code, et un point rouge apparaît : un point d’arrêt, qui veut dire « pause ici ». Puis vous lancez le script, depuis le terminal avec php your_script.php ou en rechargeant une page servie par php -S, avec xdebug.mode contenant debug. L’exécution s’arrête à l’instant où elle atteint cette ligne, avant de l’exécuter, et l’éditeur montre chaque variable à portée à ce point précis.
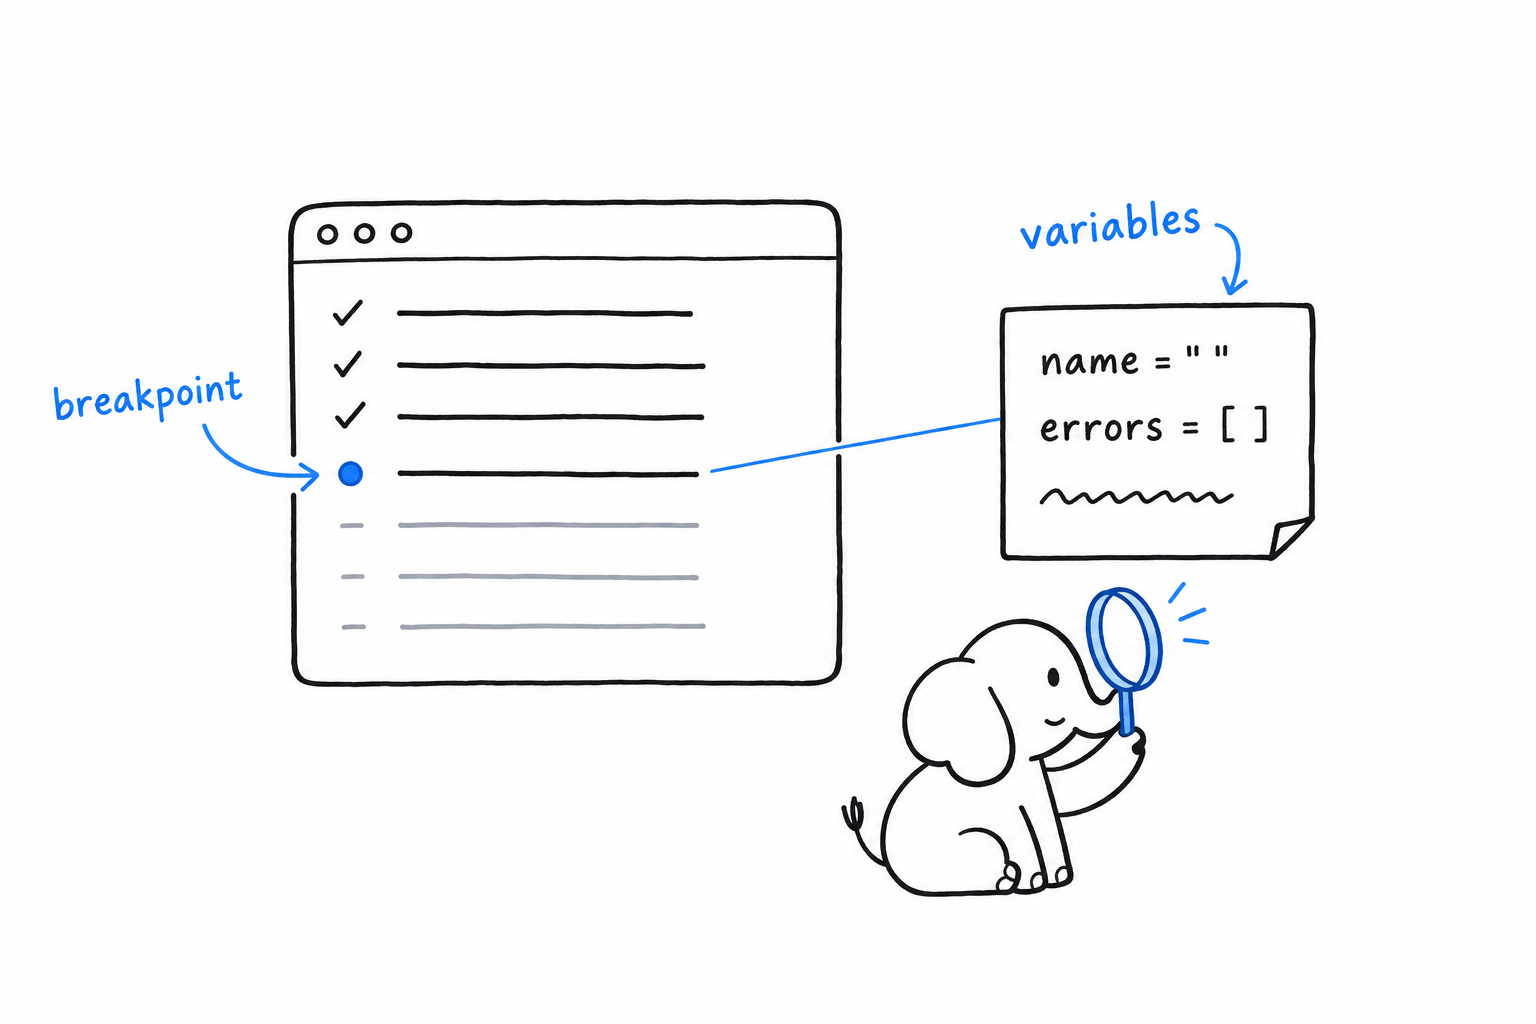
De là, vous avez trois façons d’avancer. Le pas par-dessus (step over) exécute la ligne et s’arrête à la suivante. Le pas dedans (step into) suit l’exécution à l’intérieur de la fonction appelée au lieu de l’exécuter d’un bloc. Le pas dehors (step out) termine la fonction en cours et s’arrête de retour chez l’appelant. Les variables se mettent à jour dans le panneau au fur et à mesure.
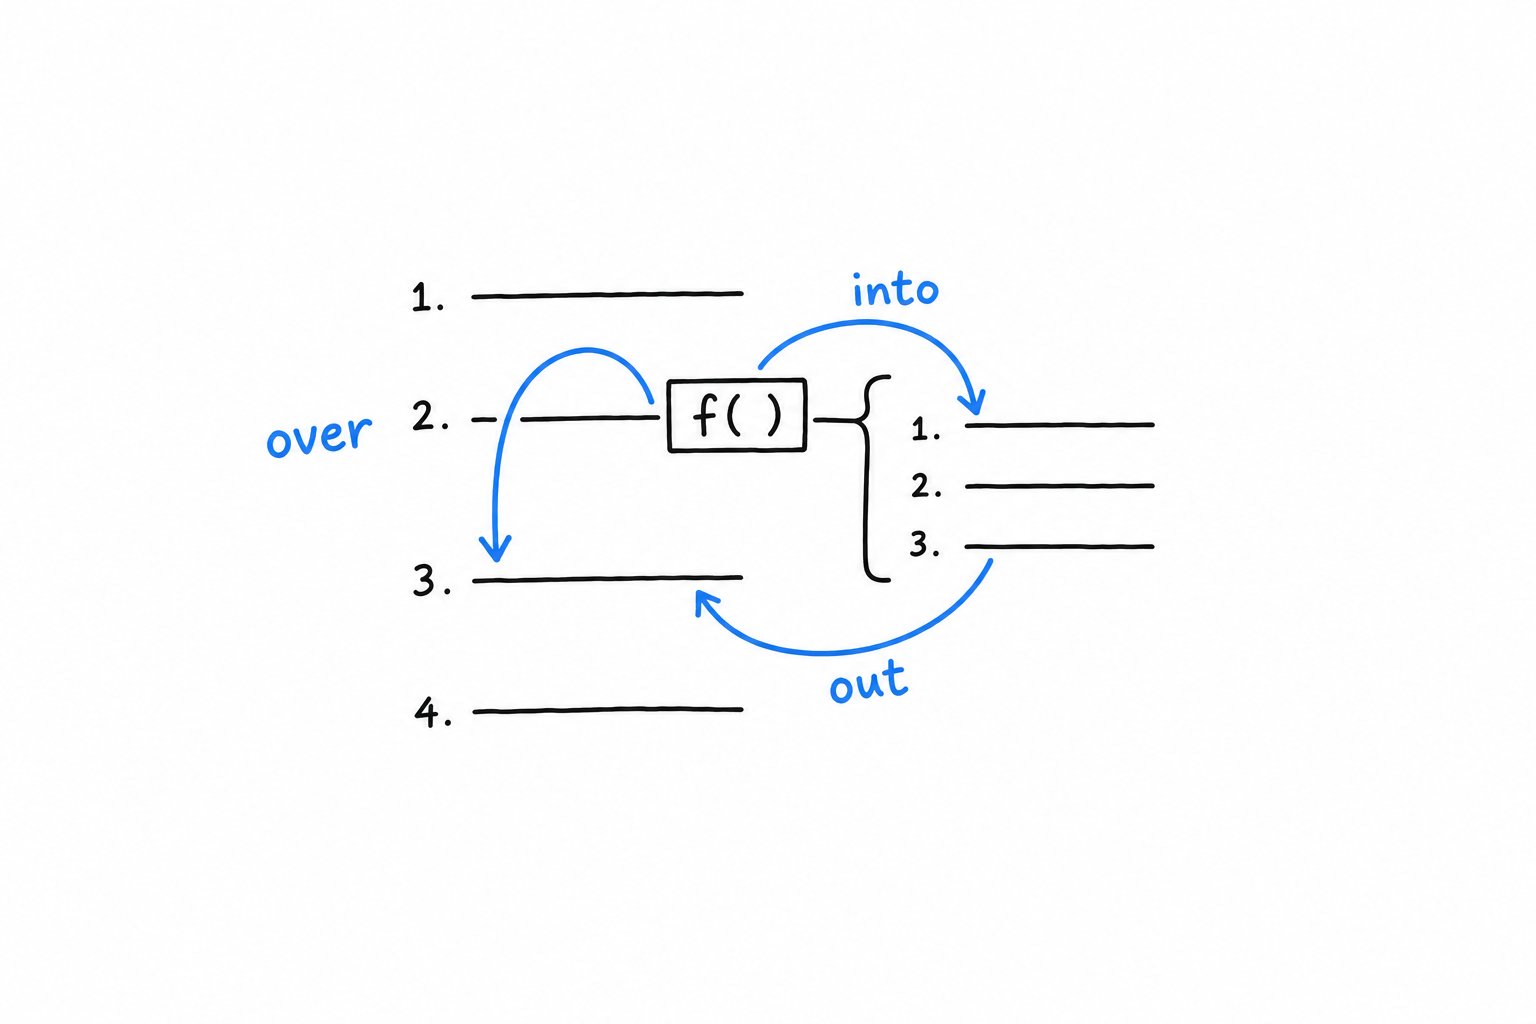
Essai sur le livre d’or
Le code de validation du chapitre 10 est un bon terrain d’entraînement : assez petit pour tenir dans la tête, avec une vraie branche qui vaut le coup d’œil.
if ($name === '') {
    $errors[] = 'Name cannot be empty.';
} elseif (mb_strlen($name) > 60) {
    $errors[] = 'Name is too long.';
}
Posez un point d’arrêt sur la ligne if ($name === ''). Lancez le serveur intégré avec xdebug.mode=debug, mettez votre éditeur en écoute, et envoyez le formulaire du livre d’or en laissant le champ du nom vide. L’exécution s’arrête pile là. Le panneau des variables montre $name comme chaîne vide et $errors comme tableau vide, exactement tels qu’ils étaient à cet instant, avant qu’une seule ligne du bloc if ait tourné. Passez par-dessus, et regardez $errors recevoir sa première entrée.
Aucun
var_dump()n’a eu besoin d’être écrit, déplacé ou retiré pour voir tout ça. C’est toute la valeur du débogage pas à pas.
Le profilage, en bref
xdebug.mode=profile allume une troisième capacité. Au lieu de mettre l’exécution en pause, Xdebug mesure la durée de chaque appel de fonction et écrit le résultat dans un fichier « cachegrind » (xdebug.output_dir dit où). Des outils comme QCachegrind, ou le profileur intégré à PhpStorm, lisent ce fichier et vous montrent exactement où une requête lente a passé son temps : quelle fonction, appelée combien de fois, pour quelle part du total. Traquer la lenteur est un autre métier que traquer une mauvaise réponse, plus proche de ce que le chapitre 15 raconte sur les boucles et les générateurs, mais c’est la même extension, et elle mérite d’être connue.
Choisir entre les deux outils
Franchement, commencez par var_dump() et print_r(). Ils ne demandent aucune installation, et pour la plupart des bugs, surtout au début, afficher la valeur et la regarder trouve le problème en quelques secondes.
Passez à Xdebug quand l’affichage cesse de resserrer l’étau : quand un bug dépend d’une suite d’appels plutôt que d’une seule valeur, ou quand vous vous surprenez à ajouter et retirer un var_dump() pour la troisième fois sur le même problème. À ce stade, mettre le programme en pause et regarder autour coûte moins cher que deviner encore une fois.
Un projet en ligne de commande : construire un programme CLI
Quelque part sur votre disque, il y a un journal, une liste, un export de quelque chose, et vous ne voulez que les lignes qui mentionnent un mot. Sous Unix, ce travail revient à grep. Au fil des six prochaines sections, vous allez écrire le vôtre. phpgrep est un petit outil en ligne de commande qui affiche toutes les lignes d’un fichier contenant un mot, et c’est le plus gros programme du livre jusqu’ici.
C’est un seul programme, pas six exemples. Chaque section reprend exactement là où la précédente s’est arrêtée, comme le chapitre 2 a fait grandir son jeu de devinette une capacité à la fois. La première version est grossière : lire deux arguments, les afficher. La dernière lit son fichier proprement, signale ses erreurs comme un vrai outil, obéit à une variable d’environnement, et s’appuie sur des tests écrits avant le code qui les fait passer. En chemin, vous réutilisez l’essentiel de ce que le livre a enseigné : les classes et la promotion de constructeur du chapitre 5, les exceptions du chapitre 9, PHPUnit du chapitre 12.
Un outil de recherche fait un bon projet d’apprentissage, et ce n’est pas un hasard. Il est assez petit pour tenir entièrement dans votre tête, et pourtant il a des arguments à analyser, un fichier à lire, un endroit où les choses peuvent légitimement mal tourner (le fichier manque) et une fonctionnalité qui mérite d’être ajoutée avec soin (ignorer la casse). Chacune de ses pièces, vous la referez un jour, sous une forme ou une autre, au travail.
Tapez le code au fur et à mesure plutôt que de coller le fichier final. La valeur de ce chapitre, c’est de voir le programme changer de forme : maladroit d’abord, puis modulaire, puis testé, puis fini. Et gardez le projet une fois terminé. Le chapitre 15 revient sur phpgrep pour une dernière amélioration, quand vous aurez rencontré une fonctionnalité de PHP taillée pour lui.
Accepter des arguments en ligne de commande
Créez un répertoire pour le projet et, dedans, un fichier phpgrep.php. Tout ce qui est tapé après php sur la ligne de commande atterrit dans un tableau nommé $argv, disponible dans tout script lancé depuis un terminal :
<?php
declare(strict_types=1);

var_dump($argv);
$ php phpgrep.php apple fruits.txt
array(3) {
  [0]=>
  string(11) "phpgrep.php"
  [1]=>
  string(5) "apple"
  [2]=>
  string(9) "fruits.txt"
}
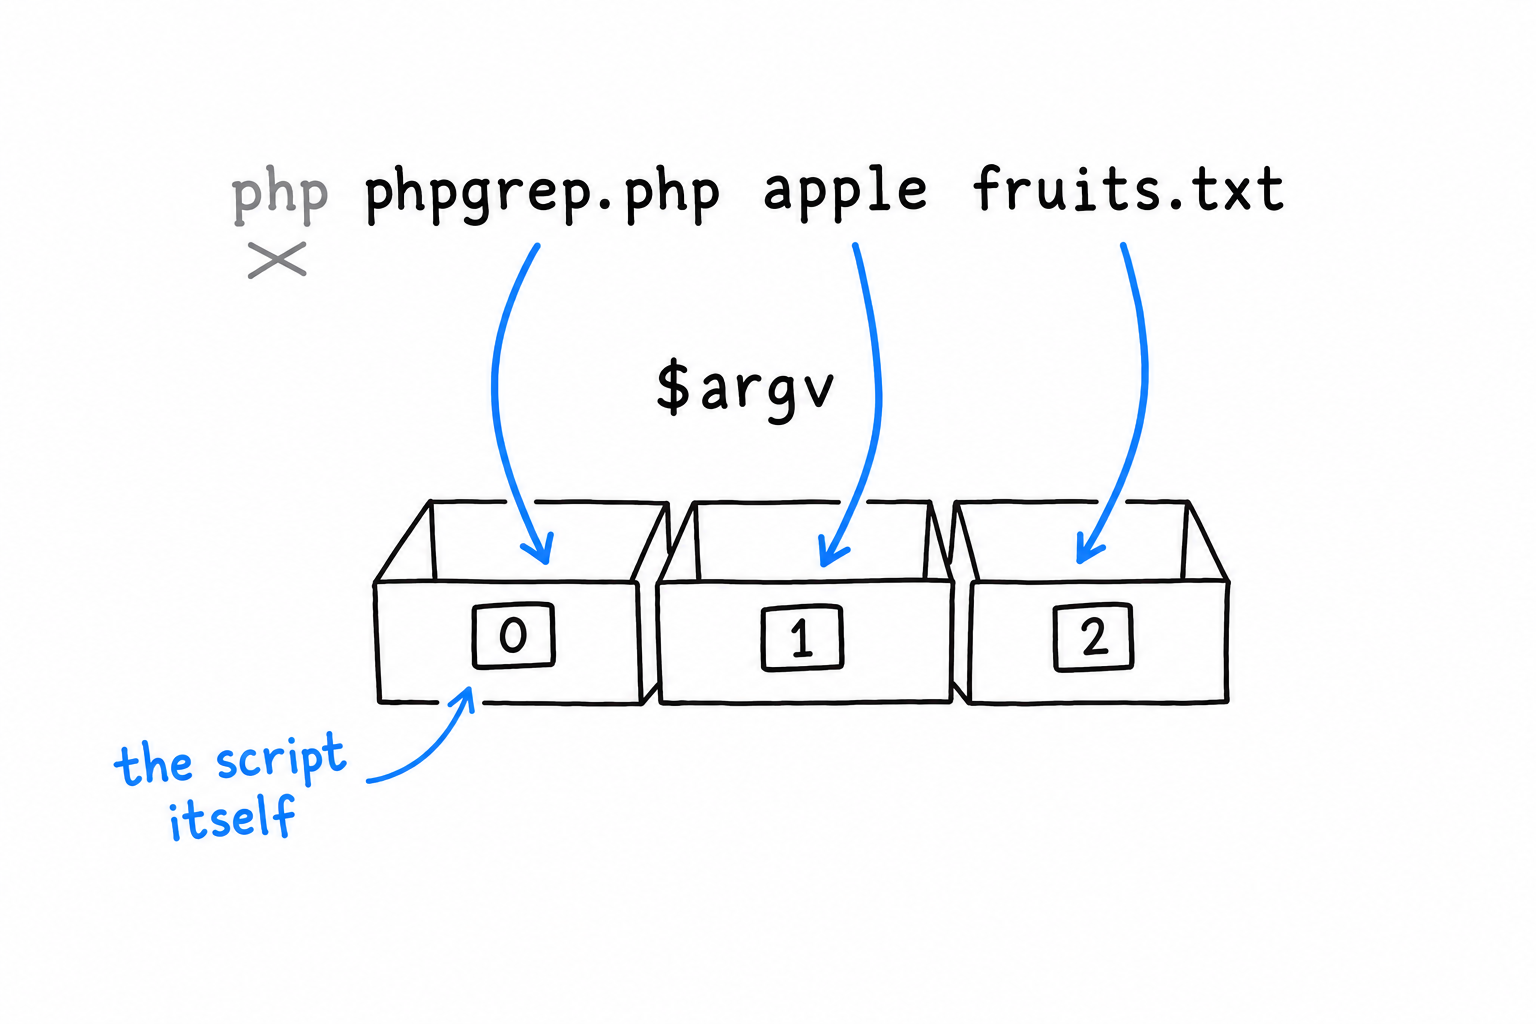
Première surprise, si vous n’avez jamais croisé $argv : $argv[0] n’est pas votre premier argument. C’est le nom du script lui-même. Tout le monde s’y fait prendre une fois. Vos vrais arguments commencent à l’indice 1 : ici, $argv[1] est le mot à chercher et $argv[2] le fichier dans lequel chercher, et c’est toute l’interface dont phpgrep a besoin.
Lire deux arguments, mal
La façon la plus directe de les attraper :
<?php
declare(strict_types=1);

$query = $argv[1];
$filename = $argv[2];

echo "Searching for \"{$query}\" in \"{$filename}\"\n";
Lancez-le correctement, et ça marche. Lancez-le maintenant avec un argument de moins :
$ php phpgrep.php apple
PHP affiche un avertissement pour le $argv[2] manquant, le remplace par null, et continue en boitant avec une entrée bidon au lieu de s’arrêter pour dire ce qui cloche. Tolérable tant que vous êtes le seul utilisateur. Pas pour un outil que quelqu’un d’autre lancera un jour. Ajoutons une garde à l’entrée :
<?php
declare(strict_types=1);

if (count($argv) < 3) {
    echo "Usage: php phpgrep.php <query> <filename>\n";
    exit(1);
}

$query = $argv[1];
$filename = $argv[2];

echo "Searching for \"{$query}\" in \"{$filename}\"\n";
exit(1) arrête le script sur-le-champ et renvoie le nombre 1 au shell comme code de sortie. Par convention Unix, 0 veut dire « ça a marché » et tout le reste veut dire « quelque chose a mal tourné ». Chaque commande que vous avez enchaînée avec &&, chaque $? que vous avez vérifié dans un shell repose sur cette convention. phpgrep la respecte dès sa toute première version.
Donner un toit aux arguments : GrepOptions
Deux variables en vrac, ça va pour aujourd’hui. Mais ce projet va grandir, et passer deux chaînes séparées à chaque fonction que vous écrirez devient vite pénible. Mieux vaut les regrouper dans une petite classe dont le seul rôle est de retenir ce qu’on a demandé au programme pour cette exécution :
<?php
declare(strict_types=1);

final class GrepOptions
{
    public function __construct(
        public readonly string $query,
        public readonly string $filename,
    ) {
    }

    public static function fromArgv(array $argv): self
    {
        return new self(
            query: $argv[1],
            filename: $argv[2],
        );
    }
}

if (count($argv) < 3) {
    echo "Usage: php phpgrep.php <query> <filename>\n";
    exit(1);
}

$options = GrepOptions::fromArgv($argv);

echo "Searching for \"{$options->query}\" in \"{$options->filename}\"\n";
Deux propriétés readonly, fixées une fois pour toutes par promotion de constructeur, comme au chapitre 5. Un GrepOptions ne change plus une fois construit, ce qui est exactement ce qu’il faut pour un objet qui représente la demande de l’utilisateur pendant toute la durée d’une exécution. fromArgv() est une fabrique statique : donnez-lui le tableau $argv brut, elle rend un GrepOptions complet. La question « comment analyse-t-on les arguments » a maintenant une réponse, à un seul endroit.
Relancez pour vérifier que rien n’a changé vu de l’extérieur :
$ php phpgrep.php apple fruits.txt
Searching for "apple" in "fruits.txt"
Même comportement, meilleure ossature. C’est tout l’intérêt d’introduire la classe aussi tôt : elle ne coûte presque rien maintenant, et c’est précisément la couture dont le reste du chapitre a besoin. La classe gagnera bientôt une troisième propriété. Sa forme et son rôle ne bougeront pas.
Lire un fichier
phpgrep analyse ses arguments et ne cherche rien. Il est temps de lui donner un fichier. Créez-en un juste à côté de phpgrep.php :
$ cat fruits.txt
Apple pie recipe
apple sauce for the win
Banana bread is better
cherry clafoutis
Quatre lignes, dont deux parlent de pommes, l’une avec une majuscule et l’autre sans. Ce détail est voulu, et il reviendra.
Lire tout le fichier en lignes
La fonction file() de PHP lit un fichier directement dans un tableau, un élément par ligne, exactement la forme qu’attend une recherche ligne par ligne :
<?php

$lines = file($options->filename, FILE_IGNORE_NEW_LINES);
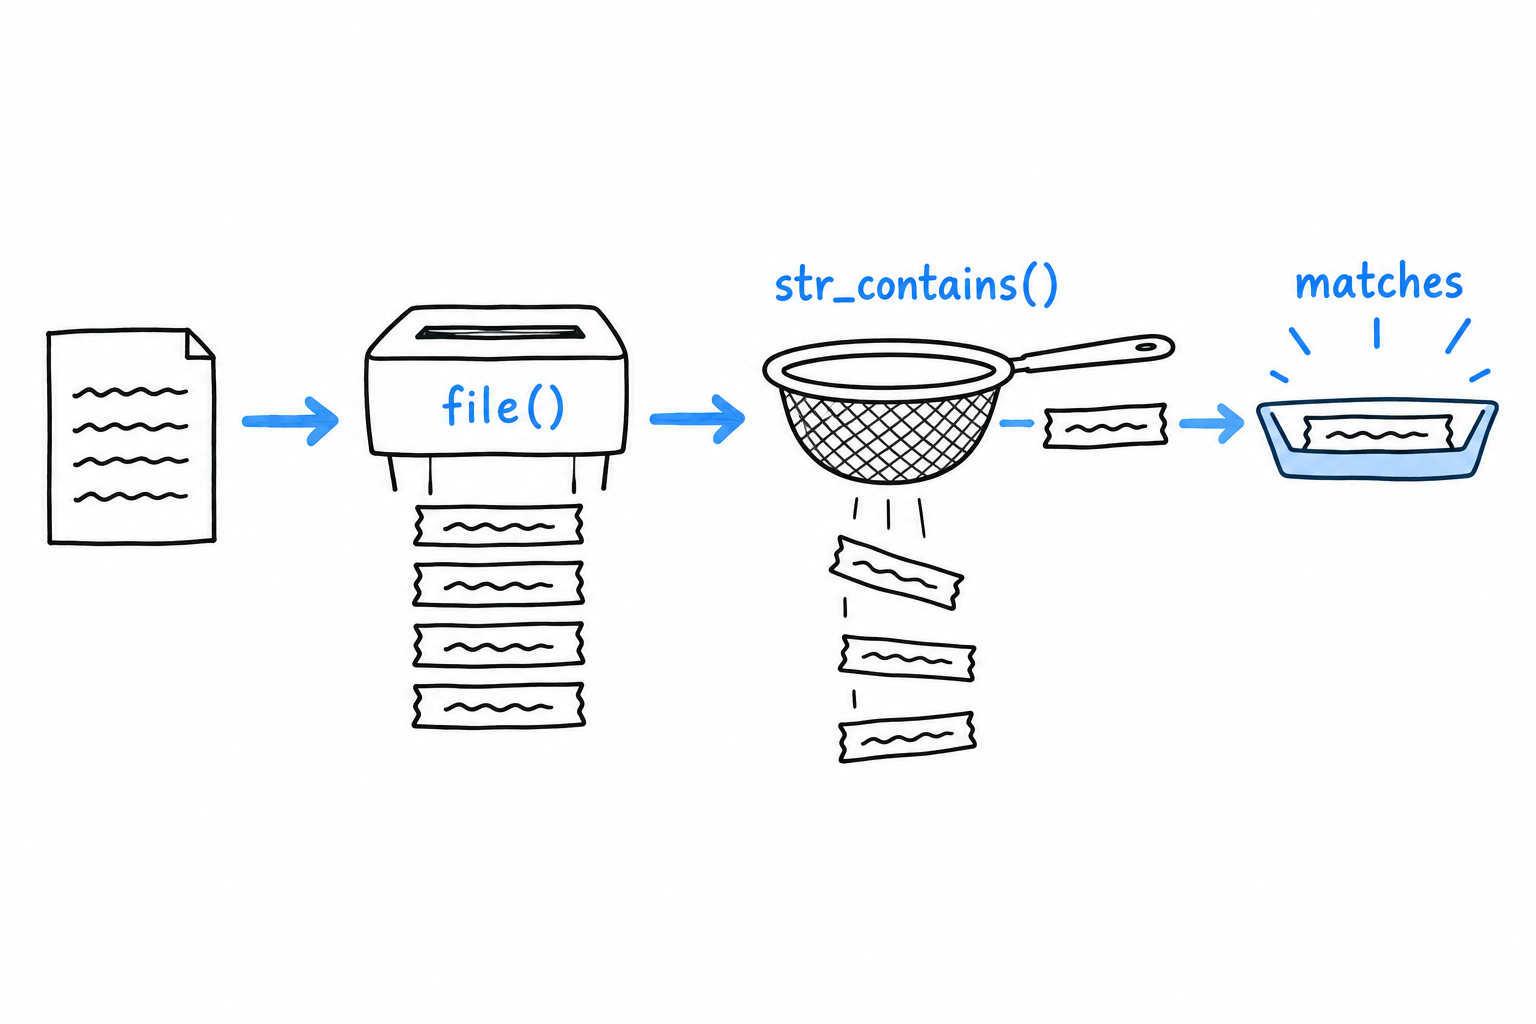
Le drapeau FILE_IGNORE_NEW_LINES retire le \n final de chaque ligne au passage, ce qui vous épargne un trim() sur chacune ensuite. Vous pourriez obtenir le même résultat avec file_get_contents() suivi de explode("\n", ...), et vous verrez souvent ce duo dans du vrai code, surtout quand le contenu brut sert aussi à autre chose. Pour un outil qui pense en lignes, file() est la réponse directe.
Chercher dans chaque ligne
Les lignes en main, str_contains() fait la comparaison. Elle est arrivée avec PHP 8, après des années où tout le monde bricolait strpos($haystack, $needle) !== false, et elle se lit comme ce qu’elle fait :
<?php
declare(strict_types=1);

final class GrepOptions
{
    public function __construct(
        public readonly string $query,
        public readonly string $filename,
    ) {
    }

    public static function fromArgv(array $argv): self
    {
        return new self(
            query: $argv[1],
            filename: $argv[2],
        );
    }
}

if (count($argv) < 3) {
    echo "Usage: php phpgrep.php <query> <filename>\n";
    exit(1);
}

$options = GrepOptions::fromArgv($argv);

$lines = file($options->filename, FILE_IGNORE_NEW_LINES);

foreach ($lines as $line) {
    if (str_contains($line, $options->query)) {
        echo $line . "\n";
    }
}
$ php phpgrep.php apple fruits.txt
apple sauce for the win
Seule la ligne avec apple en minuscules correspond. str_contains() est sensible à la casse : "Apple pie recipe" ne contient pas la sous-chaîne "apple", à cause du A majuscule. Gardez ce fichier et ce comportement en tête. Dans deux sections, ils deviennent le cas de test exact de la recherche insensible à la casse.
Le fichier qui n’existe pas
Pointez phpgrep vers un fichier qui n’existe pas :
$ php phpgrep.php apple missing.txt

Warning: file(missing.txt): Failed to open stream: No such file or directory in phpgrep.php on line 20
Un avertissement, puis rien. file() renvoie false quand elle ne peut pas ouvrir sa cible, notre foreach traite ce false comme un tableau vide, et le programme se termine sans résultat et sans explication. L’outil a l’air d’avoir cherché sans rien trouver, alors qu’il n’a rien lu du tout. C’est la pire sorte d’échec, la silencieuse.
Colmatons avec l’outil le plus brut qui soit, une vérification avant la lecture :
<?php

if (!file_exists($options->filename)) {
    echo "Error: file \"{$options->filename}\" not found.\n";
    exit(1);
}

$lines = file($options->filename, FILE_IGNORE_NEW_LINES);
$ php phpgrep.php apple missing.txt
Error: file "missing.txt" not found.
Mieux, parce qu’au moins c’est honnête. Mais regardez ce que cette vérification vous apporte, et ce qu’elle ne vous apporte pas. file_exists() ne répond qu’à « y a-t-il quelque chose à ce chemin ». Elle ne dit rien sur le fait que vous puissiez le lire : un fichier qui existe mais dont les permissions sont verrouillées passe ce contrôle, puis échoue dans file() exactement comme avant, avertissement compris. Et chaque endroit de ce programme qui ouvrira un jour un fichier aurait besoin de la même vérification collée devant, chaque copie étant une occasion d’en oublier une.
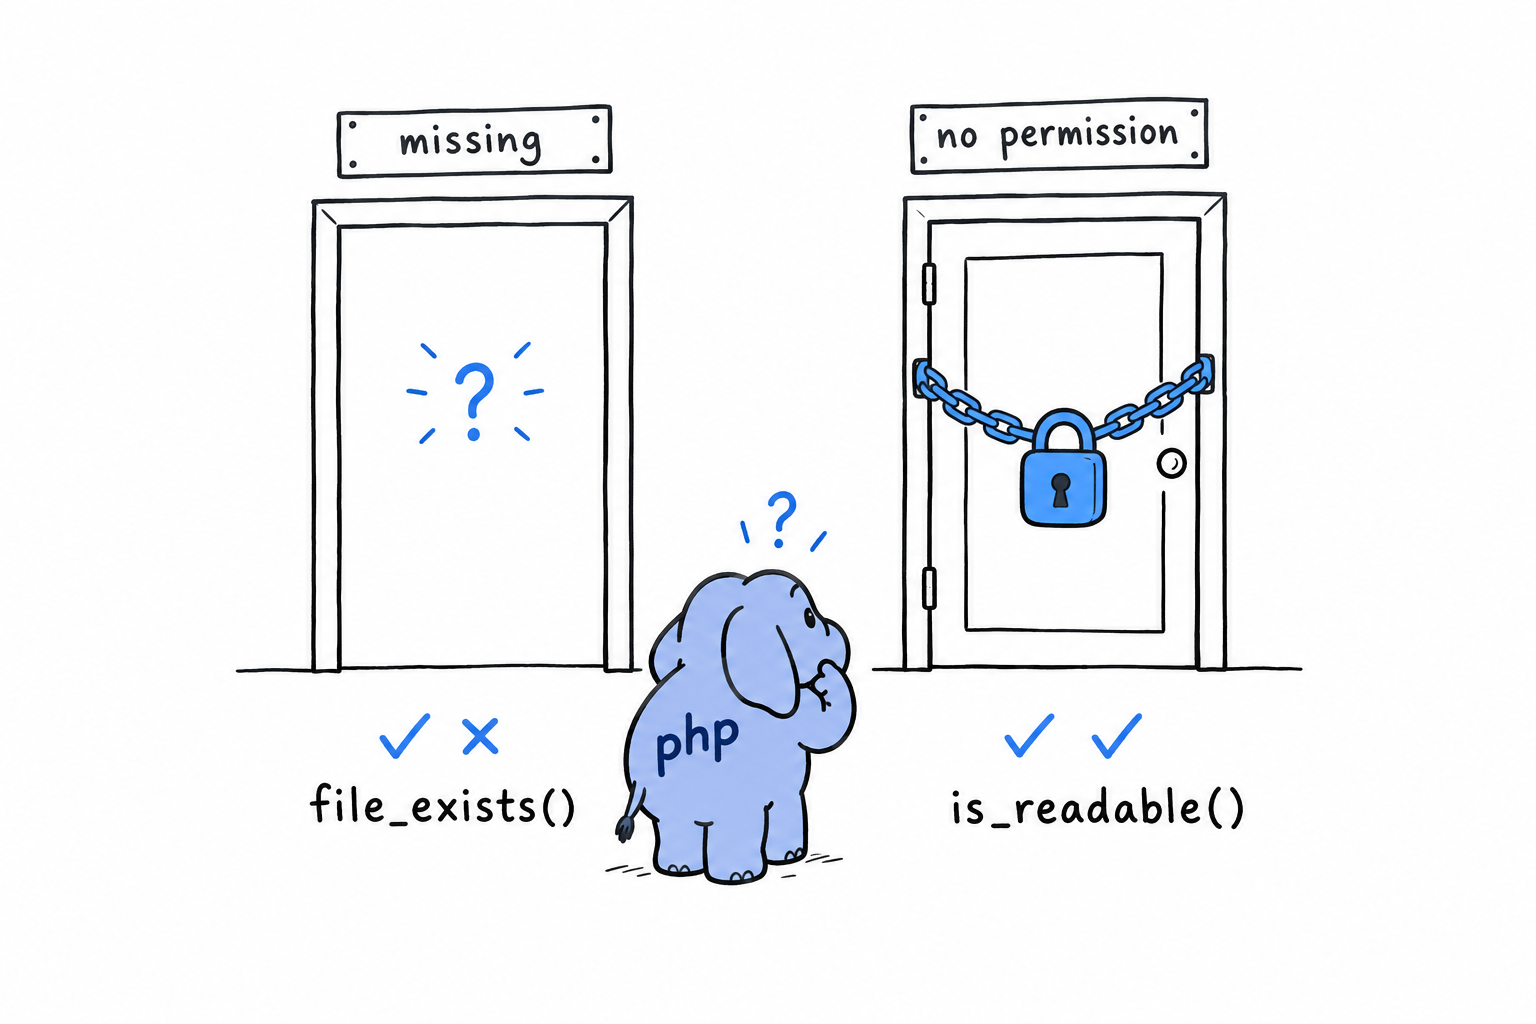
Une garde maladroite et incomplète, à la place d’un mécanisme que PHP prévoit exprès. Il est temps de s’en servir.
Refactoriser pour la modularité et la gestion des erreurs
Tout ce que fait phpgrep tient dans un seul script, de haut en bas : analyser les arguments, vérifier le fichier, le lire, boucler, afficher. Très bien pour trente lignes. Ça cesse de l’être dès que vous voulez tester une pièce sans lancer tout le programme, et c’est exactement là que ce projet se dirige. Cette section découpe phpgrep en morceaux qu’on peut appeler séparément, et remplace la rustine file_exists() par le mécanisme que PHP a conçu pour ça : une exception.
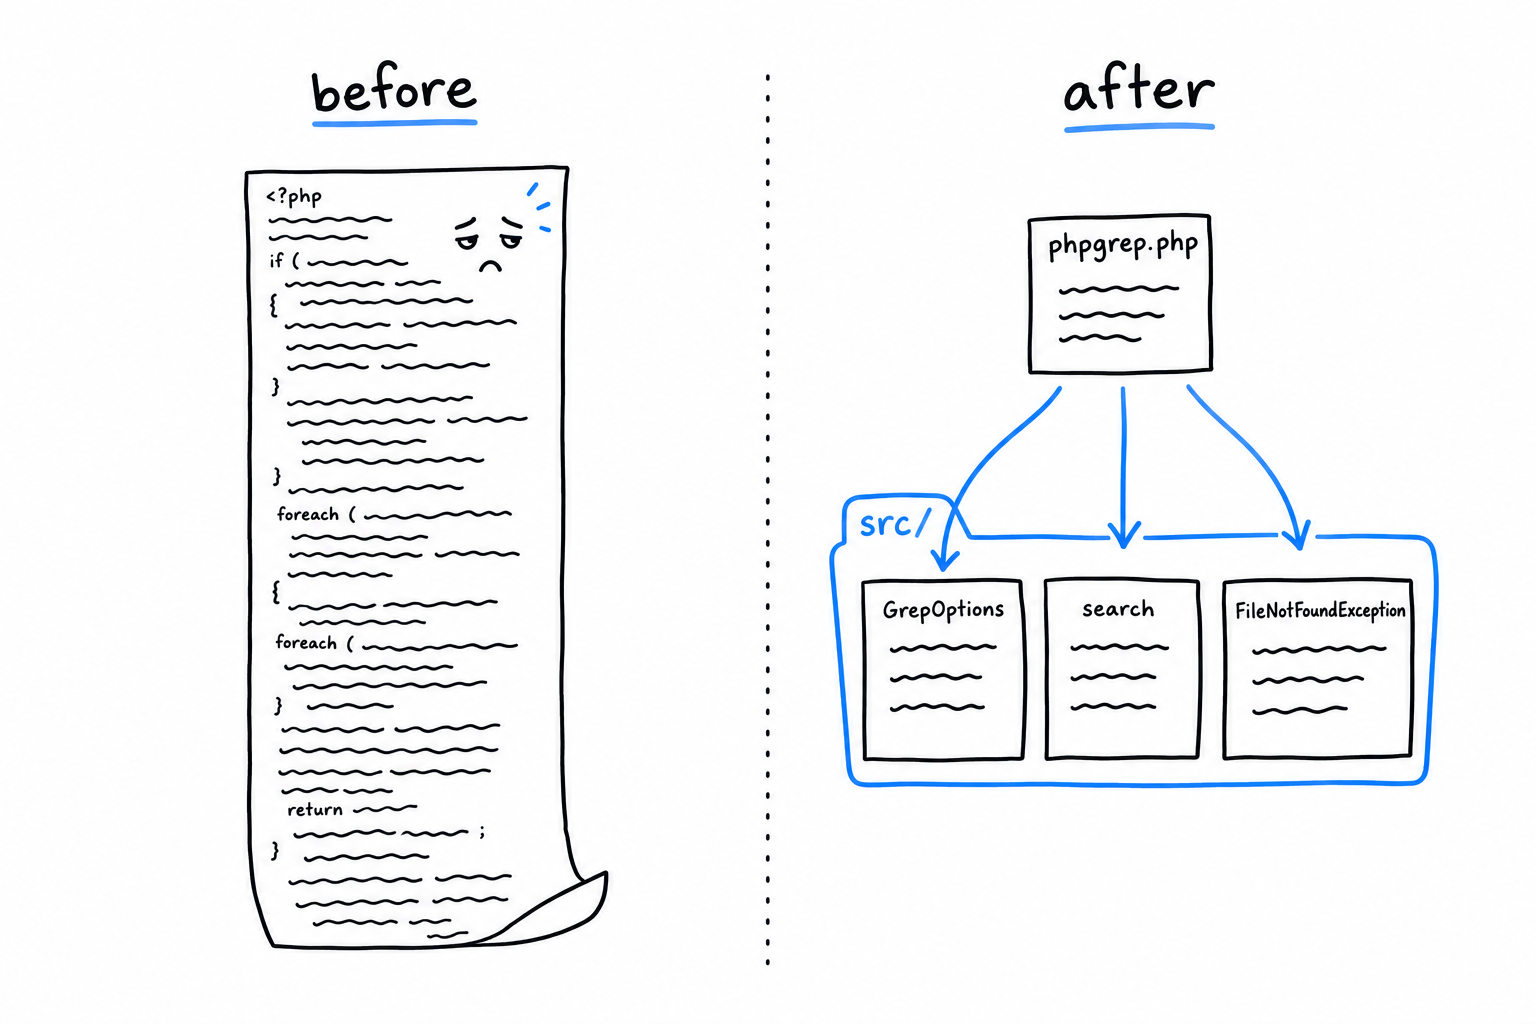
Une exception qui porte un nom
Le chapitre 9 a plaidé pour lancer une exception précise et bien nommée plutôt que renvoyer une valeur sentinelle ou afficher une erreur en espérant que quelqu’un la vérifie. RuntimeException est la bonne classe de base pour « quelque chose a mal tourné pendant l’exécution, et l’appelant mérite une chance de s’en occuper ». Étendez-la avec un nom qui dit exactement ce qui s’est passé :
<?php
// src/FileNotFoundException.php
declare(strict_types=1);

final class FileNotFoundException extends RuntimeException
{
}
C’est toute la classe. Elle n’ajoute aucun comportement, et elle n’en a pas besoin. Toute sa valeur tient dans son nom. Un catch (FileNotFoundException $e) dit à qui le lit précisément quel échec est traité, sans aller lire le code qui l’a lancé.
Extraire search()
Sortez maintenant la lecture et la comparaison du script pour les mettre dans une fonction avec un vrai nom et un vrai contrat : elle prend un GrepOptions, renvoie les lignes qui correspondent, et lance une exception si le fichier ne peut pas être lu :
<?php
// src/search.php
declare(strict_types=1);

require_once __DIR__ . '/FileNotFoundException.php';

function search(GrepOptions $options): array
{
    if (!is_readable($options->filename)) {
        throw new FileNotFoundException("Cannot read file: {$options->filename}");
    }

    $lines = file($options->filename, FILE_IGNORE_NEW_LINES);

    $matches = [];
    foreach ($lines as $line) {
        if (str_contains($line, $options->query)) {
            $matches[] = $line;
        }
    }

    return $matches;
}
is_readable() est un vrai progrès par rapport à file_exists(). Elle vérifie que le fichier existe et que le processus courant a la permission de le lire, ce qui est la condition dont file() a réellement besoin. Que l’un ou l’autre échoue, et search() lance aussitôt son exception, en nommant le fichier. Pas d’avertissement sur un flux que personne ne regarde, pas de résultat vide et muet, juste un échec net qu’un appelant peut attraper.
GrepOptions passe aussi dans son propre fichier, sans changement :
<?php
// src/GrepOptions.php
declare(strict_types=1);

final class GrepOptions
{
    public function __construct(
        public readonly string $query,
        public readonly string $filename,
    ) {
    }

    public static function fromArgv(array $argv): self
    {
        return new self(
            query: $argv[1],
            filename: $argv[2],
        );
    }
}
Le script d’entrée, réduit au câblage
Avec GrepOptions et search() dans src/, phpgrep.php se réduit à ce qu’il aurait toujours dû être : la partie qui parle au monde extérieur, et rien d’autre.
<?php
// phpgrep.php
declare(strict_types=1);

require __DIR__ . '/src/GrepOptions.php';
require __DIR__ . '/src/FileNotFoundException.php';
require __DIR__ . '/src/search.php';

function main(array $argv): int
{
    if (count($argv) < 3) {
        echo "Usage: php phpgrep.php <query> <filename>\n";
        return 1;
    }

    $options = GrepOptions::fromArgv($argv);

    try {
        $matches = search($options);
    } catch (FileNotFoundException $e) {
        echo "Error: {$e->getMessage()}\n";
        return 1;
    }

    foreach ($matches as $line) {
        echo $line . "\n";
    }

    return 0;
}

exit(main($argv));
Regardez main() : elle renvoie un code de sortie au lieu d’appeler exit() elle-même. Le processus se termine à un seul endroit, la dernière ligne du fichier. Une fonction qui renvoie une valeur au lieu de tuer le processus est une fonction qu’on peut appeler de n’importe où, et « n’importe où » inclut un test, où vous préférez nettement récupérer les erreurs de main() sous forme de valeur à vérifier plutôt que de voir votre lanceur de tests disparaître au milieu de la suite.
$ php phpgrep.php apple fruits.txt
apple sauce for the win

$ php phpgrep.php apple missing.txt
Error: Cannot read file: missing.txt
Même comportement vu de l’extérieur, et c’est voulu. Rien de ce que fait phpgrep n’a changé dans cette section, seulement la façon dont il est construit.
Un refactoring qui change le comportement n’est pas un refactoring. C’est une réécriture déguisée.
Ce qui a changé, c’est que search() et GrepOptions vivent maintenant dans des fichiers qui ne font jamais exit, jamais echo, et ne touchent jamais à $argv. Pour la première fois, un test peut les appeler directement. C’est ce que fait la section suivante.
Ajouter une fonctionnalité en développement piloté par les tests
search() et GrepOptions vivent désormais dans des fichiers qui ne lisent pas $argv, ne font pas echo et ne font pas exit. C’était le but de la section précédente, et ça paie maintenant : pour la première fois dans ce projet, un test PHPUnit peut les appeler directement, comme le chapitre 12 l’a montré. Profitons-en pour ajouter une vraie fonctionnalité, la recherche insensible à la casse, en commençant par le test.
Installez PHPUnit comme vous l’aviez fait à l’époque :
$ composer require --dev phpunit/phpunit
Rouge : écrire le test qu’on aimerait déjà voir passer
Retour à fruits.txt :
Apple pie recipe
apple sauce for the win
Banana bread is better
cherry clafoutis
Chercher apple ne trouve que la ligne en minuscules, parce que str_contains() ne replie pas la casse. Écrivez, sous forme de test, le comportement que vous voulez à la place : un GrepOptions avec l’insensibilité à la casse activée doit trouver à la fois "Apple pie recipe" et "apple sauce for the win".
<?php
// tests/SearchTest.php
declare(strict_types=1);

use PHPUnit\Framework\TestCase;

require_once __DIR__ . '/../src/GrepOptions.php';
require_once __DIR__ . '/../src/FileNotFoundException.php';
require_once __DIR__ . '/../src/search.php';

final class SearchTest extends TestCase
{
    private string $fixture;

    protected function setUp(): void
    {
        $this->fixture = tempnam(sys_get_temp_dir(), 'phpgrep');
        file_put_contents(
            $this->fixture,
            "Apple pie recipe\napple sauce for the win\nBanana bread is better\ncherry clafoutis\n"
        );
    }

    protected function tearDown(): void
    {
        unlink($this->fixture);
    }

    public function testSearchCanIgnoreCase(): void
    {
        $options = new GrepOptions(
            query: 'apple',
            filename: $this->fixture,
            ignoreCase: true,
        );

        $this->assertSame(
            ['Apple pie recipe', 'apple sauce for the win'],
            search($options)
        );
    }
}
setUp() et tearDown() sont des crochets de PHPUnit exécutés avant et après chaque méthode de test de la classe. Ici, ils fabriquent un fichier temporaire neuf par test et le suppriment ensuite, si bien qu’aucun test ne dépend de ce qu’une exécution précédente a laissé derrière elle.
Lancez :
$ vendor/bin/phpunit tests
PHPUnit 10.5.0 by Sebastian Bergmann and contributors.

E                                                                   1 / 1 (100%)

Time: 00:00.014, Memory: 6.00 MB

1) SearchTest::testSearchCanIgnoreCase
Error: Unknown named parameter $ignoreCase
Rouge, et pour exactement la bonne raison. GrepOptions n’a pas encore de propriété ignoreCase, donc PHP ne peut même pas construire l’objet que le test demande. Tout le rythme du développement piloté par les tests tient dans ce pas : écrire le test du comportement voulu avant que le code existe, le regarder échouer, et laisser l’échec dire ce qu’il faut construire ensuite.
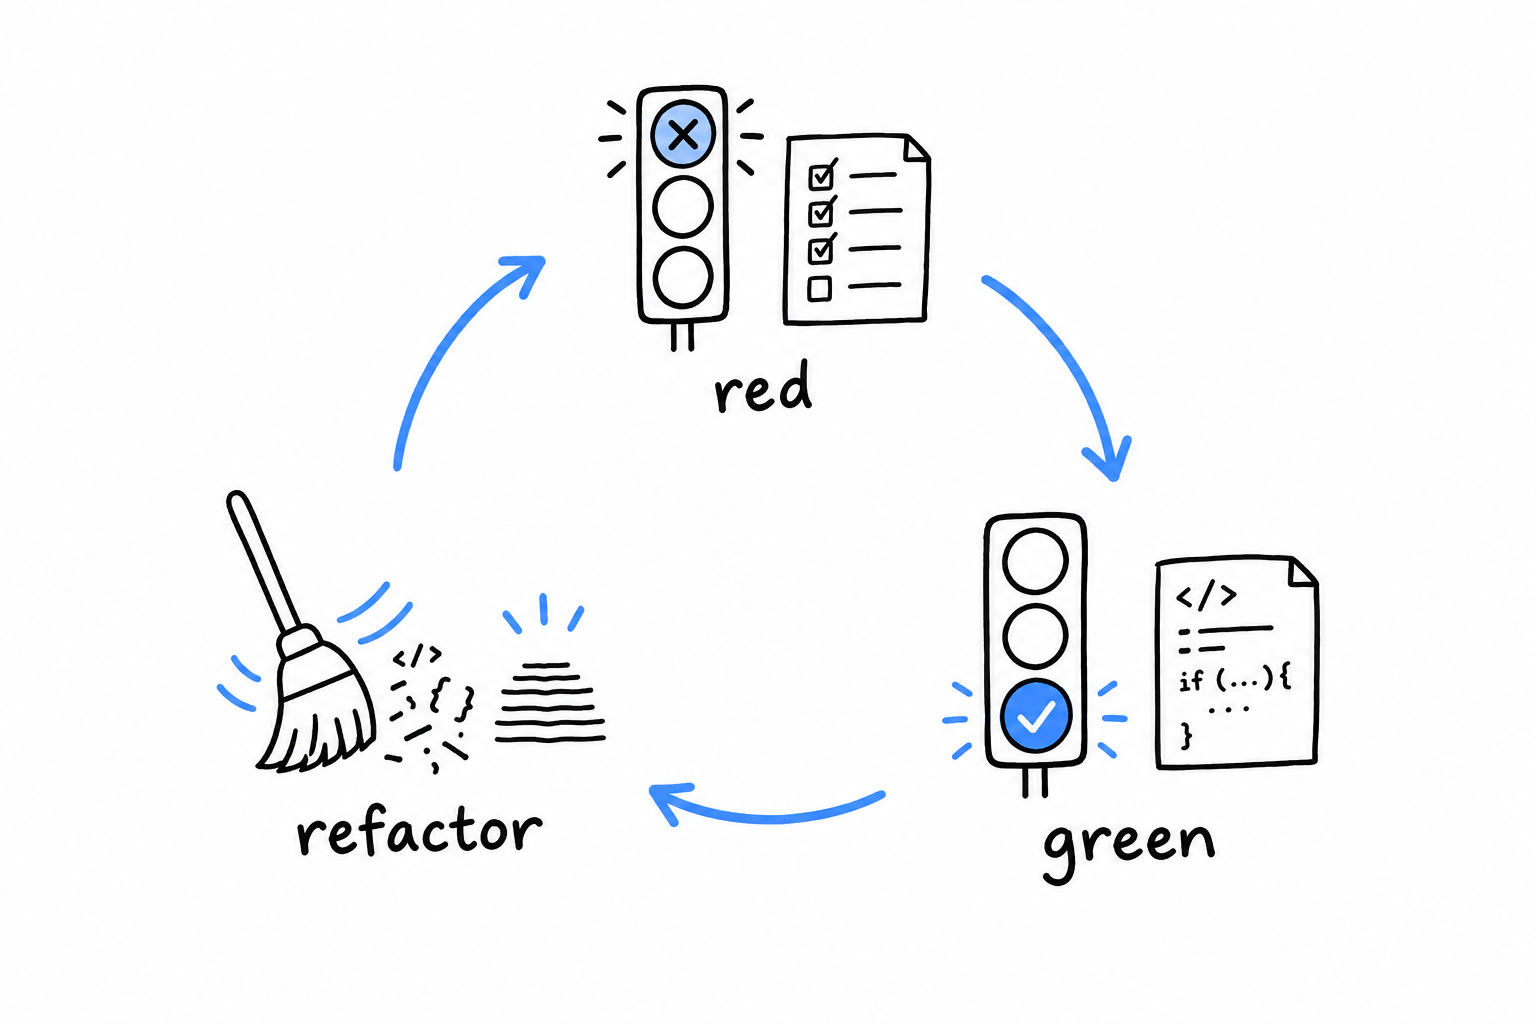
Vert : le faire passer
D’abord, donnez à GrepOptions la propriété que le test réclame :
<?php
// src/GrepOptions.php
declare(strict_types=1);

final class GrepOptions
{
    public function __construct(
        public readonly string $query,
        public readonly string $filename,
        public readonly bool $ignoreCase,
    ) {
    }

    public static function fromArgv(array $argv): self
    {
        return new self(
            query: $argv[1],
            filename: $argv[2],
            ignoreCase: false,
        );
    }
}
fromArgv() passe un false en dur pour l’instant. Laisser l’utilisateur le piloter, c’est le travail de la section suivante. Apprenez ensuite à search() à respecter le drapeau :
<?php
// src/search.php
declare(strict_types=1);

require_once __DIR__ . '/FileNotFoundException.php';

function search(GrepOptions $options): array
{
    if (!is_readable($options->filename)) {
        throw new FileNotFoundException("Cannot read file: {$options->filename}");
    }

    $lines = file($options->filename, FILE_IGNORE_NEW_LINES);
    $query = $options->ignoreCase ? strtolower($options->query) : $options->query;

    $matches = [];
    foreach ($lines as $line) {
        $haystack = $options->ignoreCase ? strtolower($line) : $line;
        if (str_contains($haystack, $query)) {
            $matches[] = $line;
        }
    }

    return $matches;
}
Quand ignoreCase est actif, la requête et la ligne sont toutes deux passées en minuscules pour la comparaison. Regardez pourtant ce qui est poussé dans $matches : la $line d’origine, intacte. On veut une recherche insensible à la casse, pas une sortie défigurée.
$ vendor/bin/phpunit tests
PHPUnit 10.5.0 by Sebastian Bergmann and contributors.

.                                                                   1 / 1 (100%)

Time: 00:00.013, Memory: 6.00 MB

OK (1 test, 1 assertion)
Vert. Rouge, puis vert, puis, traditionnellement, refactoring, même s’il n’y a pas grand-chose à remodeler ici pour l’instant. Tant que vous êtes dans le fichier, ajoutez un test de plus, pour figer le comportement que vous ne changez pas :
<?php

public function testSearchIsCaseSensitiveByDefault(): void
{
    $options = new GrepOptions(
        query: 'apple',
        filename: $this->fixture,
        ignoreCase: false,
    );

    $this->assertSame(['apple sauce for the win'], search($options));
}
Il passe du premier coup. Il ne teste rien de nouveau ; il protège l’ancien comportement contre une régression future. Les deux tests méritent leur place : le premier prouve que la fonctionnalité marche, le second prouve que l’ajouter n’a pas cassé en douce ce qui existait déjà.
Travailler avec les variables d’environnement
GrepOptions porte un drapeau ignoreCase et search() le respecte, mais fromArgv() le fixe toujours à false en dur. Personne ne peut l’activer depuis un terminal. Réglons ça avec une variable d’environnement plutôt qu’un troisième argument.
Pourquoi pas simplement $argv[3] ? Parce qu’ignorer la casse tient plus de la préférence durable que de la décision prise à chaque recherche. C’est quelque chose que vous voudrez peut-être actif pour toutes les recherches d’une session, sans retaper une option à chaque fois. Une variable d’environnement se règle une fois et se transmet à chaque commande lancée ensuite, jusqu’à ce que vous fermiez le terminal ou la retiriez. C’est exactement l’outil qu’il faut pour une préférence.
La lire avec getenv()
<?php
// src/GrepOptions.php
declare(strict_types=1);

final class GrepOptions
{
    public function __construct(
        public readonly string $query,
        public readonly string $filename,
        public readonly bool $ignoreCase,
    ) {
    }

    public static function fromArgv(array $argv): self
    {
        return new self(
            query: $argv[1],
            filename: $argv[2],
            ignoreCase: getenv('PHPGREP_IGNORE_CASE') !== false,
        );
    }
}
getenv('PHPGREP_IGNORE_CASE') renvoie la valeur de la variable sous forme de chaîne si elle est définie, et le booléen false si elle n’est pas définie du tout. C’est pour cela que le test est !== false, et non une tentative d’interpréter la valeur. Résultat : PHPGREP_IGNORE_CASE=1 active le drapeau, mais PHPGREP_IGNORE_CASE= sans rien après le = aussi. Une chaîne vide reste une valeur, et définir la variable, quelle qu’elle soit, compte comme « activé ». Si ce flou vous gêne, vous avez raison de le remarquer. Le resserrer (par exemple en exigeant que la valeur soit exactement "1") est une bonne amélioration à faire de votre côté, une fois le chapitre terminé.
À l’essai
$ php phpgrep.php APPLE fruits.txt
Aucune sortie : APPLE, comparé en respectant la casse, n’apparaît ni dans la ligne Apple ni dans la ligne apple. Activez le drapeau :
$ PHPGREP_IGNORE_CASE=1 php phpgrep.php APPLE fruits.txt
Apple pie recipe
apple sauce for the win
Écrire PHPGREP_IGNORE_CASE=1 juste avant la commande, sur la même ligne, ne la définit que pour cette exécution. C’est un idiome courant du shell pour un réglage qui ne doit pas survivre à la commande qui le porte. Exportez-la à la place, et elle reste pour tout le reste de la session :
$ export PHPGREP_IGNORE_CASE=1
$ php phpgrep.php APPLE fruits.txt
Apple pie recipe
apple sauce for the win
getenv() contre $_ENV
PHP expose aussi l’environnement via la superglobale $_ENV, et il vaut la peine de savoir pourquoi ce chapitre ne l’a pas choisie. $_ENV n’est remplie que selon le réglage variables_order du php.ini. Sur beaucoup d’installations par défaut, surtout celles réglées pour servir des pages web, le E manque à ce réglage, et $_ENV reste vide quoi que contienne l’environnement du processus. getenv() n’a pas cette dépendance : elle interroge directement le système d’exploitation, à chaque appel, et se comporte pareil dans un script CLI, une requête web et tous les hébergements que vous êtes susceptible de croiser. Pour un outil censé tourner partout où on l’installe, cette constance vaut bien une syntaxe un peu moins à la mode.
Écrire sur la sortie d’erreur
Depuis la première section, phpgrep affiche tout de la même façon. Résultats, message d’usage, texte d’erreur : tout passe par echo, tout atterrit sur le même flux. C’était un problème discret depuis le début, et c’est ici qu’il mord.
Tout processus a deux flux de sortie, pas un. La sortie standard (STDOUT) est pour les résultats du programme. La sortie d’erreur (STDERR) est pour les diagnostics, les avertissements et les messages d’erreur. echo écrit toujours sur la première. Les erreurs de phpgrep se sont donc retrouvées juste à côté de ses résultats, ce qui ne pose aucun problème tant que vous ne lisez que le terminal. Ça en pose un dès que quelqu’un envoie la sortie de phpgrep ailleurs, ce qui est toute la raison d’être des outils en ligne de commande.
Regardez-le se tromper
$ php phpgrep.php apple missing.txt > results.txt
$ cat results.txt
Error: Cannot read file: missing.txt
Le message d’erreur a atterri dans results.txt. Ce qui lira ce fichier ensuite (un autre script, un rapport, un collègue persuadé qu’il ne contient que des résultats) a maintenant une ligne d’erreur mêlée à ses données, sans rien qui la distingue d’un vrai résultat. Les deux flux existent précisément pour empêcher ce mélange.
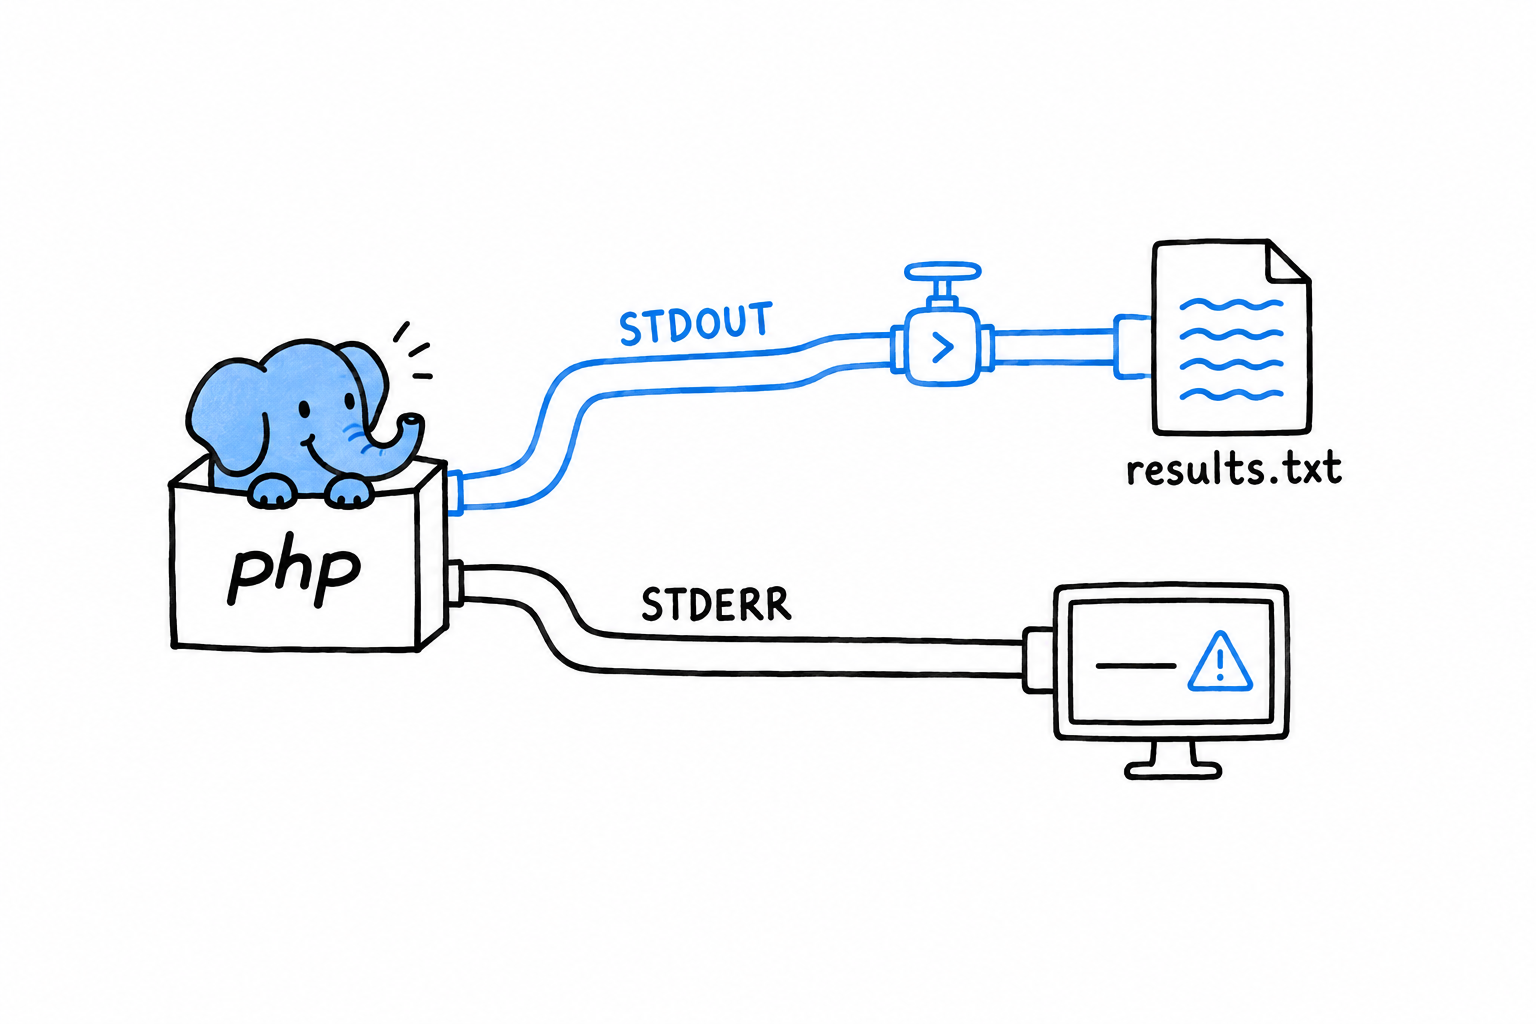
Corriger avec fwrite(STDERR, ...)
PHP expose la sortie d’erreur sous la constante STDERR, et fwrite() y écrit directement, sans passer par echo :
<?php
// phpgrep.php
declare(strict_types=1);

require __DIR__ . '/src/GrepOptions.php';
require __DIR__ . '/src/FileNotFoundException.php';
require __DIR__ . '/src/search.php';

function main(array $argv): int
{
    if (count($argv) < 3) {
        fwrite(STDERR, "Usage: php phpgrep.php <query> <filename>\n");
        return 1;
    }

    $options = GrepOptions::fromArgv($argv);

    try {
        $matches = search($options);
    } catch (FileNotFoundException $e) {
        fwrite(STDERR, "Error: {$e->getMessage()}\n");
        return 1;
    }

    foreach ($matches as $line) {
        echo $line . "\n";
    }

    return 0;
}

exit(main($argv));
Deux lignes ont changé, echo est devenu fwrite(STDERR, ...) sur les deux chemins d’erreur, et le comportement vu de l’extérieur n’a plus rien à voir :
$ php phpgrep.php apple missing.txt > results.txt
Error: Cannot read file: missing.txt
$ cat results.txt
$
L’erreur s’affiche toujours immédiatement sur votre terminal. STDERR n’est pas caché, c’est un flux différent, que la redirection de STDOUT par > ne touche pas. Et results.txt est maintenant vide, exactement comme il se doit : aucun résultat, puisque la recherche n’a jamais eu lieu, et aucun texte d’erreur qui se fait passer pour un résultat. Essayez avec un fichier qui contient des correspondances, et la séparation tient : les résultats vont dans results.txt, les erreurs restent à l’écran, et les deux ne se mélangent jamais.
Les résultats vont sur
STDOUT. Tout le reste va surSTDERR.
Les codes de sortie, encore une fois
main() renvoie toujours un int, et exit(main($argv)) en bas du fichier reste le seul endroit où le processus se termine. Cette discipline d’il y a deux sections rend maintenant deux services. C’est elle qui a permis à SearchTest d’appeler search() sans lancer de processus, et c’est elle qui fait de la valeur de retour de main() le vrai code de sortie : 1 sur chacun des chemins d’erreur, 0 quand elle arrive au bout après avoir affiché ce qu’elle a trouvé. N’avoir rien affiché du tout est un succès pour un outil de recherche, pas un échec. Un script shell ou un pipeline d’intégration continue peut enchaîner phpgrep avec d’autres commandes et se fier à ce code, comme il se fie à tout outil Unix bien élevé, sans analyser la sortie de phpgrep pour savoir si ça a marché.
Voilà phpgrep, pour l’instant. Il accepte ses arguments proprement, lit un fichier et y cherche, échoue fort et précisément quand il ne peut pas, s’appuie sur des tests de sa vraie logique, respecte une variable d’environnement, et garde résultats et erreurs sur des flux séparés. Un petit programme, avec très peu de choses à se faire pardonner.
Il reste une amélioration. Le chapitre 15 introduit les générateurs, et revient sur ce projet précis pour une dernière passe.
Outils fonctionnels : closures et générateurs
Trier une liste de prix. Ne garder que ceux au-dessus de vingt. Ajouter la taxe à chacun. Trois tâches différentes, et dans chacune, ce qui compte tient en une seule ligne de logique : comment comparer deux prix, ce que « cher » veut dire, quel est le taux de taxe. PHP vous laisse écrire cette ligne de logique comme une valeur et la confier à une autre fonction, et il vous donne deux façons de l’écrire. Au chapitre 3, vous avez croisé la première en passant : la closure, une fonction sans nom. Une closure peut emporter des variables du code qui l’entoure, à condition de dire lesquelles. La fonction fléchée, la seconde façon, est plus courte et les emporte toute seule.
La deuxième moitié du chapitre s’attaque à un autre problème : les données elles-mêmes. Il arrive que la série que vous parcourez soit trop grosse pour être construite d’un coup, ou trop lente à produire, ou que vous n’ayez besoin que des premiers éléments. Un générateur est une fonction qui rend ses résultats un par un, en marquant une pause entre chacun, au lieu d’assembler tout le tas avant de le rendre. Ça ressemble presque à une fonction ordinaire, et ça change ce qu’une fonction peut faire.
Ensuite, les deux idées passent à l’atelier. L’outil phpgrep du chapitre 14 lit un fichier entier et range chaque ligne trouvée dans un tableau avant d’afficher quoi que ce soit. Parfait pour un petit fichier, un vrai problème pour un gros. Vous réécrirez search() sous forme de générateur, et vous verrez la première ligne apparaître avant que le fichier ait été lu jusqu’au bout.
Le chapitre se termine sur une mesure plutôt que sur un avis : la même tâche écrite en boucle simple, en générateur, puis avec array_map() et array_filter(), chronométrée et pesée, pour que vous choisissiez entre les trois pour une raison, et non parce que l’une d’elles traînait dans le dernier code que vous avez lu.
Closures et fonctions fléchées
Une closure est une fonction sans nom. Vous en avez rencontré une à la fin du chapitre 3, rangée dans une variable et appelée comme n’importe quelle fonction. Ce que le chapitre 3 a laissé de côté, c’est ce qui rend les closures utiles : une closure peut emporter des variables du code qui l’entoure, et PHP vous donne deux façons de les lui confier, avec deux résultats très différents.
Capturer par valeur avec use
À l’intérieur d’une closure, les variables du code environnant sont invisibles par défaut. Vous devez nommer celles que vous voulez emporter, avec use :
<?php
declare(strict_types=1);

function makeMultiplier(int $factor): callable
{
    return function (int $n) use ($factor): int {
        return $n * $factor;
    };
}

$double = makeMultiplier(2);
$triple = makeMultiplier(3);

echo $double(21) . "\n"; // 42
echo $triple(21) . "\n"; // 63
makeMultiplier(2) s’exécute, $factor vaut 2, et la closure est créée. À cet instant précis, use ($factor) copie la valeur de $factor dans la closure, et c’est cette copie que la closure utilisera pour le reste de sa vie. C’est la règle de la copie par valeur du chapitre 4, appliquée à une fonction plutôt qu’à une variable.
Voilà pourquoi appeler makeMultiplier() deux fois donne deux closures qui se comporteront différemment pour toujours. $double est partie avec une copie de 2, $triple avec une copie de 3, et rien de ce qui arrivera plus tard à une variable nommée $factor, où que ce soit, ne peut les atteindre. Pensez à une photographie : la closure a pris $factor en photo en sortant, et une photo ne change pas quand le sujet change.
Capturer par référence avec use (&$var)
Parfois, une photo ne suffit pas. Vous voulez que la closure partage une variable avec le code qui l’entoure, de sorte qu’un changement d’un côté se voie de l’autre. C’est use (&$var), le même & que vous avez déjà vu sur des paramètres de fonction :
<?php
declare(strict_types=1);

function makeCounter(): callable
{
    $count = 0;

    return function () use (&$count): int {
        $count++;
        return $count;
    };
}

$counter = makeCounter();
echo $counter() . "\n"; // 1
echo $counter() . "\n"; // 2
echo $counter() . "\n"; // 3
$count vit à l’intérieur de makeCounter(), et d’après tout ce que vous savez, elle devrait disparaître quand cette fonction se termine. Elle ne disparaît pas, parce que la closure en détient une référence. La closure et la variable sont désormais deux étiquettes collées sur la même boîte, et chaque appel à $counter() ajoute un à ce qu’elle contient. Plus personne d’autre ne voit $count, mais elle reste en vie aussi longtemps que la closure.
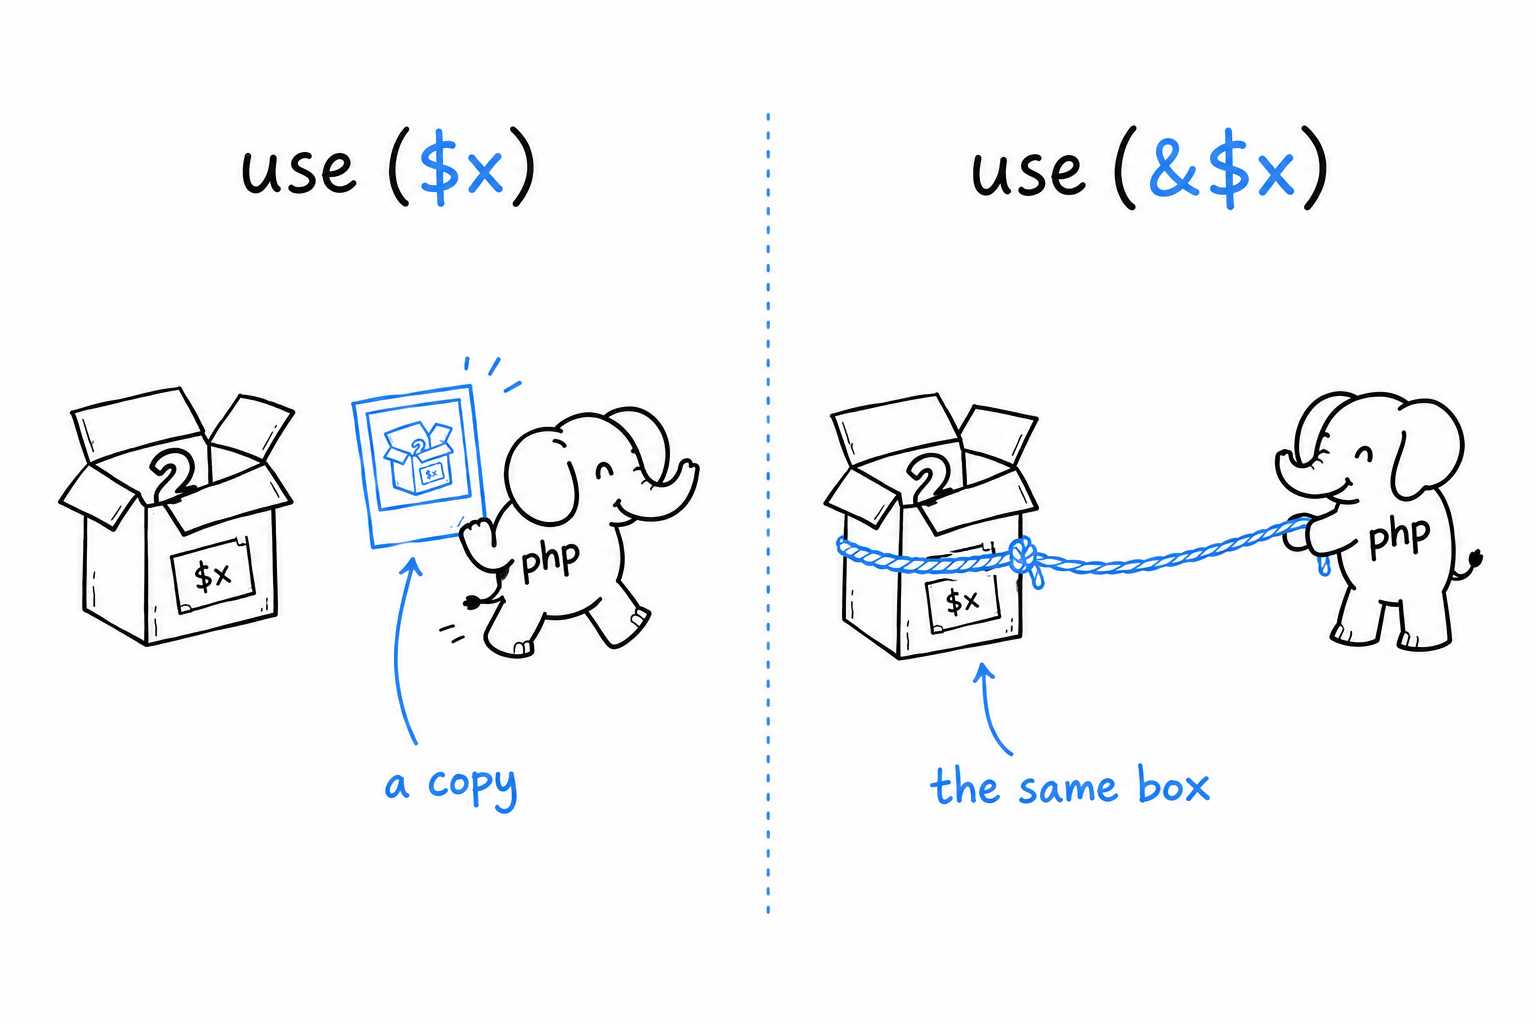
Essayez : retirez le & et relancez le fichier. Chaque appel reçoit maintenant sa propre copie toute neuve de $count, qui part de 0, et le compteur affiche 1, 1, 1. Un seul caractère fait toute la différence entre un instantané et une boîte partagée.
Fonctions fléchées : capturer sans demander
Écrire use pour chaque variable devient vite pénible, surtout pour les fonctions d’une ligne que vous passez à des fonctions comme array_map(). Les fonctions fléchées existent exactement pour ça :
<?php
$factor = 3;
$triple = fn(int $n): int => $n * $factor;

echo $triple(14) . "\n"; // 42
Pas de use nulle part, et $factor est pourtant visible à l’intérieur. Une fonction fléchée capture automatiquement, par valeur, chaque variable qu’elle mentionne dans le code environnant, comme si PHP avait écrit use ($factor) à votre place. Cette commodité est la raison d’être de fn.
Elle vient avec deux limites. Le corps est une seule expression : ce qui suit => est la valeur de retour, sans accolades, sans return, sans instruction avant. Et la capture est toujours par valeur. Il n’existe pas de version fléchée de use (&$var) ; quand il vous faut une référence, vous écrivez une closure complète.
Une closure déclare ce qu’elle capture. Une fonction fléchée capture ce qu’elle utilise, toujours en copie.
Là où on s’en sert vraiment
Vous écrirez beaucoup plus de fonctions fléchées que de closures, parce que la plupart des comportements que vous passez d’une fonction à l’autre sont courts. array_map(), array_filter() et usort() sont leur terrain naturel :
<?php
declare(strict_types=1);

$prices = [10.00, 25.50, 3.99, 100.00];

$withTax = array_map(fn(float $p): float => round($p * 1.2, 2), $prices);

$expensive = array_filter($prices, fn(float $p): bool => $p > 20.00);

usort($prices, fn(float $a, float $b): int => $a <=> $b);
array_map() applique la fonction à chaque élément et renvoie un nouveau tableau avec les résultats. array_filter() garde les éléments pour lesquels la fonction renvoie true, ou tout ce que PHP considère comme vrai. usort() trie le tableau sur place en appelant la fonction pour comparer deux éléments à la fois ; <=>, l’opérateur vaisseau spatial, est la façon standard d’écrire cette comparaison, puisqu’il renvoie un nombre négatif, zéro ou un nombre positif selon lequel des deux est le plus grand.
Aucune des trois n’a eu besoin de plus qu’une fonction fléchée d’une ligne, et c’est précisément le cas pour lequel elles ont été conçues. Réservez la closure complète aux moments où vous devez capturer par référence, ou quand la logique demande plus d’une expression. Le reste du temps, la fonction fléchée est le meilleur choix par défaut.
Traiter une série d’éléments avec les générateurs
Toutes les fonctions que vous avez écrites jusqu’ici pour rendre une série de valeurs l’ont fait de la même manière : construire un tableau, le remplir, le return. Ça marche jusqu’au jour où la série devient si grosse qu’il n’est plus raisonnable de tout construire avant que quiconque ait vu le premier élément. Un générateur est une fonction qui produit ses valeurs une par une, à la demande, au lieu de toutes d’un coup.
La méthode du tableau, et sa limite
Voici une fonction ordinaire qui renvoie les $max premiers carrés :
<?php
declare(strict_types=1);

function squaresUpTo(int $max): array
{
    $result = [];
    for ($i = 1; $i <= $max; $i++) {
        $result[] = $i * $i;
    }
    return $result;
}

foreach (squaresUpTo(5) as $square) {
    echo $square . "\n";
}
Pour cinq carrés, personne ne s’inquiète que squaresUpTo() construise le tableau entier avant que le foreach voie une seule valeur. Pour cinq millions, ce sont cinq millions d’entiers en mémoire avant le moindre affichage. Et si vous ne voulez regarder que les trois premiers, vous payez les cinq millions quand même.
La même fonction, réécrite avec yield
Remplacez return par yield, et changez le type de retour en Generator :
<?php
declare(strict_types=1);

function squaresUpTo(int $max): Generator
{
    for ($i = 1; $i <= $max; $i++) {
        yield $i * $i;
    }
}

foreach (squaresUpTo(5) as $square) {
    echo $square . "\n";
}
Le code appelant n’a pas bougé d’un caractère : foreach ne sait pas, et ne cherche pas à savoir, s’il parcourt un tableau ou un générateur. Ce qui a changé, c’est le moment où le travail se fait. Une fonction qui contient yield n’exécute pas son corps quand vous l’appelez. squaresUpTo(5) renvoie immédiatement un objet Generator, sans rien de calculé dedans. La boucle avance ensuite d’un tour à la fois, quand foreach demande la valeur suivante, et il n’existe jamais qu’un seul carré à la fois.
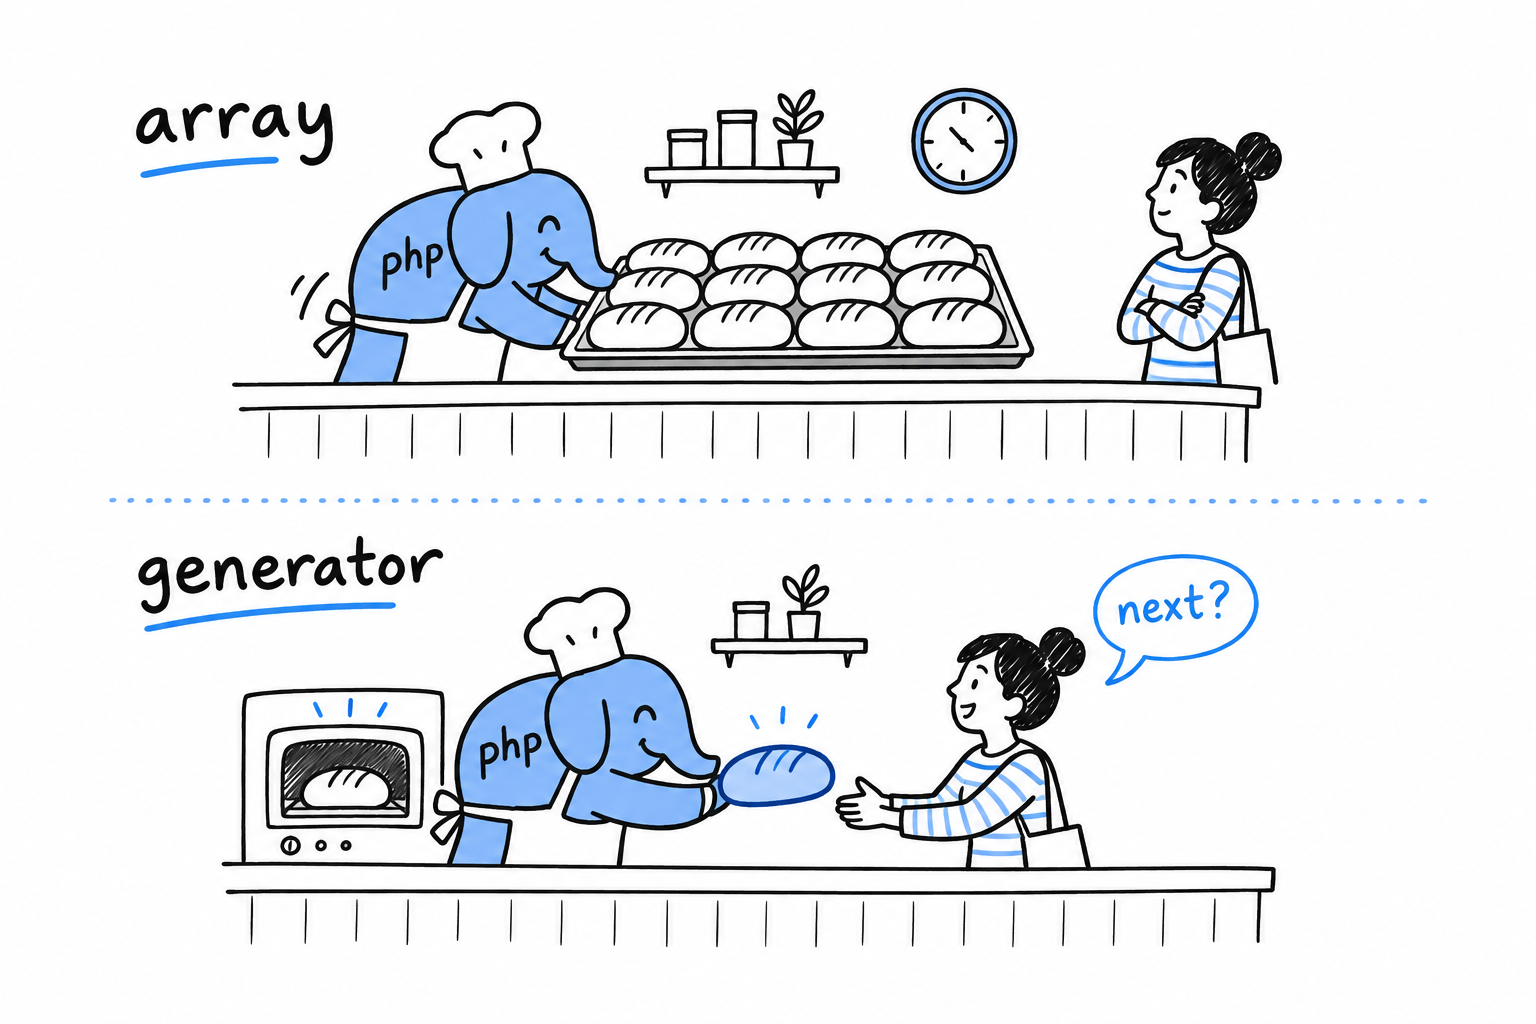
Imaginez une boulangerie. La fonction à tableau cuit tous les pains, les empile sur un plateau et vous tend le plateau. Le générateur vous tend un pain, attend que vous reveniez en chercher un autre, puis cuit le suivant.
Regarder la paresse à l’œuvre
« S’exécute paresseusement », on hoche la tête en le lisant, et on y croit bien mieux quand on le voit :
<?php
function countUp(): Generator
{
    echo "starting\n";
    for ($i = 1; $i <= 3; $i++) {
        echo "about to yield {$i}\n";
        yield $i;
        echo "resumed after {$i}\n";
    }
}

$gen = countUp();
echo "generator created, nothing has run yet\n";

foreach ($gen as $value) {
    echo "got {$value}\n";
}
$ php lazy.php
generator created, nothing has run yet
starting
about to yield 1
got 1
resumed after 1
about to yield 2
got 2
resumed after 2
about to yield 3
got 3
resumed after 3
Regardez l’ordre. Appeler countUp() n’affiche rien, pas même "starting", parce que le corps n’a pas tourné. L’exécution démarre quand foreach réclame la première valeur, et elle s’arrête net sur yield, en tendant 1 à la boucle. "resumed after 1" ne s’affiche que lorsque foreach revient chercher la valeur suivante, et countUp() reprend exactement là où elle s’était arrêtée, au milieu de sa boucle, avec $i et toutes ses variables locales intactes.
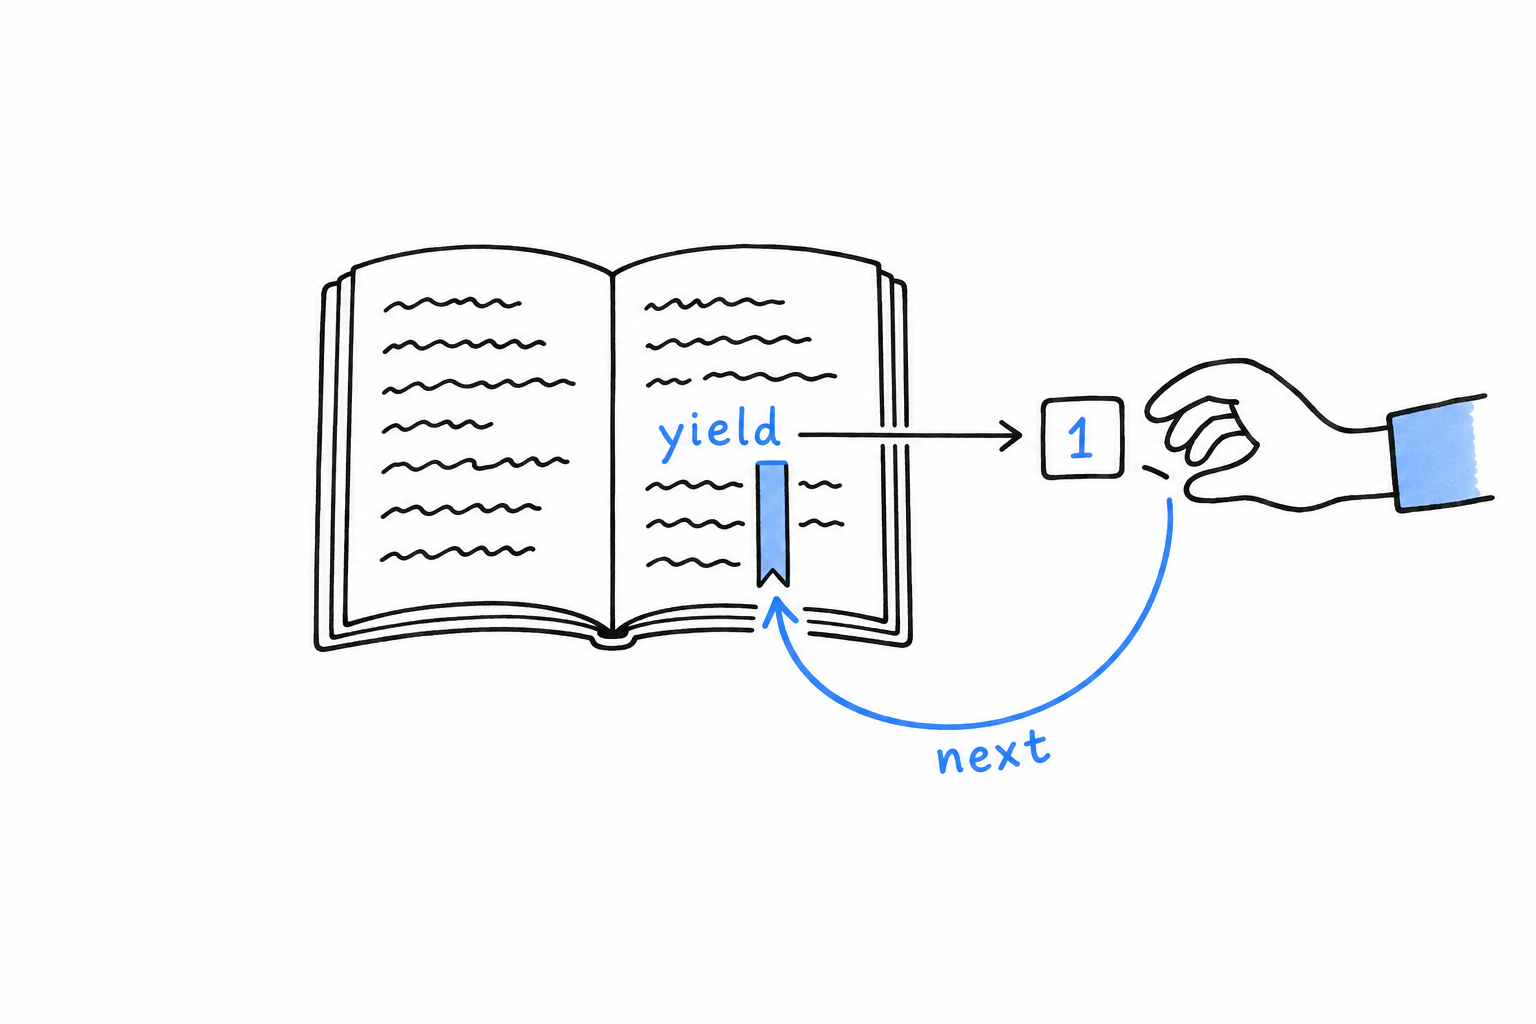
Un générateur est une fonction qu’on peut mettre en pause et reprendre, et yield est l’endroit de la pause. C’est tout le mécanisme.
yieldtend une valeur et laisse un marque-page dans la fonction. La demande suivante rouvre la fonction au marque-page.
Générateurs associatifs
yield sait aussi produire des paires clé-valeur, avec la même syntaxe clé => valeur que pour construire un tableau associatif :
<?php
function statusCodes(): Generator
{
yield 200 => 'OK';
yield 404 => 'Not Found';
yield 500 => 'Internal Server Error';
}
foreach (statusCodes() as $code => $message) {
echo "{$code}: {$message}\n";
}
Tout le reste fonctionne pareil : les paires sortent paresseusement, une à la fois, quand foreach les demande. Un petit détail, mais bien pratique dès que ce que vous produisez a une clé évidente, comme c’est souvent le cas d’un tableau associatif.
Les générateurs ne remplacent pas les tableaux. Beaucoup de code a besoin d’un vrai tableau, qu’on peut indexer, compter, ou passer à array_map(). Les générateurs sont faits pour une série de valeurs dont personne n’a besoin en mémoire toutes en même temps. Plus loin dans ce chapitre, cette idée se met au travail sur un fichier nettement plus gros que cinq carrés.
Améliorer notre projet en ligne de commande
Lancez phpgrep sur un fichier de log de deux gigaoctets et regardez. Rien ne se passe pendant un long moment. Puis toutes les lignes trouvées déboulent d’un coup. La fonction search() que vous avez écrite au chapitre 14 en est la cause :
<?php
declare(strict_types=1);
function search(GrepOptions $options): array
{
$contents = file_get_contents($options->filename);
if ($contents === false) {
throw new RuntimeException("Could not read file: {$options->filename}");
}
$matches = [];
foreach (explode("\n", $contents) as $line) {
$haystack = $options->ignoreCase ? strtolower($line) : $line;
$needle = $options->ignoreCase ? strtolower($options->query) : $options->query;
if (str_contains($haystack, $needle)) {
$matches[] = $line;
}
}
return $matches;
}
Deux choses se produisent en même temps. file_get_contents() lit le fichier entier dans une seule chaîne avant que search() fasse quoi que ce soit d’autre, et $matches grossit tant que la boucle tourne. Avec un demi-million de lignes correspondantes, search() ne rend rien tant qu’elle n’a pas construit un tableau qui les contient toutes. Le fichier complet et toutes les lignes trouvées sont en mémoire en même temps, et l’utilisateur ne voit rien avant que la dernière ligne ait été examinée.
Réécrire search() en générateur
Maintenant que vous connaissez yield, la première correction est directe : cessez d’accumuler dans $matches, et faites un yield de chaque ligne trouvée à l’instant où vous la trouvez. Un second changement va avec. file_get_contents() chargerait encore tout le fichier d’entrée de jeu, alors remplacez-le par fopen() et fgets(), qui lisent une ligne à la fois. Sinon le générateur serait paresseux sur un fichier déjà entièrement en mémoire, ce qui rate la moitié de l’intérêt :
<?php
declare(strict_types=1);
function searchLines(GrepOptions $options): Generator
{
$handle = fopen($options->filename, 'r');
if ($handle === false) {
throw new RuntimeException("Could not read file: {$options->filename}");
}
$needle = $options->ignoreCase ? strtolower($options->query) : $options->query;
while (($line = fgets($handle)) !== false) {
$haystack = $options->ignoreCase ? strtolower($line) : $line;
if (str_contains($haystack, $needle)) {
yield $line;
}
}
fclose($handle);
}
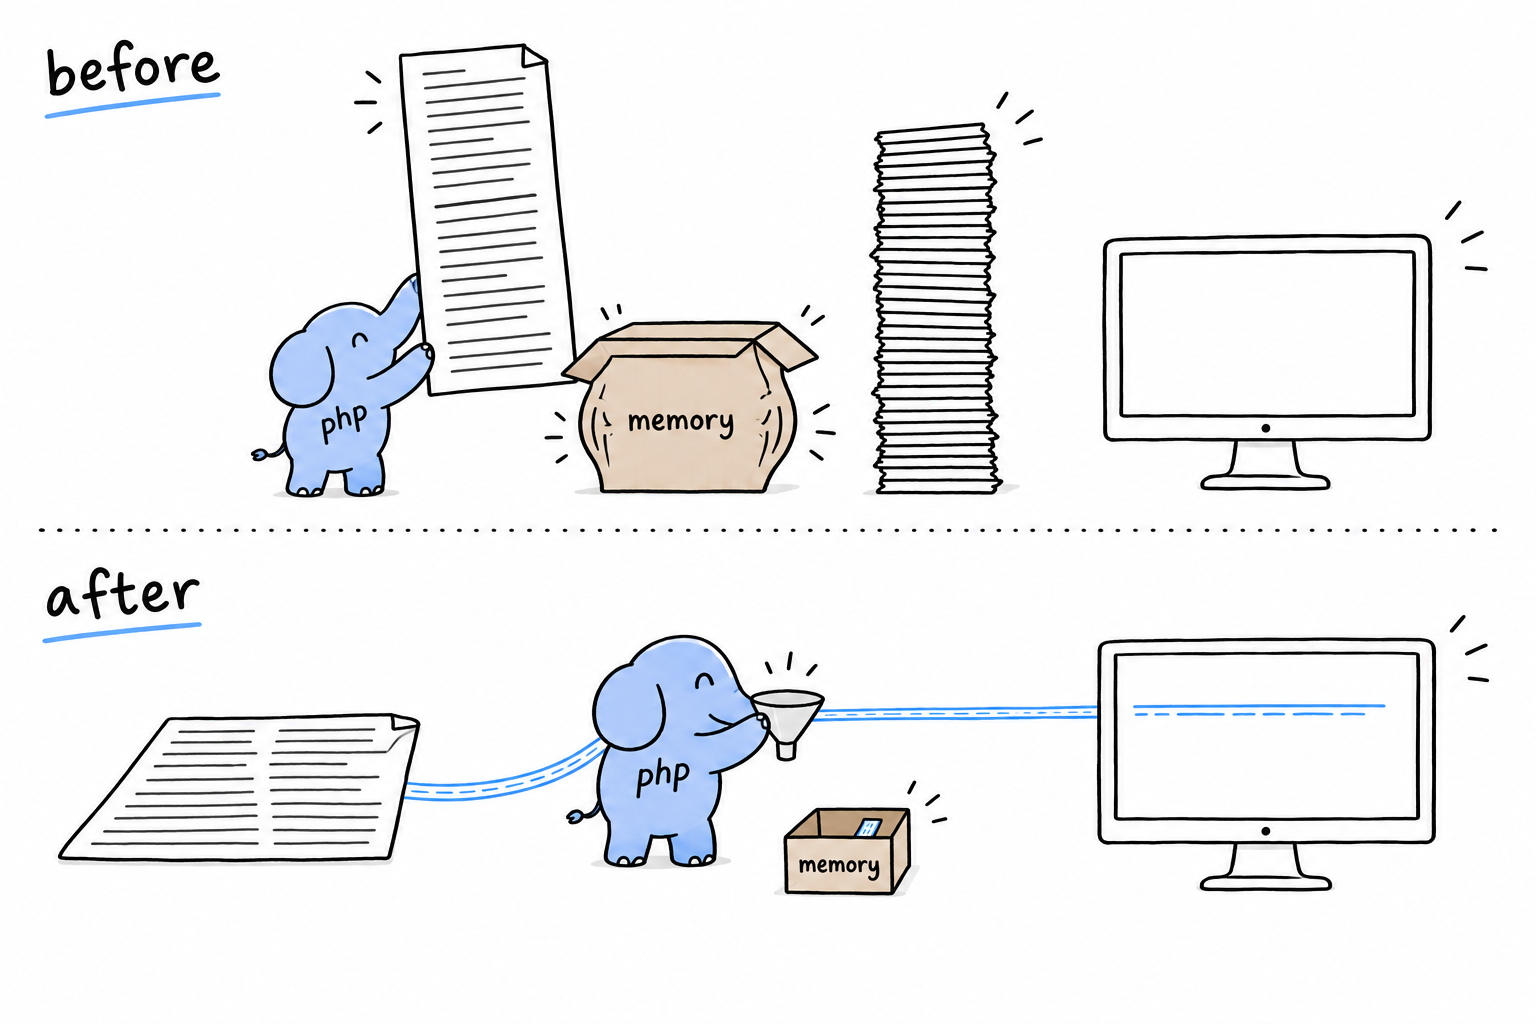
Le fichier est maintenant lu une ligne à la fois, et chaque ligne trouvée sort par yield dès qu’elle est repérée, avant même que la suivante soit lue. À tout moment, la fonction ne tient qu’une ligne, et rien d’autre. Le contrôle d’erreur a bougé lui aussi : plus de file_get_contents() pour échouer, c’est fopen() qui signale un fichier introuvable, avec la même RuntimeException que vous avez rencontrée au chapitre 9.
Cette exception cache une subtilité, qui mérite une explication franche. Comme le corps de searchLines() contient yield, appeler searchLines($options) n’en exécute rien, fopen() compris. L’exception ne part pas quand vous appelez la fonction. Elle part quand quelqu’un commence à itérer. Et ça change l’endroit où il faut l’attraper.
Mettre à jour phpgrep.php
Le script principal change à peine : il boucle toujours sur ce que la recherche lui donne et affiche chaque ligne. Mais le try/catch doit désormais entourer la boucle, pas seulement l’appel :
<?php
declare(strict_types=1);
require __DIR__ . '/vendor/autoload.php';
$options = GrepOptions::fromArgv($argv);
try {
foreach (searchLines($options) as $line) {
echo $line;
}
} catch (RuntimeException $e) {
fwrite(STDERR, "Error: {$e->getMessage()}\n");
exit(1);
}
Essayez la mauvaise version : gardez le try autour du seul appel, placez le foreach après le catch, et lancez phpgrep sur un fichier qui n’existe pas. Le bloc try se termine sans broncher, puisque rien n’a encore ouvert le fichier, et l’exception jaillit du foreach quelques lignes plus bas, sans personne pour l’attraper, avec une trace d’appels à la place de votre message d’erreur bien propre.
Avec un générateur, l’erreur se produit là où les valeurs sont tirées, pas là où la fonction est appelée. Attrapez-la là.
Pourquoi ça vaut le coup
Relancez phpgrep sur ce même fichier de deux gigaoctets. Avec le search() qui renvoie un tableau, vous attendez que le fichier entier soit parcouru, puis un demi-million de lignes s’affichent en une seule rafale, après que le programme les a toutes gardées en mémoire. Avec searchLines(), la première ligne apparaît presque tout de suite, avant que le reste du fichier ait été lu, parce que foreach n’avait besoin que d’une valeur pour commencer à afficher. Et la mémoire reste plate pendant toute l’exécution, quelle que soit la taille du fichier ou le nombre de résultats, parce que le programme ne tient qu’une ligne à la fois. Jamais « toutes les lignes trouvées jusqu’ici », jamais le fichier entier.
C’est le marché que propose un générateur : des résultats plus tôt, et un plafond de mémoire qui ne bouge pas, quelle que soit la taille de l’entrée.
Performances : boucles, générateurs et fonctions de tableau
Élevez deux millions d’entiers au carré et additionnez-les. Vous pouvez l’écrire avec une boucle simple, avec array_map(), ou avec un générateur, et les trois programmes affichent le même nombre. Ils ne coûtent pas la même chose, et le coût veut dire deux choses ici, le temps et la mémoire, qui ne bougent pas toujours ensemble. Plutôt que deviner, mesurons.
Un petit banc d’essai
La même tâche, de trois façons :
<?php
declare(strict_types=1);
const N = 2_000_000;
// 1. plain loop
$sum = 0;
for ($i = 1; $i <= N; $i++) {
$sum += $i * $i;
}
// 2. array functions
$numbers = range(1, N);
$squares = array_map(fn(int $n): int => $n * $n, $numbers);
$sum = array_sum($squares);
// 3. generator
function squares(int $max): Generator {
for ($i = 1; $i <= $max; $i++) {
yield $i * $i;
}
}
$sum = 0;
foreach (squares(N) as $square) {
$sum += $square;
}
Lancez chaque version dans son propre processus, pour que l’une ne gonfle pas le pic de mémoire de l’autre, et mesurez avec hrtime() et memory_get_peak_usage(). Sur la machine qui a servi à écrire ce livre :
loop ~100 ms peak memory: 2 MB
array functions ~140 ms peak memory: 66 MB
generator ~170 ms peak memory: 2 MB
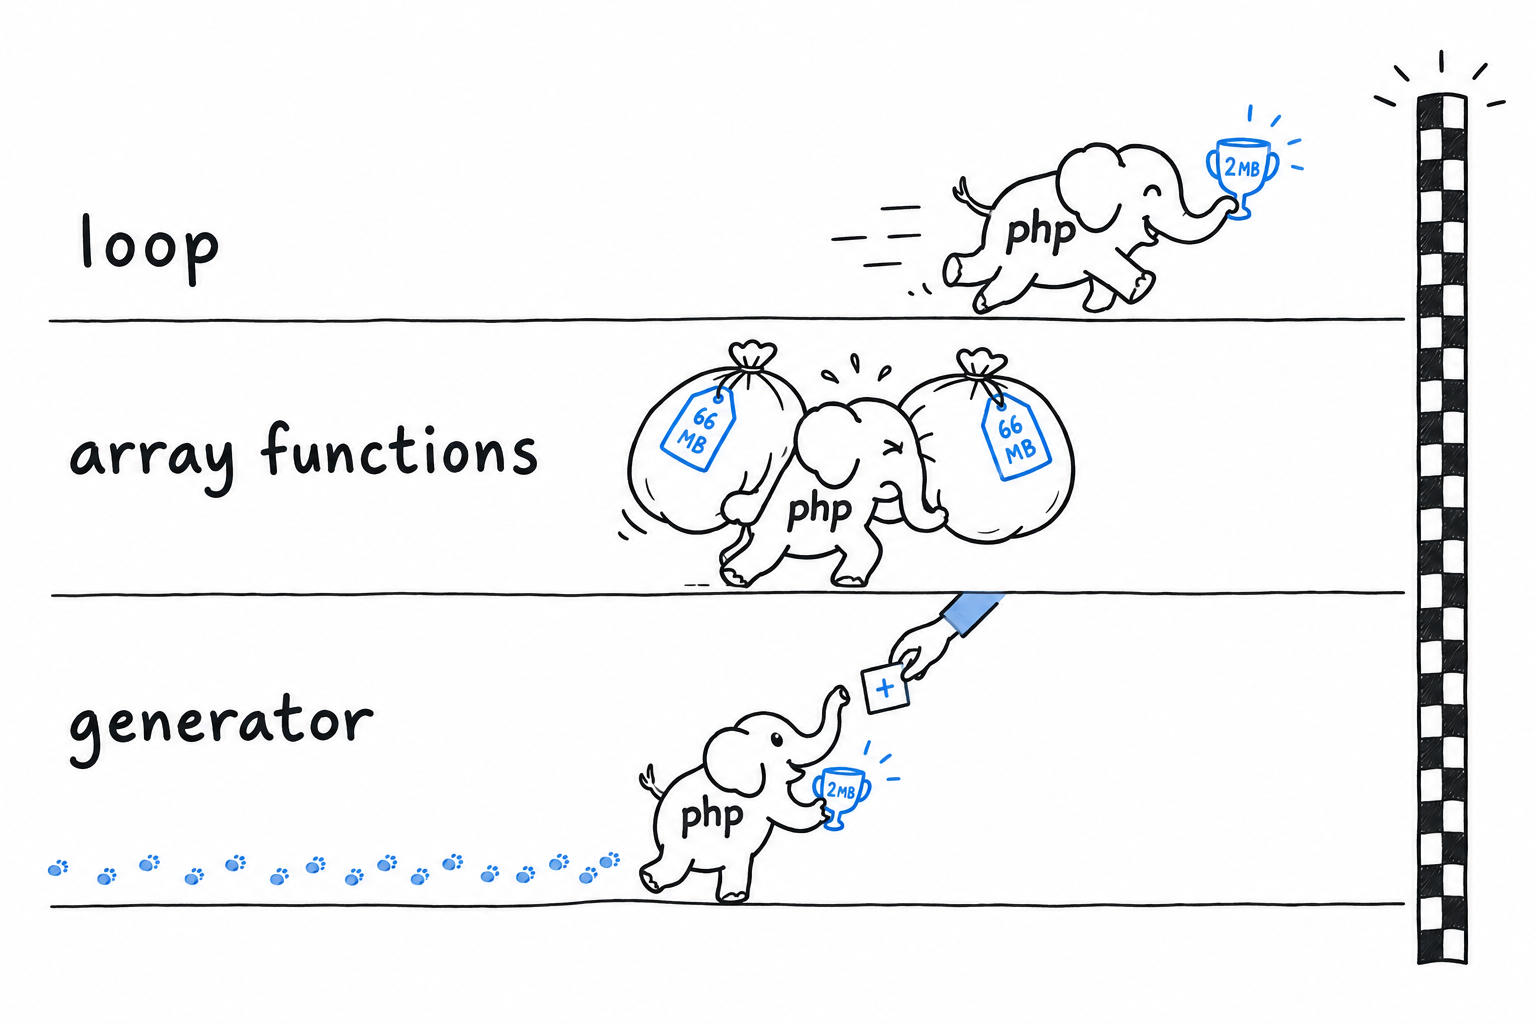
Prenez les chiffres exacts avec des pincettes : ils varient avec votre version de PHP, votre machine et ce qui tourne à côté. La forme du résultat, elle, est fiable. La boucle simple est la plus rapide et la plus sobre, point. La version à fonctions de tableau est la plus lente et de loin la plus gourmande : range() construit un tableau de deux millions d’éléments, puis array_map() en construit un second pour recevoir les carrés, et les deux existent en même temps avant même que array_sum() démarre. Le générateur se place entre les deux en temps, parce que suspendre et reprendre une fonction deux millions de fois a un coût réel, mais il égale la mémoire plate de la boucle, puisqu’il ne tient jamais plus d’une valeur.
Lire ça honnêtement
Rien de tout cela ne signifie « écrivez toujours des boucles ». Les trois outils sont bons à des choses différentes, et en choisir un, c’est savoir laquelle vous cherchez.
Une boucle for ou foreach est l’option la plus rapide, et souvent la plus claire. Il n’y a rien à apprendre, juste une variable qui change à chaque tour. Prenez-la quand la vitesse compte, quand la logique dépasse la transformation d’une ligne, ou chaque fois que vous hésitez. Elle est rarement le mauvais choix par défaut.
Un générateur échange un peu de vitesse contre une mémoire qui ne grossit pas avec l’entrée. Un fichier énorme, une API que vous parcourez page par page, une suite sans fin : c’est son territoire. Vous l’avez vu payer dans phpgrep, qui affiche sa première ligne avant d’avoir fini le fichier. Si toute la série tenait confortablement en mémoire de toute façon, le surcoût de la pause-reprise ne vous apporte rien.
array_map() et array_filter() sont souvent l’option la plus lisible pour des données petites ou moyennes déjà en mémoire. Un array_map(fn($x) => ..., $items) d’une ligne se lit mieux que la boucle de cinq lignes qu’il remplace, et c’est un vrai gain. Ce qu’ils ne sont pas, c’est une économie de mémoire : chacun construit un tableau tout neuf en plus de celui que vous lui donnez. Pour cent éléments, sans importance. Pour des millions, ce sont les 66 Mo que vous venez de voir.
Une règle de décision, pas un tableau
Si les données sont assez petites pour que vous n’hésitiez jamais à les garder toutes en mémoire, prenez ce qui se lit le mieux à l’endroit de l’appel : en général une fonction de tableau pour une transformation simple, une boucle pour tout ce qui contient de la vraie logique. Si les données sont grosses, sans limite connue ou coûteuses à produire (un gros fichier, un curseur de base de données, tout ce que vous parcourez page par page), prenez un générateur et acceptez le léger surcoût en échange d’une mémoire qui ne bouge pas. Et si vous courez après la vitesse brute sur un chemin critique, et que vous avez mesuré que ça compte, la boucle simple reste, discrètement, la chose la plus rapide que PHP vous offre.
Petites données : ce qui se lit le mieux. Grosses données : un générateur. Chemin critique : une boucle, une fois que vous avez mesuré.
Ne devinez pas quel cas est le vôtre. Le banc d’essai ci-dessus tient en une douzaine de lignes. Mesurez le vôtre, si la question mérite d’être posée.
Composer et Packagist, plus en profondeur
Depuis le chapitre 7, Composer fait un seul travail pour vous : lire composer.json, télécharger les paquets qui y sont listés, et retrouver vos classes par leur nom grâce à une ligne PSR-4. Cela couvre l’essentiel d’une journée de travail. Ce n’est pourtant pas tout ce que Composer sait faire, et le reste devient utile le jour où votre projet cesse d’être « un paquet, un dépôt ».
Les deux premiers ajouts tiennent dans le composer.json que vous avez déjà. Une section "scripts" transforme les commandes que vous tapez à longueur de journée en sous-commandes Composer courtes, et une seconde forme d’autoload, "files", se charge des fichiers de fonctions que PSR-4 n’a aucun moyen de trouver.
Puis le champ s’élargit. Packagist est le registre public derrière chaque composer require, et il vaut la peine de savoir comment un paquet y arrive. Petit spoiler : personne ne téléverse quoi que ce soit. Viennent ensuite les dépôts de type path, le mécanisme qui permet de développer deux paquets locaux côte à côte avant d’en publier un seul, et la forme sur laquelle reposent la plupart des monorepos PHP.
Deux dernières étapes se situent un peu en dehors de tout projet : installer des outils en ligne de commande une seule fois, globalement, plutôt qu’une copie par projet, et un regard court et honnête sur les hooks que Composer déclenche autour de son propre cycle de vie, avec la porte qu’il laisse ouverte aux plugins.
Personnaliser l’autoload et les scripts
Jusqu’ici, votre composer.json faisait deux choses : lister les dépendances, et associer un espace de noms à un dossier. Deux entrées de plus, quelques lignes chacune, méritent d’entrer tout de suite dans vos habitudes.
Les scripts : des raccourcis pour les commandes de tous les jours
Pensez aux commandes que vous tapez dix fois par jour dans un projet : la suite de tests, le linter, un vidage de cache. Chacune a son nom, ses options, et un collègue qui la tape légèrement autrement. Composer vous laisse donner à chacune un nom court, dans la section "scripts" de composer.json :
{
"name": "you/phpgrep",
"require": {},
"require-dev": {
"phpunit/phpunit": "^11.0"
},
"scripts": {
"test": "phpunit",
"check": "phpstan analyse src"
}
}
Lancez l’une ou l’autre avec composer run, ou, quand le nom n’entre pas en collision avec une commande intégrée de Composer, avec composer suivi directement du nom :
$ composer test
$ composer check
Économiser quelques frappes, c’est le petit gain. Le grand se voit en équipe. Tout le monde lance composer test, que l’outil dessous soit PHPUnit, Pest ou autre chose, et quelles que soient les options dont il a besoin. Changez d’outil ou modifiez une option, et chaque développeur, chaque pipeline d’intégration continue récupère le changement à sa prochaine exécution, sans rien toucher de son côté. Le nom du script est le contrat ; la commande derrière est un détail.
Quand une tâche a vraiment besoin de plusieurs étapes, une entrée peut être une liste de commandes, exécutées dans l’ordre :
{
"scripts": {
"check": [
"phpstan analyse src",
"phpunit"
]
}
}
Essayez : composer run --list affiche tous les scripts qu’un projet définit. C’est le moyen le plus rapide de prendre ses repères dans un dépôt que l’on vient de cloner.
L’autoload "files" : pour le code qui n’est pas une classe
PSR-4, vu au chapitre 7, fonctionne comme une bibliothèque bien rangée : demandez une classe par son nom, et Composer sait quelle étagère et quel fichier. Un fichier rempli de simples fonctions n’a pas de nom de classe à demander, alors PSR-4 passe devant sans s’arrêter. Pour ce cas, composer.json a un second mécanisme, "files" : une liste de fichiers chargés chaque fois que l’autoloader démarre, sans poser de question :
{
"autoload": {
"psr-4": {
"PhpGrep\\": "src/"
},
"files": [
"src/helpers.php"
]
}
}
Tout ce qui est défini au premier niveau de src/helpers.php, fonctions et constantes, devient disponible partout dans le projet dès que vendor/autoload.php est inclus. Pas de use, exactement comme une fonction native telle que strtolower() n’en demande pas.
Cette commodité a un prix. Une classe PSR-4 n’est chargée que lorsque quelque chose y fait référence. Une entrée "files" est chargée à chaque requête, que la requête s’en serve ou non. Réservez la liste à une poignée de petites fonctions vraiment globales, et laissez PSR-4 gérer tout ce qui a raisonnablement sa place dans une classe.
PSR-4 charge une classe quand on la demande.
"files"charge un fichier à chaque fois.
Après avoir modifié l’une ou l’autre section à la main, il reste une étape : composer dump-autoload, pour que Composer régénère l’autoloader en accord avec ce que vous venez d’écrire. composer install et composer require le font pour vous ; une modification manuelle, non, tant que vous ne le demandez pas.
Publier un paquet sur Packagist
Chaque composer require que vous avez tapé s’est appuyé sur un service que vous n’avez jamais eu à nommer : Packagist, le registre public que Composer consulte par défaut. C’est pour cela que composer require nunomaduro/termwind, au chapitre 7, n’a demandé ni URL ni serveur. Packagist savait déjà où vivait ce paquet. Y déposer votre propre paquet est plus simple qu’il n’y paraît, et le mécanisme mérite d’être compris, parce qu’il explique ce que « publier un paquet PHP » veut vraiment dire.
Ce qu’il faut à un composer.json publiable
Quatre choses, au minimum :
{
"name": "yourname/phpgrep",
"description": "A small line-searching CLI tool, built as a learning project.",
"license": "MIT",
"require": {
"php": ">=8.1"
},
"autoload": {
"psr-4": {
"PhpGrep\\": "src/"
}
}
}
"name" a une forme fixe, vendor/package, tout en minuscules, les mots séparés par des tirets. La partie vendor est en général votre nom d’utilisateur ou votre organisation GitHub, pas une raison sociale ; beaucoup de paquets publiés appartiennent à une seule personne. "description" et "license" sont ce que les visiteurs lisent sur votre page Packagist. La licence compte pour une raison très concrète : sans elle, personne ne sait à quelles conditions il a légalement le droit d’utiliser votre code, et ce genre de doute fait fuir les utilisateurs sans bruit. "MIT" est le choix permissif courant quand vous n’avez pas de raison d’en préférer un autre.
Vous ne téléversez rien
C’est la partie qui surprend ceux qui viennent d’écosystèmes dotés d’une commande publish. Packagist n’héberge pas votre code. Il héberge des informations sur votre code, et lit la source directement dans votre dépôt Git, GitHub compris.
Publier tient en trois gestes. Poussez un composer.json comme celui ci-dessus dans un dépôt Git public. Connectez-vous sur packagist.org, cliquez sur « Submit » et collez l’URL de votre dépôt. Packagist lit alors votre composer.json, indexe le paquet sous le "name" que vous lui avez donné et, c’est le point important, installe un webhook pour être prévenu de chacun de vos push à partir de là.
Pas d’étape de publication, pas d’archive à remettre. Packagist surveille votre dépôt.
Packagist est un annuaire, pas un entrepôt. Il sait où vit votre code et y envoie Composer.
Les versions viennent des tags Git
Si Packagist lit votre dépôt, d’où sort une version comme 1.2.0 ? D’un tag Git ordinaire, nommé selon le versionnage sémantique : MAJOR.MINOR.PATCH.
$ git tag v1.0.0
$ git push origin v1.0.0
Poussez le tag, le webhook se déclenche, et 1.0.0 apparaît comme version installable quelques instants plus tard. Le tag, c’est la release. Il n’y a rien d’autre à faire.
Les trois nombres portent une promesse. Incrémentez le patch pour un correctif qui ne casse rien, le mineur pour une fonctionnalité qui ne casse rien, et le majeur dès que vous cassez quelque chose sur lequel un utilisateur pourrait compter. Cette dernière règle est celle qui compte pour quiconque dépend de vous : c’est elle qui lui permet d’écrire ^1.0 dans son propre composer.json et de faire confiance à tout ce qui y correspond pour ne pas casser son code.
Dépôts de type path et monorepos
Publier suppose que votre paquet soit assez fini pour être confié à des inconnus. Une bonne partie du vrai travail se fait avant, dans la période où deux paquets liés grandissent ensemble et où un changement dans l’un doit apparaître dans l’autre immédiatement. Composer a un type de dépôt conçu pour cette période : le dépôt path.
Le problème qu’il résout
Imaginons que vous coupiez phpgrep en deux : une bibliothèque cœur, phpgrep/core, et une enveloppe en ligne de commande, phpgrep/cli, qui en dépend. Tapez composer require phpgrep/core dans le paquet CLI, et Composer revient les mains vides. Packagist n’a jamais entendu parler du cœur, et aucun autre registre non plus. Vous pourriez publier une version à moitié finie juste pour vous débloquer, mais c’est prendre le problème à l’envers : vous publieriez du code dans le seul but de le tester sur votre propre machine.
Pointer Composer vers un dossier local
Un dépôt path dit à Composer, pour un projet donné : quand tu rencontres ce nom de paquet, ne cherche pas sur Packagist, cherche dans ce dossier sur le disque.
{
"repositories": [
{
"type": "path",
"url": "../phpgrep-core"
}
],
"require": {
"phpgrep/core": "*"
}
}
Avec une arborescence comme celle-ci :
projects/
├── phpgrep-core/
│ └── composer.json ("name": "phpgrep/core")
└── phpgrep-cli/
└── composer.json (the file above)
lancer composer install dans phpgrep-cli résout phpgrep/core vers ../phpgrep-core. Par défaut, Composer ne copie pas le dossier. Il crée un lien symbolique dans vendor/phpgrep/core, qui renvoie au vrai dossier.
Modifiez un fichier dans phpgrep-core, et phpgrep-cli voit le changement à l’instant. Pas de réinstallation, pas de publication, rien à lancer entre les deux. Au quotidien, on dirait un seul paquet. Il en reste pourtant deux, chacun avec son composer.json, ses propres contraintes de version, et sa propre route vers Packagist le moment venu.
Essayez : dans phpgrep-cli, lancez ls -l vendor/phpgrep et lisez la flèche que ls dessine à côté de core. Cette flèche, c’est le lien symbolique.
Où cela mène : les monorepos
Mettez plusieurs paquets liés dans un seul dépôt Git, chacun avec son composer.json, reliés par des dépôts path qui pointent vers les sous-dossiers les uns des autres, et vous obtenez la forme que prennent la plupart des monorepos PHP. Il n’existe pas de mode monorepo dans Composer. Un monorepo est une arborescence ordinaire de paquets qui partagent un dépôt et se désignent mutuellement pendant le développement.
Certaines équipes s’en tiennent là pour de bon et livrent le monorepo tel quel. D’autres y voient une commodité de développement et, quand un paquet se stabilise, le déplacent dans son propre dépôt pour le publier seul sur Packagist. Les deux se défendent. Le choix dépend de la façon dont votre équipe publie, pas de ce que Composer impose.
Installer des outils globaux avec Composer
Tout ce que vous installez avec Composer n’appartient pas à un projet. Un analyseur statique comme PHPStan ou un formateur comme PHP-CS-Fixer est un outil que vous emportez avec vous, pour le lancer sur le projet dans lequel vous vous trouvez. Composer a une commande à part pour ce genre d’outils.
require --dev ou global require
Vous connaissez déjà require-dev : une dépendance nécessaire seulement pendant le développement, comme PHPUnit, listée dans le composer.json du projet et installée dans son dossier vendor/ :
$ composer require --dev phpunit/phpunit
C’est le bon choix pour tout ce dont les tests ou la construction du projet dépendent. Quiconque clone le dépôt et lance composer install obtient la même version, et cette reproductibilité compte. C’est le mauvais choix pour un outil que vous aimez lancer partout, quoi qu’un projet déclare. Dix projets, dix copies de PHPStan dans dix dossiers vendor/, en dix versions potentiellement différentes : beaucoup de doublons pour quelque chose qui n’appartient à aucun d’eux.
composer global require l’installe une seule fois :
$ composer global require phpstan/phpstan
PHPStan atterrit dans un répertoire Composer global, à l’écart de tout projet : ~/.config/composer sous Linux, ~/.composer sous macOS par défaut, et le chemin exact mérite d’être vérifié avec composer global config home. À partir de là, il n’y a plus qu’une seule installation partagée, quel que soit le répertoire où vous vous trouvez.
Le mettre dans votre PATH
Installer globalement ne fait pas, à lui seul, de phpstan une commande que votre shell connaît. Le binaire se trouve dans un dossier vendor/bin à l’intérieur de ce répertoire global, et votre shell ne regarde que dans les dossiers listés dans PATH :
$ export PATH="$HOME/.composer/vendor/bin:$PATH"
Placez cette ligne dans le fichier de démarrage de votre shell (~/.zshrc, ~/.bashrc ou l’équivalent) pour que chaque nouveau terminal en profite, puis vérifiez :
$ phpstan --version
PHPStan - PHP Static Analysis Tool 1.11.5
Si la commande est introuvable, la ligne PATH est presque toujours la coupable. Elle manque, elle pointe vers le mauvais répertoire pour votre plateforme, ou vous avez modifié le fichier de démarrage sans jamais le recharger (source ~/.zshrc, ou ouvrez un nouveau terminal).
Choisir entre les deux
Un outil qui doit tourner à l’identique pour tout le monde, intégration continue comprise, à une version figée dans le gestionnaire de versions, va dans require-dev. Un outil personnel que vous lancez sur tous vos projets, et dont la version peut différer d’un cran de celle d’un collègue sans que personne s’en émeuve, va dans composer global require. Beaucoup de configurations utilisent les deux : PHPStan figé par projet pour que l’intégration continue soit reproductible, et PHP-CS-Fixer installé globalement pour un formatage rapide en cours d’édition.
Étendre Composer avec des scripts et des plugins
composer test et composer check sont des scripts que vous lancez vous-même. Les scripts ont un second usage, plus discret. Accrochez-en un à un moment du cycle de vie de Composer, et il s’exécute tout seul, au bon moment, sans que personne ait à y penser.
Les événements du cycle de vie
Composer émet un événement nommé à chaque étape de son travail : avant et après une installation, avant et après une mise à jour, et quelques autres. Utilisez l’un de ces noms comme clé de script, au lieu d’en inventer un, et Composer l’appelle quand le moment arrive :
{
"scripts": {
"post-install-cmd": "@php artisan-like-thing:setup",
"post-update-cmd": [
"@php bin/generate-config.php"
]
}
}
post-install-cmd s’exécute après chaque composer install : un clone frais qui récupère ses dépendances, un job d’intégration continue qui se prépare avant les tests, un nouveau collègue à son premier jour. Personne n’a à dénicher l’étape supplémentaire enfouie dans un README, parce que Composer s’en charge, dans le bon ordre, à chaque fois. post-update-cmd est le même hook pour composer update. D’autres événements existent pour des moments plus précis, avant l’installation ou la suppression d’un seul paquet par exemple, mais ces deux-là couvrent la plupart des besoins réels : régénérer un fichier de configuration, préchauffer un cache, afficher un rappel sur une variable d’environnement encore à définir.
Tip
Le préfixe
@phplance le script avec le binaire PHP sous lequel Composer tourne lui-même. Sur une machine où plusieurs versions de PHP sont installées, il lève tout doute sur lephputilisé.
Où s’arrêtent les scripts, où commencent les plugins
Un script de cycle de vie est une commande que Composer lance à un point fixe. C’est utile, et ce n’est que cela. Parfois vous voulez davantage : une nouvelle commande Composer, une autre façon d’installer les paquets, une réaction à un événement écrite en vraie logique PHP plutôt qu’une ligne de shell lancée à l’aveugle. C’est à cela que servent les plugins : des paquets Composer ordinaires qui se branchent sur les entrailles de Composer, écrits en PHP, installés comme n’importe quelle dépendance. Vous en avez sans doute déjà utilisé un sans le savoir ; la gestion automatique des fichiers .env dans certains frameworks est un plugin Composer sous le capot.
En écrire un est une démarche légitime, et c’est du vrai territoire interne à Composer : classes d’abonnés aux événements, API de plugins propre à Composer, bien au-delà de ce que ce livre couvre. Quand les scripts de cycle de vie ne suffisent plus, c’est la porte suivante, et la documentation officielle de Composer est l’endroit où commencer.
PHP orienté objet
Ouvrez un framework, une bibliothèque, presque n’importe quel fichier PHP écrit par quelqu’un d’autre, et vous y trouverez des classes bâties sur d’autres classes. Le chapitre 5 vous a appris à écrire une classe. Le chapitre 11 vous a appris à faire promettre la même chose à des classes sans lien, grâce aux interfaces. Ce chapitre est celui où ces pièces deviennent une conception.
Un seul exemple traverse tout le chapitre : une boutique qui accepte plusieurs moyens de paiement. Une carte bancaire et un compte PayPal font le même travail de deux façons différentes, et c’est précisément la situation pour laquelle la programmation orientée objet a été inventée. Vous ferez reposer une classe sur une autre avec extends, vous remplacerez ce qui doit changer en gardant le reste grâce à parent::, puis vous toucherez la récompense. Un code écrit une seule fois contre l’idée générale de « moyen de paiement » fonctionne avec chaque moyen concret que vous lui confiez, y compris ceux que vous n’avez pas encore écrits. Cette propriété porte un nom, le polymorphisme, et c’est la raison d’être de l’héritage.
Les classes abstraites et les interfaces sont ensuite posées côte à côte. Elles résolvent des problèmes qui se recouvrent, et choisir entre les deux est une décision de conception, pas une affaire de goût.
La seconde moitié du chapitre se tourne vers les méthodes magiques de PHP, une poignée de méthodes au nom particulier que le langage appelle de lui-même quand un objet est affiché, utilisé comme une chaîne de caractères, ou interrogé sur une propriété qu’il n’a pas. Certaines sont des outils de tous les jours. D’autres rendent le code plus difficile à lire que le code répétitif qu’elles économisent, et le chapitre dit lesquelles.
L’exemple des paiements finit assemblé en un design pattern classique, Strategy, avec pour seuls ingrédients les interfaces et le polymorphisme que vous aurez déjà en main. Les patterns ont une réputation d’abstraction. Voir l’un d’eux se construire à partir de pièces familières, pour résoudre un problème que vous rencontrez vraiment, devrait régler son compte à cette réputation.
Classes, héritage et polymorphisme
Une boutique accepte les cartes bancaires. Puis PayPal. Le trimestre prochain, elle acceptera les virements. Chacun débite l’argent à sa manière, et pourtant, vu de la caisse, tous sont la même chose : une façon de payer. L’héritage est le moyen de dire à PHP que plusieurs classes sont des variations d’une même idée, qui partagent ce qu’elles ont en commun et ne diffèrent que là où il le faut. Depuis le chapitre 5, chaque classe que vous avez écrite vivait seule. Il est temps d’en apparenter quelques-unes.
extends et la redéfinition de méthode
Une classe se construit sur une autre avec extends : elle hérite de ses propriétés et de ses méthodes, et remplace celles qui doivent se comporter autrement :
<?php
declare(strict_types=1);
class PaymentMethod
{
public function charge(float $amount): string
{
return sprintf('Charged $%.2f.', $amount);
}
}
class CreditCard extends PaymentMethod
{
public function __construct(private string $last4)
{
}
public function charge(float $amount): string
{
$base = parent::charge($amount);
return $base . " (card ending {$this->last4})";
}
}
Lisez class CreditCard extends PaymentMethod comme « une carte bancaire est un moyen de paiement ». Tout ce que PaymentMethod sait faire, CreditCard le sait aussi, sans une ligne de plus. La seule méthode que CreditCard définit pour elle-même est charge(), et comme le parent en a déjà une, la version de l’enfant prend sa place. C’est ce qu’on appelle redéfinir une méthode.
Regardez maintenant la première ligne de la redéfinition. parent::charge($amount) appelle le charge() d’origine du parent, celui-là même qui vient d’être remplacé, et s’appuie sur son résultat au lieu de le jeter. parent::, c’est la façon dont une redéfinition dit « fais ce que tu allais faire, puis laisse-moi ajouter quelque chose ». La classe de base met toujours le montant en forme ; CreditCard ne fait qu’y accoler les quatre derniers chiffres. Sans parent::, cette ligne de sprintf() serait recopiée dans chaque sous-classe, exactement la duplication que l’héritage est censé éliminer.
extendsdit « est un ».parent::dit « et aussi ».
Une deuxième sous-classe
Ajoutez un autre moyen de paiement de la même façon, avec un charge() qui fait tout autre chose :
<?php
declare(strict_types=1);
class PayPal extends PaymentMethod
{
public function __construct(private string $email)
{
}
public function charge(float $amount): string
{
return sprintf('Charged $%.2f via PayPal account %s.', $amount, $this->email);
}
}
PayPal n’appelle jamais parent::charge(). Rien n’oblige une redéfinition à réutiliser la version du parent ; elle doit seulement exister. Une sous-classe peut garder le comportement du parent, le compléter, ou le remplacer entièrement, et ces trois usages de l’héritage sont aussi ordinaires les uns que les autres. CreditCard et PayPal partagent la promesse que tout PaymentMethod sait faire charge(), et une seule des deux partage du code.
Le polymorphisme : la vraie récompense
Voici pourquoi tout cela valait la peine. Écrivez une fonction contre le type de base et confiez-lui n’importe quelle sous-classe :
<?php
declare(strict_types=1);
function processPayment(PaymentMethod $method, float $amount): void
{
echo $method->charge($amount) . "\n";
}
$methods = [
new CreditCard('4242'),
new PayPal('damien@example.com'),
];
foreach ($methods as $method) {
processPayment($method, 42.00);
}
$ php payments.php
Charged $42.00. (card ending 4242)
Charged $42.00 via PayPal account damien@example.com.
processPayment() demande un PaymentMethod. Elle ne mentionne jamais CreditCard ni PayPal. Donnez-lui pourtant l’un ou l’autre, et c’est le bon charge() qui s’exécute. Le même appel, $method->charge($amount), fait ce qu’il faut quel que soit l’objet réellement caché derrière $method. C’est cela, le polymorphisme.
Pensez à une boîte aux lettres. Peu lui importe qui a écrit l’enveloppe, seulement qu’elle passe par la fente. PaymentMethod, c’est la fente, et chaque sous-classe est une enveloppe taillée à cette mesure, y compris celles que personne n’a encore écrites. Ajoutez BankTransfer le mois prochain : tant qu’elle étend PaymentMethod et implémente charge(), ni processPayment() ni la boucle ne changent. Elles n’ont jamais été écrites contre une classe précise, seulement contre la forme que tout PaymentMethod garantit.
Essayez : écrivez BankTransfer, ajoutez new BankTransfer() au tableau $methods, relancez. Comptez les lignes que vous avez modifiées dans processPayment().
Cela devrait vous rappeler quelque chose. C’est le même geste que programmer contre une interface au chapitre 11 : interfaces et héritage sont deux routes vers la même destination, un code qui n’a pas besoin de savoir quelle classe concrète il tient. La section suivante met les deux routes côte à côte et demande quand prendre laquelle.
Classes abstraites et interfaces, deuxième passage
Rien ne vous empêche d’écrire new PaymentMethod() et de lui débiter quarante-deux dollars. La classe de base de la section précédente a un charge() qui fonctionne, alors PHP obéit, et l’argent est « débité » sur un moyen de paiement qui n’est rattaché à aucune carte, aucun compte, rien du tout. PaymentMethod n’a jamais été conçue que comme une fondation pour ses sous-classes, mais un commentaire qui le dit n’est pas une règle. abstract transforme cette intention en quelque chose que PHP fait respecter.
Rendre le contrat explicite
<?php
declare(strict_types=1);
abstract class PaymentMethod
{
abstract public function charge(float $amount): string;
protected function receipt(float $amount): string
{
return sprintf('$%.2f processed on %s', $amount, date('Y-m-d'));
}
}
class CreditCard extends PaymentMethod
{
public function __construct(private string $last4)
{
}
public function charge(float $amount): string
{
return $this->receipt($amount) . " (card ending {$this->last4})";
}
}
Deux choses ont changé. abstract class PaymentMethod signifie que PHP refuse new PaymentMethod() tout net : une erreur fatale, imposée par le langage plutôt que laissée à une convention que vous espérez voir respectée. Et charge() est devenue abstract public function charge(float $amount): string;, une signature sans corps, exactement comme une méthode d’interface. Toute sous-classe non abstraite doit désormais implémenter charge(), sinon PHP refuse aussi de charger cette sous-classe.
Ce que la classe de base a gardé, c’est receipt() : une vraie méthode, qui fonctionne, dont chaque sous-classe hérite gratuitement. Ce couple est tout l’intérêt d’une classe abstraite. Un contrat que le langage fait respecter, livré avec du code partagé écrit une seule fois. Une simple interface ne peut vous donner que la première moitié.
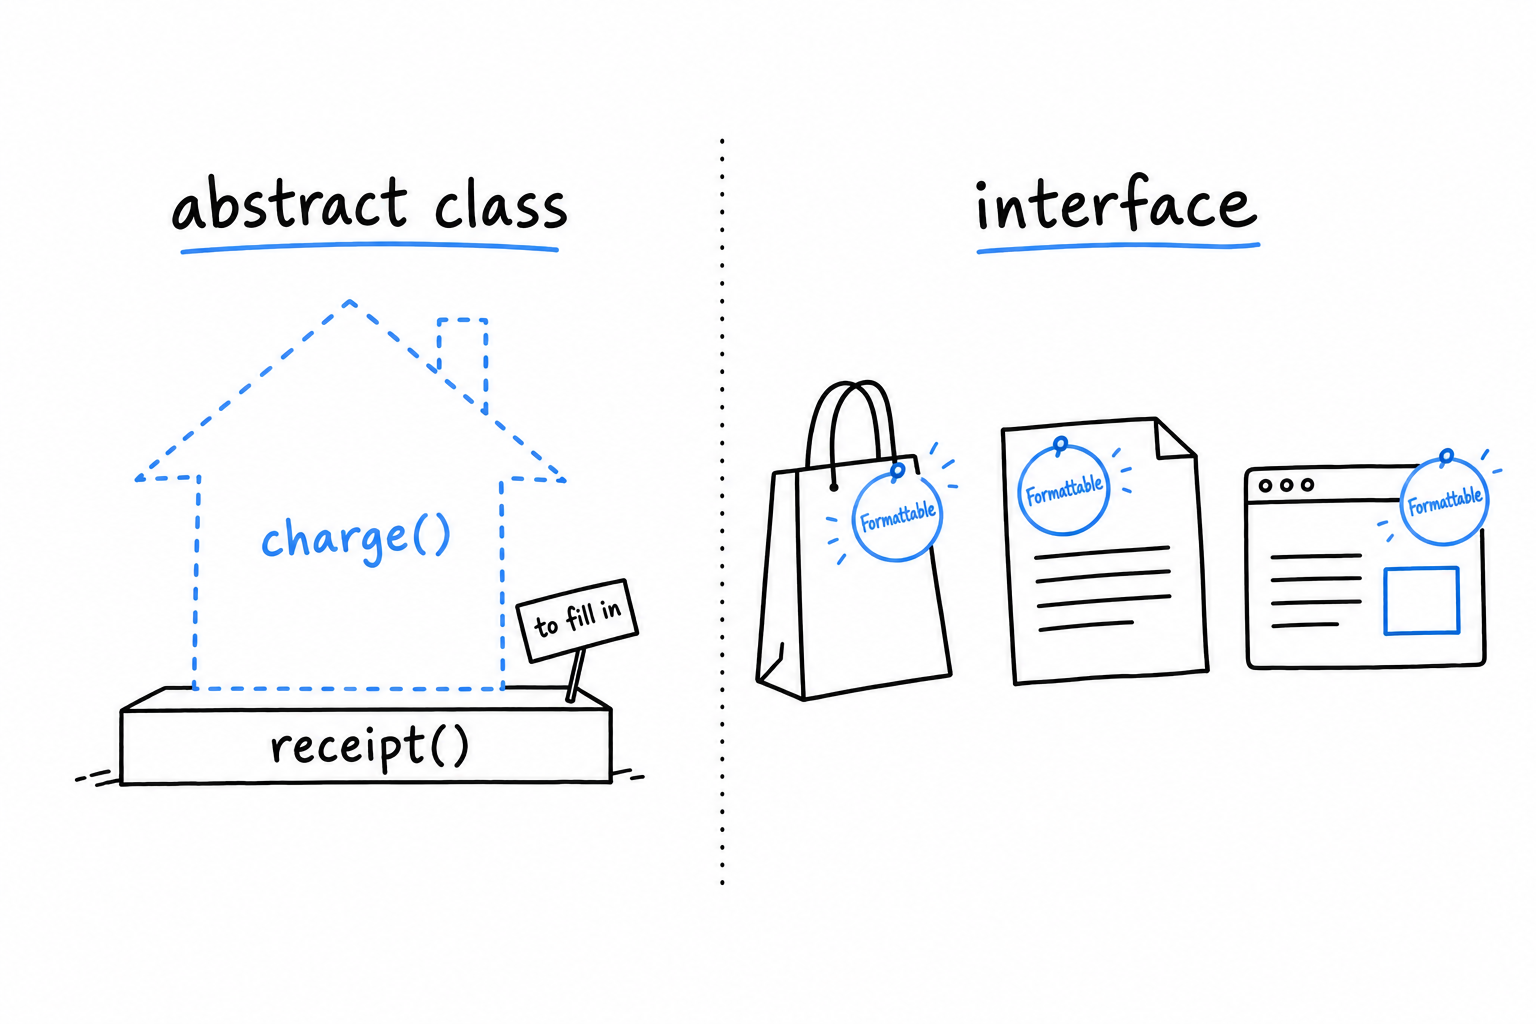
Tip
receipt()estprotected: visible depuisPaymentMethodet ses sous-classes, invisible pour tout le reste. C’est la visibilité habituelle d’une méthode utilitaire qu’une classe de base offre à ses enfants et à personne d’autre.
Comparez avec Formattable
Revenez à l’interface Formattable du chapitre 11 :
<?php
interface Formattable
{
public function format(): string;
}
Une interface n’est rien d’autre qu’un contrat. Aucun corps de méthode, pas même un corps facultatif dont une classe pourrait hériter. Chaque classe qui implémente Formattable écrit son propre format() de zéro, parce qu’il n’y a rien à hériter.
Ce n’est pas un défaut, c’est sa fonction. Une interface nomme une capacité que des classes sans rien d’autre en commun peuvent toutes revendiquer. Un Product, une LogEntry et une HttpResponse n’ont aucun ancêtre commun et n’en auront jamais, et pourtant chacun peut promettre format(). Une classe peut implémenter autant d’interfaces qu’elle veut, et c’est ainsi que PHP se passe d’héritage multiple. Une classe abstraite, elle, est un véritable ancêtre : une classe ne peut en étendre qu’une seule, et tout ce que le parent porte vient avec, propriétés, méthodes concrètes, logique de constructeur.
Une interface est un badge que la classe porte. Une classe abstraite est un parent dont elle descend. Vous avez droit à un seul parent, et à autant de badges que vous voulez.
Laquelle choisir
Prenez une classe abstraite quand vous avez du vrai code que toutes les sous-classes doivent partager, et que vous voulez en plus forcer chacune à remplir les parties qui doivent différer. receipt() partagée, charge() obligatoire mais propre à chaque sous-classe : l’exemple ci-dessus est le cas d’école.
Prenez une interface quand tout ce qu’il vous faut est la garantie qu’une méthode existe, sans supposer que les classes soient apparentées. C’est aussi la seule option quand une classe étend déjà quelque chose et doit encore promettre une seconde capacité sans rapport.
Les deux ne sont pas rivales, et PHP ne vous oblige pas à choisir :
<?php
declare(strict_types=1);
interface Formattable
{
public function format(): string;
}
abstract class PaymentMethod implements Formattable
{
abstract public function charge(float $amount): string;
public function format(): string
{
return static::class;
}
}
PaymentMethod a les deux. La structure imposée d’une classe abstraite pour sa propre famille de sous-classes, et un badge Formattable à part, qui permet à n’importe quel code du système d’appeler format() dessus sans savoir, ni se soucier, qu’il s’agit de paiements. static::class est le nom de la classe concrète à l’exécution, donc une CreditCard se formate en CreditCard, et le parent n’a jamais eu besoin de connaître ses enfants par leur nom.
Les méthodes magiques
Glissez un objet dans une chaîne de caractères, et PHP a une décision à prendre. Lisez une propriété que la classe n’a jamais déclarée, et il en a une autre. Les méthodes magiques sont les crochets que PHP cherche à ces moments-là : des méthodes au nom particulier, toujours précédé de deux tirets bas, que le langage appelle de lui-même quand une situation précise se présente. Vous en connaissez déjà deux.
__construct et __destruct, en bref
__construct() tourne sous chaque new que vous avez écrit depuis le chapitre 5. PHP l’appelle à la création de l’objet, et c’est là que la promotion de constructeur fait son travail. __destruct() est son reflet : PHP l’appelle quand l’objet est sur le point de disparaître, en général quand la dernière variable qui le désigne sort de sa portée. Vous l’écrirez rarement. Le ramasse-miettes de PHP, vu au chapitre 4, libère la mémoire tout seul, donc __destruct() sert aux cas où autre chose doit être relâché sans délai, un descripteur de fichier ou une connexion réseau, plutôt qu’à la fin du processus.
__toString() : laisser un objet se comporter comme une chaîne
C’est celle que vous utiliserez le plus. Définissez-la, et PHP l’appelle partout où votre objet atterrit dans un contexte de chaîne : concaténation, interpolation, un simple echo.
<?php
declare(strict_types=1);
final class Money
{
public function __construct(
private int $cents,
private string $currency,
) {
}
public function __toString(): string
{
return sprintf('%.2f %s', $this->cents / 100, $this->currency);
}
}
$price = new Money(4999, 'USD');
echo "Total: {$price}\n";
echo 'Total: ' . $price . "\n";
$ php money.php
Total: 49.99 USD
Total: 49.99 USD
Aucun des deux echo ne nomme de méthode. PHP voit $price tomber dans une chaîne et appelle __toString() de lui-même. Toute classe qui a une forme textuelle évidente (une somme d’argent, un nom, un identifiant) est une bonne candidate. Le type de retour doit être string ; renvoyer autre chose est une erreur fatale.
Vous écrivez ce que fait le bouton. PHP décide quand appuyer dessus.
__get et __set : des propriétés dynamiques
Ces deux-là se déclenchent quand le code lit ou écrit une propriété que la classe ne déclare pas :
<?php
declare(strict_types=1);
final class Config
{
private array $values = [];
public function __get(string $name): mixed
{
return $this->values[$name] ?? null;
}
public function __set(string $name, mixed $value): void
{
$this->values[$name] = $value;
}
}
$config = new Config();
$config->debug = true;
var_dump($config->debug); // true
var_dump($config->unset_key); // null
$config->debug = true ressemble à une écriture de propriété ordinaire. Config n’a pas de propriété $debug, alors PHP appelle __set('debug', true) à la place, et la valeur atterrit dans le tableau privé $values. Lire $config->debug déclenche __get('debug') de la même manière. L’objet se comporte comme un sac dans lequel on peut tout déposer.
Voyons le prix. Lisez $config->debug quelque part dans le code : rien ne vous dit d’où vient la valeur, ni même si elle existe. Votre éditeur ne peut pas la compléter. Un outil d’analyse statique comme PHPStan, vu au chapitre 11, ne peut pas la vérifier comme il vérifie une propriété déclarée. Chaque accesseur magique échange un peu de code répétitif contre un code que les humains et les outils suivent moins bien. Réservez-les aux cas où la forme dynamique est tout l’intérêt, un sac de configuration, une enveloppe autour de données externes à la forme imprévisible, et déclarez de vraies propriétés partout ailleurs.
__call : intercepter les appels de méthode
__call() fait pour les méthodes ce que __get fait pour les propriétés : elle se déclenche quand le code appelle une méthode que l’objet n’a pas.
<?php
declare(strict_types=1);
final class Logger
{
public function __call(string $name, array $arguments): void
{
$level = strtoupper($name);
echo "[{$level}] {$arguments[0]}\n";
}
}
$logger = new Logger();
$logger->warning('Disk space is low.');
$logger->error('Connection refused.');
$ php logger.php
[WARNING] Disk space is low.
[ERROR] Connection refused.
Logger n’a ni warning() ni error(). Chaque appel à une méthode absente atterrit dans __call(), avec le nom sous forme de string et les arguments sous forme d’array, et la méthode transforme ce nom en niveau de log. C’est une vraie technique ; certaines bibliothèques bâtissent là-dessus leurs API à l’allure fluide. Elle porte aussi la réserve de __get, en double : la définition de la classe ne dit rien des méthodes qui existent ni de ce qu’elles acceptent.
Essayez : déclarez une vraie méthode warning() dans Logger. Le premier appel va maintenant vers elle, et seul error() atteint encore __call(). PHP cherche d’abord une méthode déclarée, et ne se rabat sur la magie que s’il n’en trouve aucune.
Prenez __call quand cette souplesse vaut son prix. Sinon, une poignée de méthodes déclarées noir sur blanc rendra un meilleur service à votre lecteur, et à vos outils.
Implémenter un design pattern classique
Un design pattern (un patron de conception, si vous préférez) est un nom donné à une forme de code qui revient si souvent, dans tant de problèmes différents, qu’elle mérite d’être reconnue au premier coup d’œil. Vous en construisez un depuis trois sections sans l’avoir nommé. La famille PaymentMethod est presque tout le pattern Strategy, l’un des plus courants de toute la programmation orientée objet. Cette section le termine.
L’idée
Prenez un comportement qui peut varier : comment un paiement est débité, comment une liste est triée, comment un prix est remisé. Cachez-le derrière une interface. Confiez-le à une classe qui utilise ce comportement sans savoir quelle version elle a reçue. Cette dernière étape, c’est le polymorphisme vu plus tôt dans ce chapitre. Strategy ajoute une pièce, le contexte : une classe dont tout le travail est de tenir une stratégie, de lui déléguer, et de la laisser remplacer, même une fois le contexte créé.
La construction
Une interface cette fois, pas une classe abstraite. Il n’y a aucun code partagé qui vaille la peine d’être imposé à chaque moyen de paiement, seulement un contrat, et c’est exactement le cas où la section précédente disait qu’une interface convient le mieux :
<?php
declare(strict_types=1);
interface PaymentMethod
{
public function charge(float $amount): string;
}
final class CreditCard implements PaymentMethod
{
public function __construct(private string $last4)
{
}
public function charge(float $amount): string
{
return sprintf('Charged $%.2f to card ending %s.', $amount, $this->last4);
}
}
final class PayPal implements PaymentMethod
{
public function __construct(private string $email)
{
}
public function charge(float $amount): string
{
return sprintf('Charged $%.2f via PayPal account %s.', $amount, $this->email);
}
}
Rien de nouveau : les deux mêmes classes que plus tôt dans le chapitre, qui implémentent une interface au lieu d’étendre une classe de base. Maintenant, le contexte :
<?php
declare(strict_types=1);
final class Checkout
{
public function __construct(private PaymentMethod $paymentMethod)
{
}
public function setPaymentMethod(PaymentMethod $paymentMethod): void
{
$this->paymentMethod = $paymentMethod;
}
public function complete(float $amount): void
{
echo $this->paymentMethod->charge($amount) . "\n";
}
}
Checkout tient un PaymentMethod, n’importe lequel, et complete() confie le travail à celui qu’elle tient à ce moment-là. Regardez ce qui manque. Il n’y a aucun if qui demande « es-tu une carte ou un compte PayPal ? » Cette absence est la signature d’un Strategy bien fait : le contexte appelle charge() et fait confiance à l’interface.
L’utiliser et changer de stratégie en cours de route
<?php
$checkout = new Checkout(new CreditCard('4242'));
$checkout->complete(42.00);
$checkout->setPaymentMethod(new PayPal('damien@example.com'));
$checkout->complete(19.99);
$ php checkout.php
Charged $42.00 to card ending 4242.
Charged $19.99 via PayPal account damien@example.com.
Même objet $checkout, même appel à complete(), deux résultats différents, parce que setPaymentMethod() a changé la stratégie entre les deux. Imaginez l’alternative : un if ($type === 'credit_card') à l’intérieur de Checkout, qui gagne une branche à chaque moyen de paiement que le produit ajoute. Avec Strategy, le virement du trimestre prochain est une nouvelle classe qui implémente PaymentMethod, et Checkout ne bouge pas. Elle fonctionne déjà, pour la même raison que processPayment() fonctionnait plus tôt dans le chapitre : elle a été écrite contre l’interface, jamais contre une classe précise.
Essayez : écrivez BankTransfer, passez-la à setPaymentMethod(), terminez un troisième paiement. Comptez les lignes que vous avez modifiées dans Checkout.
C’est tout le pattern. Une interface qui décrit un comportement interchangeable, des classes qui l’implémentent, et un contexte qui délègue à celle qu’il tient. Pas de syntaxe nouvelle, pas de bibliothèque, rien de propre à PHP : les interfaces et le polymorphisme que vous aviez déjà, agencés à dessein pour résoudre un problème reconnaissable. Une fois que vous en aurez construit un ainsi, vous verrez la même forme partout, sous d’autres noms, dans du code que vous n’avez pas écrit.
Une stratégie est un comportement qu’on débranche et qu’on remplace. Le contexte, c’est la prise.
La concurrence en PHP : un bref tour d’horizon
Vous pouvez sauter ce chapitre, y revenir dans un an, et n’avoir rien perdu.
C’est une phrase inhabituelle dans un livre de programmation, alors voici pourquoi elle est vraie. La plupart des développeurs PHP écrivent pendant des années du code de production, du vrai code qui sert un vrai trafic, sans jamais toucher un thread, une fibre ou un fork de processus. Ce n’est pas une lacune. PHP a été conçu pour que les applications ordinaires n’aient jamais à gérer la concurrence elles-mêmes, et pour l’immense majorité du travail en PHP, du site d’une petite entreprise à une grande boutique en ligne, c’est toujours la bonne façon de faire.
Ce chapitre est donc différent des autres. Partout ailleurs, le livre vous dit « vous vous en servirez tout le temps, apprenez-le bien ». Ici, c’est l’inverse : une courte visite, facultative. Rien de ce qu’elle contient n’est nécessaire pour écrire du PHP au quotidien.
Pourquoi l’inclure, alors ? Parce que tôt ou tard, deux questions arrivent. Pourquoi PHP n’a-t-il pas de threads comme Java ou C# ? Et comment envoyer un e-mail de bienvenue sans faire attendre l’utilisateur ? Les deux questions ont la même réponse, et il faut deux courtes sections pour la donner : d’abord le modèle de requête, qui a rendu la concurrence explicite largement inutile en PHP, puis les files d’attente et les processus en arrière-plan, les outils de tous les jours vers lesquels se tournent les développeurs PHP quand un travail doit se faire en dehors de la requête.
Rien ici n’est obligatoire. Lisez-le par curiosité, ou gardez-le pour le jour où vous en aurez besoin.
Dans les deux cas, vous en sortirez en sachant pourquoi PHP se comporte ainsi, quelles sont vos options quand le modèle de requête ne suffit plus, et quoi chercher le jour où il vous faudra davantage.
Le modèle de requête PHP : pourquoi PHP est (presque toujours) monothread
Un serveur Node.js ou Java démarre une fois et reste debout. Il traite toutes les requêtes qui arrivent tant qu’il est en vie, et sa mémoire persiste de l’une à l’autre. Une variable posée en servant un utilisateur peut, si vous n’y prenez pas garde, être encore là quand le suivant se présente.
PHP, dans sa forme classique et toujours la plus répandue, ne fonctionne pas ainsi. Chaque requête HTTP repart de zéro. Le processus PHP (ou le thread, selon la configuration de votre serveur web) charge votre script, l’exécute depuis le haut, envoie une réponse, puis jette tout. Chaque variable, chaque objet, chaque propriété statique : disparus. La requête suivante repart d’une page blanche. Rien ne survit, sauf ce que vous avez volontairement rangé en dehors de PHP : une base de données, un fichier, un cache comme Redis ou Memcached.
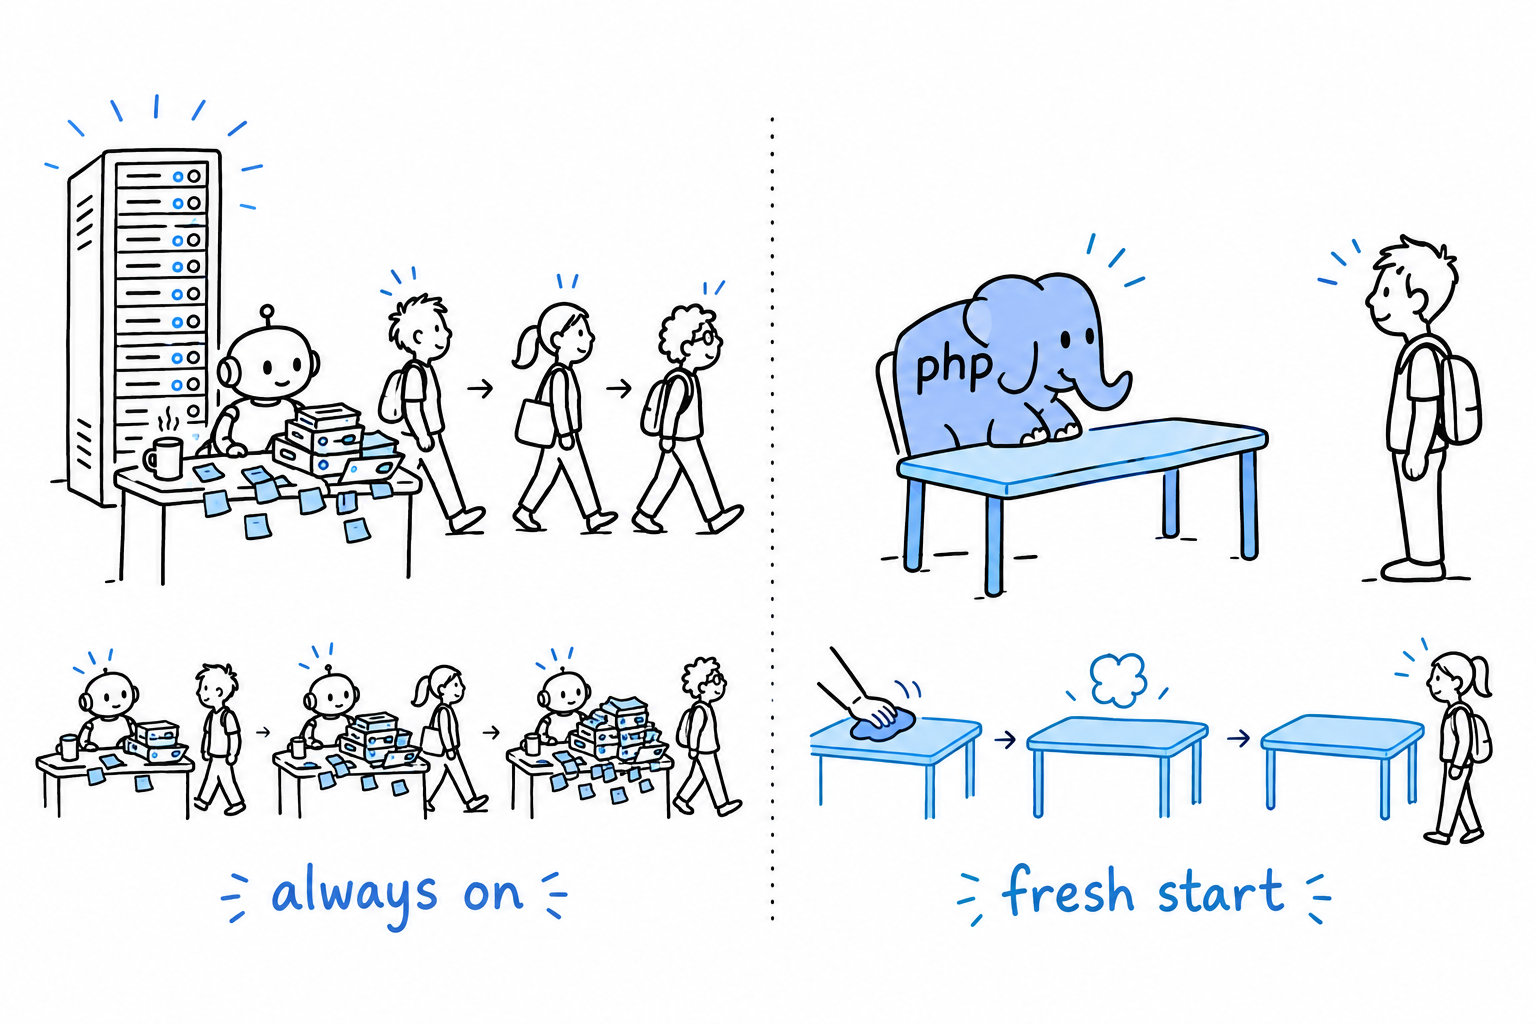
On appelle cela une architecture shared-nothing (« rien de partagé »), et c’est la plus grande différence de structure entre PHP et les langages bâtis autour d’un processus serveur qui tourne en continu. Vous l’avez déjà vue en miniature au chapitre 1 : php hello.php lance l’interpréteur, exécute le script de haut en bas, et s’arrête. La production, c’est le même cycle derrière un serveur web. Avec PHP-FPM (le FastCGI Process Manager, la façon standard de faire tourner PHP derrière nginx ou Apache), un groupe de processus PHP attend, prêt à servir, et chaque requête entrante est confiée à l’un d’eux pour exactement le temps qu’il faut pour produire la réponse.
Une requête PHP naît, travaille, répond, et oublie. La suivante repart propre.
Pourquoi les threads sont devenus inutiles
Les threads existent pour qu’un même programme fasse plusieurs choses à la fois, en partageant sa mémoire. Mais si votre programme ne traite jamais qu’une requête du début à la fin avant de disparaître, il n’y a presque rien à faire tourner en parallèle à l’intérieur. La concurrence dont une application PHP a besoin, des milliers d’utilisateurs en même temps, se gère un étage au-dessus, en faisant tourner beaucoup de processus PHP côte à côte, pas en apprenant à un seul processus à jongler. Pensez à un bureau de poste : plutôt qu’un guichetier très rapide qui servirait dix clients à la fois, dix guichets servent chacun un client. Ce sont votre serveur web et votre gestionnaire de processus qui ouvrent les guichets, et ils font déjà le plus dur.
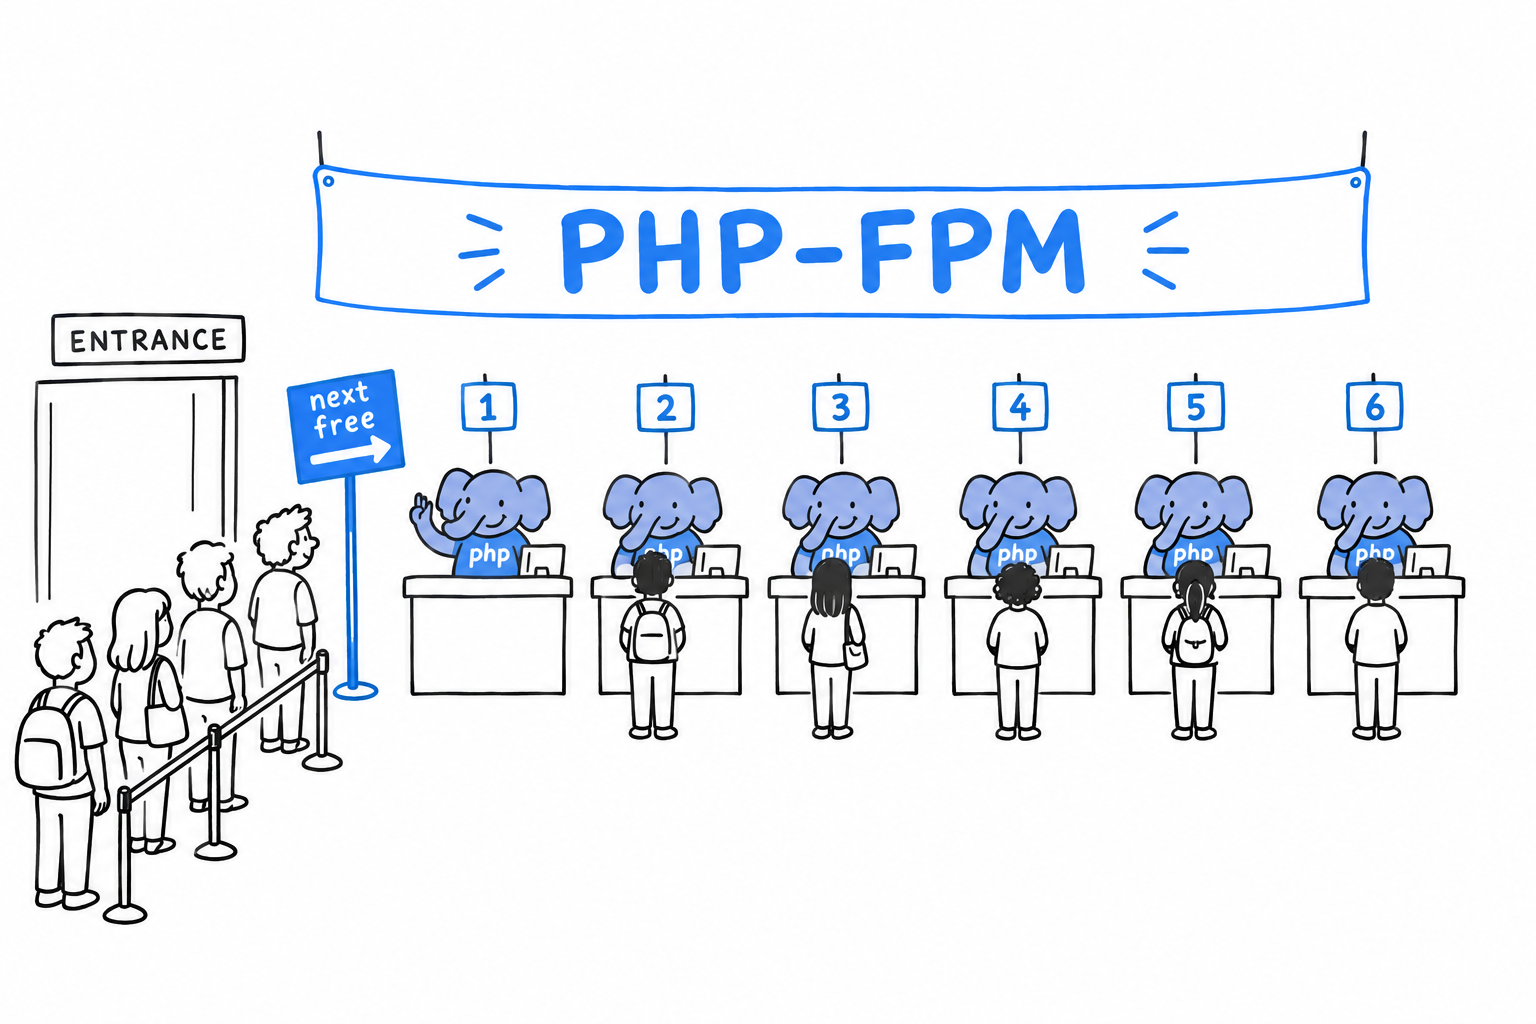
L’avantage pratique est considérable. Vous ne raisonnez jamais sur des accès concurrents (race conditions) à l’intérieur d’une requête, comme vous le feriez dans une servlet Java multithread. Deux utilisateurs ne peuvent pas corrompre mutuellement leurs données de $_SESSION en écrivant au même moment dans la même variable, parce qu’il n’y a pas de variable commune : chacun a sa propre exécution. Des catégories entières de bugs qui empoisonnent les serveurs à mémoire partagée ne peuvent tout simplement pas se produire en PHP classique. Le modèle les exclut dès le départ, au lieu de vous demander de les éviter à force de discipline.
Là où ça cesse d’être toute l’histoire
PHP peut partager de l’état et exécuter des choses en parallèle. Par défaut, il ne le fait pas, et les applications PHP traditionnelles ont été conçues avec cette contrainte plutôt que contre elle. Trois exceptions méritent d’être connues.
Le travail qui doit se faire mais ne doit pas retarder la réponse, envoyer un e-mail, redimensionner une image reçue, est confié à un processus séparé plutôt qu’exécuté dans la requête. La section suivante parle exactement de cela.
Les processus PHP de longue durée existent bel et bien. Les démons en ligne de commande, les workers de file d’attente et des outils plus récents comme les serveurs Swoole gardent un même processus en vie pendant de nombreuses unités de travail, et là, la garantie du shared-nothing ne s’applique plus automatiquement. Elle redevient votre affaire.
Opcache, le cache de bytecode de PHP, partage bien le code compilé entre les requêtes pour gagner du temps. Mais c’est du code compilé, pas l’état de votre application : vos variables, elles, meurent toujours avec la requête.
Dès qu’un processus PHP survit à une requête, la garantie de la page blanche disparaît, et vous voilà à réfléchir à l’état partagé comme tout le monde. Comment les applications PHP font-elles leur travail « en parallèle » en pratique, sans un seul thread ? C’est la prochaine étape.
Le travail en arrière-plan : files d’attente et processus
Une requête arrive, PHP la traite, et le processus disparaît une fois la réponse envoyée. Très bien pour « retrouve cet utilisateur et affiche son profil ». Beaucoup moins pour « redimensionne cette photo, fabrique trois miniatures et envoie un e-mail de confirmation ». Personne ne veut regarder une roue tourner pendant huit secondes parce que votre code traite des images avant de pouvoir dire « Upload successful ».
L’utilisateur n’a pas besoin d’attendre ce travail. Il a seulement besoin de savoir qu’il a été pris en compte. La réponse standard en PHP tient en une ligne : ne le faites pas maintenant. Faites-le plus tard, dans un autre processus.
Les files d’attente de tâches
Pensez à un pressing. Vous déposez le manteau, on vous donne un ticket, vous repartez. Le nettoyage se fait dans l’arrière-boutique, une fois que vous êtes parti, et vous n’êtes pas planté au comptoir à regarder.
Une file d’attente de tâches (job queue), c’est ce comptoir. Au lieu de faire le travail lent dans la requête, le code qui la traite note ce qu’il y a à faire, « redimensionner l’image #482 pour l’utilisateur #17 », sous la forme d’un petit message, et pousse ce message dans une file. Puis il répond tout de suite à l’utilisateur : « Upload received, processing ». Pendant ce temps, un ou plusieurs processus PHP séparés, appelés workers, tournent en boucle en surveillant la file. Dès qu’un message apparaît, un worker le prend et fait le vrai travail, sans plus aucun lien avec la requête d’origine.
La file elle-même repose en général sur un outil fait pour ça. Redis est un choix courant et léger ; RabbitMQ et Amazon SQS apparaissent dans les systèmes plus gros. Des frameworks comme Laravel et Symfony fournissent des abstractions de file par-dessus, pour que vous n’ayez pas à bricoler la tuyauterie. L’idée est pourtant assez simple pour que vous puissiez en construire une version rudimentaire vous-même, avec rien de plus qu’une table en base de données et un SELECT ... WHERE processed = false.
Les workers sont du PHP ordinaire, lancé en ligne de commande, en général maintenu en vie par un superviseur de processus :
$ php worker.php
Waiting for jobs...
Processing job: resize-image #482
Done.
Waiting for jobs...
Ce script de worker boucle sans fin : regarder la file, traiter ce qui s’y trouve, recommencer. C’est un processus PHP de longue durée, exactement le genre de chose qui sort du modèle shared-nothing de la section précédente. Il garde un état d’une tâche à l’autre, une connexion à la base, peut-être une configuration en cache, comme un serveur Node.js le fait d’une requête à l’autre.
La requête donne le ticket. Le worker fait le nettoyage. Personne n’attend au comptoir.
La prochaine fois que vous envoyez une photo sur un gros site, observez : la page dit « reçu » presque instantanément, et les miniatures apparaissent quelques secondes plus tard. C’est une file d’attente au travail.
Lancer un processus séparé directement
Les files d’attente sont le bon outil quand beaucoup de petites unités de travail arrivent au fil du temps. Parfois, vous voulez plus simple : lancer cet autre programme tout de suite, et soit ne pas l’attendre, soit le laisser tourner pendant que vous faites autre chose. Pour cela, PHP peut lancer directement des processus du système d’exploitation.
proc_open() est l’outil généraliste. Il démarre une commande externe (qui peut très bien être un autre script PHP) et vous donne des poignées sur son entrée, sa sortie et son flux d’erreur, pour dialoguer avec elle pendant qu’elle tourne. Composer s’en sert pour sa propre gestion des processus.
Il y a aussi l’extension pcntl, qui permet à un script PHP de se dupliquer en plusieurs copies avec pcntl_fork() : du PHP réellement parallèle, sous forme de processus séparés, chacun avec sa propre mémoire. Honnêtement, c’est un peu rude. Le fork n’existe que sur les systèmes de type Unix, pas sous Windows, et raisonner juste sur plusieurs processus à la fois demande une vraie attention. On le croise dans les outils en ligne de commande et les démons bien plus que dans les applications web.
Les deux méritent d’être connus. Aucun des deux n’est à choisir avant une file d’attente, qui résout le même problème, « fais-le plus tard, pas maintenant », avec bien moins d’occasions de se tromper.
Motifs et correspondance
Pour sortir trois valeurs d’un tableau à l’ancienne, vous écrivez trois lignes : $name = $row[0];, puis $age = $row[1];, puis $city = $row[2];. Chaque ligne répète le même geste, et aucune ne dit au lecteur à quoi ressemble le tableau. La déstructuration fait le même travail en une seule affectation, en dessinant à gauche du signe égal la forme que vous attendez. C’est l’outil de motifs le plus discret de PHP, on en parle bien moins qu’il ne le mérite, et c’est le sujet de ce chapitre.
L’outil bruyant, vous le connaissez déjà. match est arrivé au chapitre 6, aux côtés des énumérations, comme remplaçant propre de switch. Sur la page, match et la déstructuration ne se ressemblent pas. Dessous, ils règlent le même genre de problème : vous tenez une forme (un tableau, une valeur qui peut être l’une parmi plusieurs) et vous voulez que PHP la démonte pour vous, plutôt que d’écrire à la main les index ou les comparaisons.
La déstructuration se glisse dans plus d’endroits qu’on ne le croit : l’affectation simple, foreach, les cases qu’on saute exprès. Vient ensuite la syntaxe elle-même, imbriquée et par clé, là où elle gagne sa place dans le code de tous les jours. Le chapitre se termine sur trois détails de match que le chapitre 6 n’avait pas la place d’aborder : plusieurs conditions dans un même bras, pourquoi l’ordre des bras compte, et des bras qui sont des expressions complètes plutôt que de simples valeurs.
Rien d’exotique là-dedans. C’est du PHP ordinaire, idiomatique, et une fois que vous l’aurez en main, $row[0], $row[1], $row[2] sur trois lignes vous paraîtra aussi daté qu’un switch avec six break.
Où utiliser match et la déstructuration
Une affectation range d’ordinaire une valeur dans une variable. La déstructuration est une affectation qui déballe : plusieurs valeurs sorties d’un tableau, dans plusieurs variables, en une seule instruction. Vous décrivez à gauche la forme que vous attendez, et PHP remplit les noms.
Les deux orthographes
PHP sait faire ça depuis longtemps, sous le nom de list() :
<?php
$coordinates = [4, 7];
list($x, $y) = $coordinates;
echo "x={$x}, y={$y}\n";
La forme entre crochets est arrivée plus tard et fait exactement la même chose :
<?php
$coordinates = [4, 7];
[$x, $y] = $coordinates;
echo "x={$x}, y={$y}\n";
Les deux formes associent par position : le premier élément va au premier nom, le deuxième au deuxième, et ainsi de suite. list() survit dans les vieilles bases de code et dans quelques exemples de la documentation officielle, donc reconnaissez-le quand vous le croisez, mais écrivez la forme entre crochets. Elle est plus courte, et elle ressemble au tableau qu’elle démonte.
Essayez : remplacez le tableau par [4, 7, 9] et relancez. Rien ne casse. La troisième valeur n’a simplement aucun nom où atterrir, alors elle reste où elle est.
Dans un foreach
Le premier endroit où la déstructuration rapporte vraiment, c’est foreach, où vous déballez chaque élément au moment où la boucle vous le tend :
<?php
$pairs = [
['Alice', 30],
['Bob', 25],
['Carol', 35],
];
foreach ($pairs as [$name, $age]) {
echo "{$name} is {$age} years old.\n";
}
$ php pairs.php
Alice is 30 years old.
Bob is 25 years old.
Carol is 35 years old.
Sans elle, le corps de la boucle dirait $pair[0] et $pair[1], et celui qui lit le code devrait deviner ce que signifie la position 0. foreach ($pairs as [$name, $age]) annonce la forme des données dans l’en-tête de la boucle, la première ligne que tout le monde regarde.
Sauter des éléments
Parfois un tableau offre plus que ce que vous voulez. Laissez une case vide et PHP la saute, sans décaler celles qui suivent :
<?php
$row = [1, 'Second', 'Third'];
[, $second, $third] = $row;
echo "{$second}, {$third}\n"; // Second, Third
La virgule sans rien devant dit « saute le premier » : la liste des noms a un trou là où un nom irait normalement. Un détail, mais qui se lit mieux qu’une variable $unused remplie pour ne jamais servir.
Les tableaux plats sont le cas facile. Les vrais s’imbriquent, la plupart portent des clés plutôt que des positions, et la déstructuration les suit jusque-là, tour de passe-passe compris.
Déstructuration de listes et de tableaux
Les vrais tableaux sont rarement des listes plates. Ils s’imbriquent, et le plus souvent ils portent des clés plutôt que des positions. La déstructuration épouse la forme des données, quelle que soit cette forme.
Déstructuration imbriquée
Si un tableau contient d’autres tableaux, le motif reproduit cette structure telle quelle :
<?php
$point = [[1, 2], 3];
[[$x, $y], $z] = $point;
echo "x={$x}, y={$y}, z={$z}\n"; // x=1, y=2, z=3
Mettez les deux côtés face à face : [[$x, $y], $z] et [[1, 2], 3]. Le motif est un calque des données. Cette symétrie fait tout l’intérêt. Passé un niveau de profondeur, une chaîne comme $point[0][0] commence à cacher ce que vous cherchez, alors que le motif dit « donne-moi exactement cette forme » en une ligne.
Déstructuration par clé
Les coordonnées viennent par positions. Presque tout le reste de ce que vous déballerez dans une application vient avec des clés : une ligne de base de données, du JSON décodé, un formulaire soumis. Pour ceux-là, nommez les clés :
<?php
$userData = [
'name' => 'Priya',
'age' => 29,
'email' => 'priya@example.com',
];
['name' => $name, 'age' => $age] = $userData;
echo "{$name} is {$age}.\n"; // Priya is 29.
email n’est pas mentionné, donc on n’y touche pas. Vous ne nommez que les clés que vous voulez, et le reste du tableau reste à sa place.
C’est ici que la déstructuration cesse d’être un raccourci et devient plus claire que l’alternative. Une ligne dit « ce code a besoin d’un nom et d’un âge » ; deux lignes de $userData['name'] et $userData['age'] le disent plus lentement.
Clés et imbrication se combinent :
<?php
$response = [
'status' => 'ok',
'user' => ['name' => 'Priya', 'age' => 29],
];
['user' => ['name' => $name, 'age' => $age]] = $response;
echo "{$name}, {$age}\n"; // Priya, 29
Échanger deux variables
La déstructuration a un petit tour de passe-passe très satisfaisant : échanger deux variables sans une troisième pour tenir la valeur en attente.
<?php
$a = 1;
$b = 2;
[$a, $b] = [$b, $a];
echo "a={$a}, b={$b}\n"; // a=2, b=1
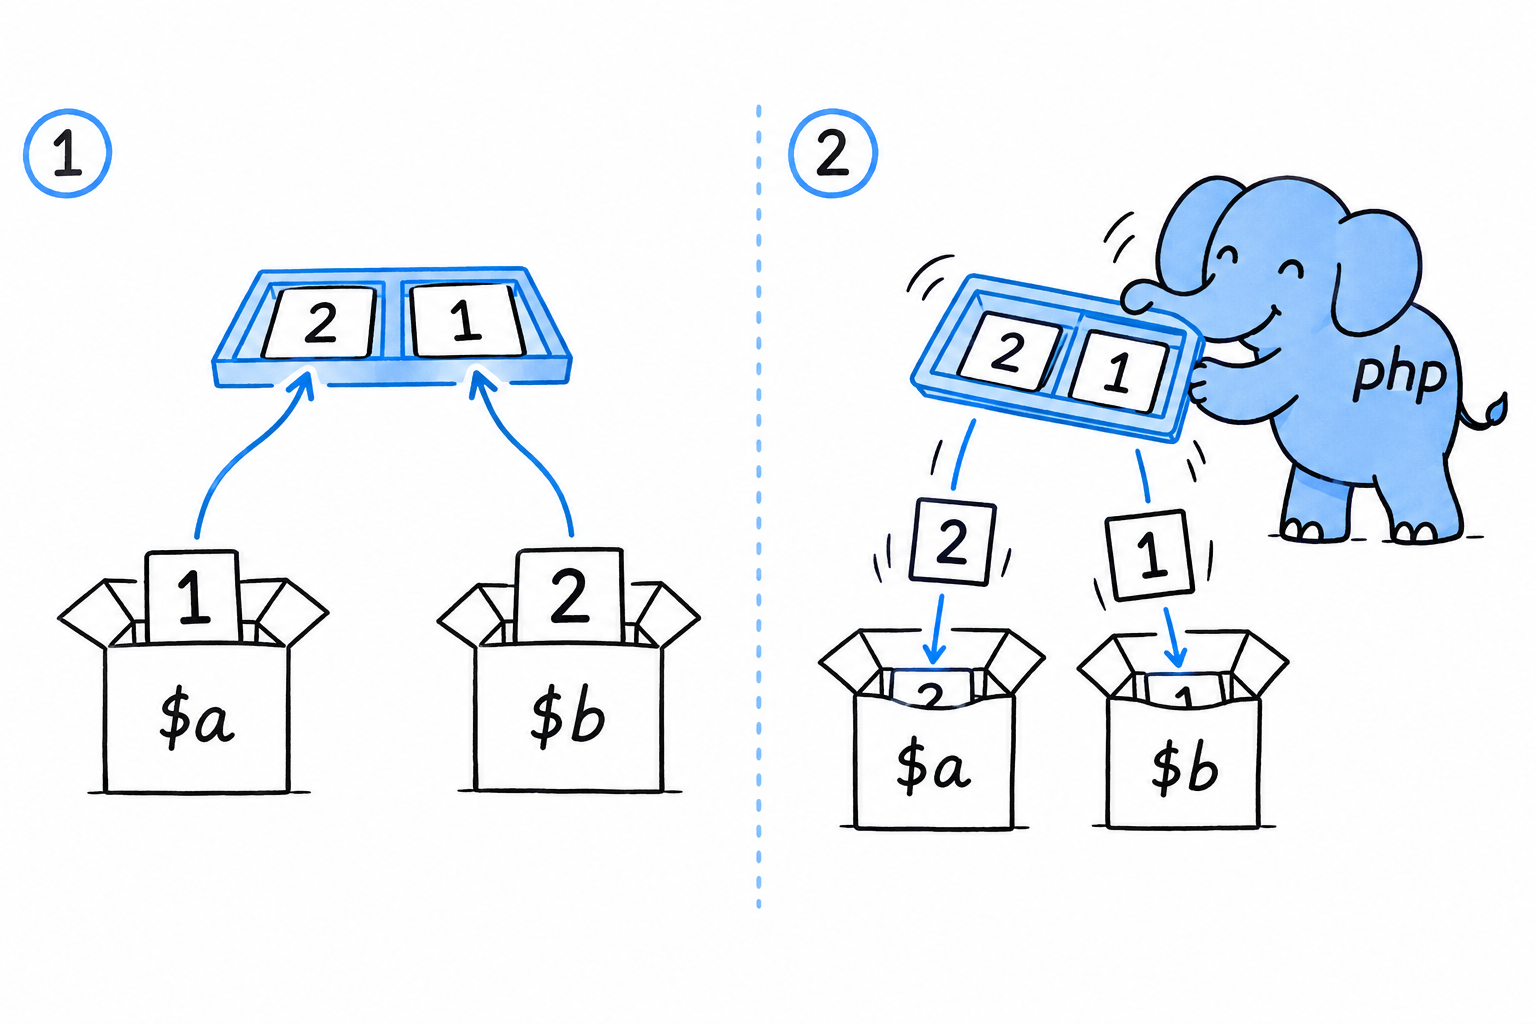
PHP construit d’abord le tableau [$b, $a] à droite, ce qui capture les deux valeurs d’origine, et seulement ensuite les reverse dans $a et $b à gauche. Quand $a est écrasé, l’ancienne valeur de $b a déjà été lue. C’est cet ordre qui rend l’échange sûr, et c’est la façon la plus propre d’échanger deux valeurs en PHP : aucune variable $temp nécessaire.
Un mot de prudence
Déstructurez un tableau auquel il manque une clé ou une position que vous avez demandée, et rien n’est levé. L’élément manquant devient null, avec un avertissement si votre configuration de rapport d’erreurs est stricte. Essayez : retirez 'age' de $userData ci-dessus et relancez le fichier.
Warning
La déstructuration reconnaît une forme ; elle ne la vérifie jamais. PHP vous laissera déballer un tableau de trois éléments comme s’il en avait cinq.
Prenez-la pour ce qu’elle est : une commodité pour du code où vous faites déjà confiance à la forme des données. Quand les données viennent de l’extérieur, validez d’abord, déstructurez ensuite.
La syntaxe des motifs de match
Le chapitre 6 a présenté match dans les règles, aux côtés des énumérations, là où il brille le plus. Trois détails n’y tenaient pas, et vous voudrez les trois la première fois que vous écrirez un match de plus de deux ou trois bras.
Plusieurs conditions par bras
Un bras n’est pas obligé de tester une seule valeur. Séparez-en plusieurs par des virgules, et le bras correspond dès que l’une d’elles est égale au sujet :
<?php
$dayNumber = 6;
$dayType = match ($dayNumber) {
1, 2, 3, 4, 5 => 'Weekday',
6, 7 => 'Weekend',
default => 'Invalid',
};
echo $dayType; // Weekend
Lisez la virgule comme un « ou ». 1, 2, 3, 4, 5 => signifie « si le sujet vaut 1, ou 2, ou 3, ou 4, ou 5 ». Sans elle, vous écririez cinq bras qui renvoient tous 'Weekday', exactement la répétition que match existe pour supprimer.
L’ordre compte : le premier qui correspond gagne
match examine ses bras de haut en bas et s’arrête au premier qui convient. La plupart du temps, vous n’y pensez jamais, parce que des conditions bien conçues ne se recouvrent pas. Associez match (true) (qui teste des conditions booléennes au lieu d’une seule valeur, comme au chapitre 3) à des conditions qui peuvent se recouvrir, et l’ordre cesse d’être une formalité :
<?php
$score = 85;
$grade = match (true) {
$score >= 90 => 'A',
$score >= 80 => 'B',
$score >= 70 => 'C',
default => 'F',
};
echo $grade; // B
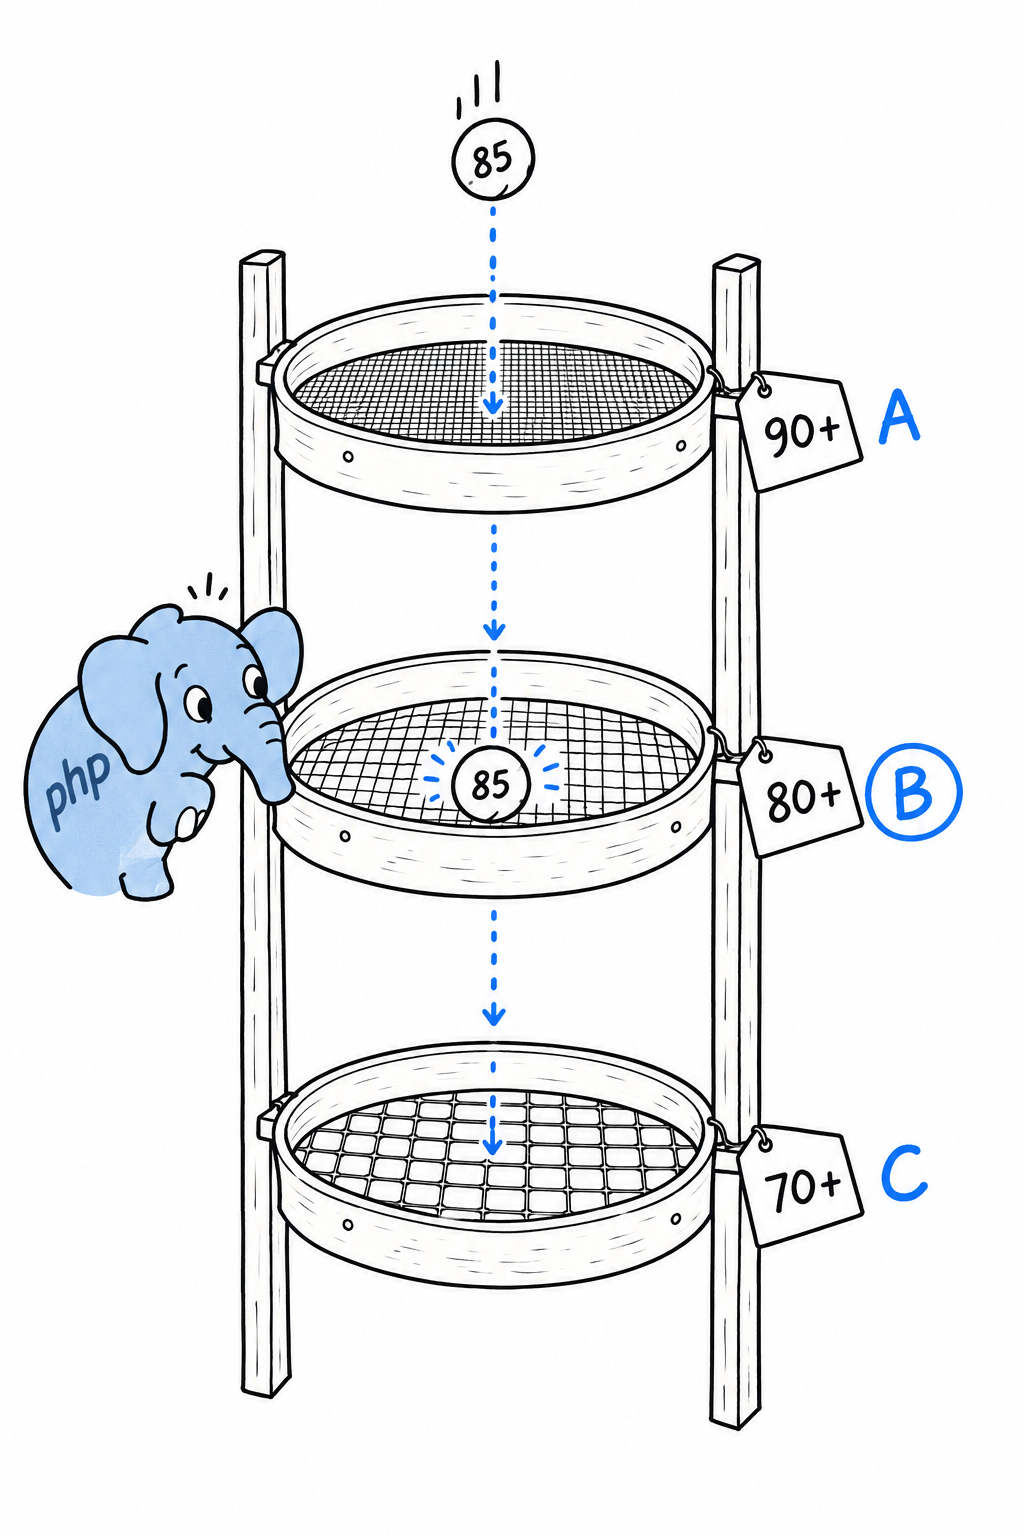
Remontez $score >= 70 en tête, et 85 le satisfait avant même que le bras B ait son tour. 95 aussi. Les bras A et B deviennent du code mort, et PHP n’en dira pas un mot. Essayez : réordonnez les bras et relancez le fichier.
Tip
Quand des bras peuvent se recouvrir, placez la condition la plus restrictive en premier, comme des tamis empilés du plus fin au plus grossier.
Les bras sont des expressions, pas seulement des valeurs
Un bras n’a pas à être un simple littéral. Chaque bras d’un match est une expression complète, évaluée et renvoyée seulement quand ce bras est choisi. Appelez une fonction, construisez un objet, exécutez tout ce que PHP accepte comme expression :
<?php
enum LogLevel
{
case Info;
case Warning;
case Error;
}
function formatMessage(string $level, string $text): string
{
return "[" . strtoupper($level) . "] {$text}";
}
$level = LogLevel::Warning;
$output = match ($level) {
LogLevel::Info => formatMessage('info', 'Request completed'),
LogLevel::Warning => formatMessage('warning', 'Disk usage above 80%'),
LogLevel::Error => (new RuntimeException('Disk full'))->getMessage(),
};
echo $output; // [WARNING] Disk usage above 80%
Le dernier bras construit une exception et appelle une méthode dessus, d’un seul mouvement ; les parenthèses autour de new RuntimeException(...) sont nécessaires pour que PHP comprenne qu’il doit appeler getMessage() sur l’objet terminé, plutôt que d’analyser la ligne autrement. Les bras n’ont aucune obligation d’être courts ou triviaux. Ils doivent être des expressions, et en PHP cela couvre presque tout, ce qui fait de match un vrai remplaçant pour quantité de petites fonctions utilitaires, pas seulement un switch mieux rangé.
Fonctionnalités avancées
Tout atelier a un tiroir pour les outils qui servent deux fois par an. Le ciseau à bois, la clé à tube, le jeu de tarauds. On ne les emporte pas partout, mais le jour où le bon travail se présente, savoir qu’ils existent sauve l’après-midi. Ce chapitre, c’est ce tiroir.
Les quatre sections qui suivent ne s’appuient pas les unes sur les autres, et aucune n’est nécessaire pour finir ce livre. Sautez ce chapitre si vous voulez, et revenez-y le jour où un framework fait quelque chose que vous n’arrivez pas à expliquer. Tout ce qu’il contient est courant dans l’écosystème PHP, dans les bibliothèques que vous installez avec Composer, dans Symfony et Laravel, dans le code écrit par des gens qui pratiquent depuis longtemps. Rien de tout cela n’est du code que vous écrirez chaque jour, et c’est précisément pour ça qu’il se trouve ici, vers la fin, plutôt que disséminé dans les chapitres précédents.
Voici ce qu’il y a dans le tiroir. Les constantes magiques et la Reflection permettent au code de se regarder lui-même, et de regarder d’autre code, pendant qu’il s’exécute ; vous les appellerez rarement, parce que les frameworks et les outils de test le font pour vous. Quelques interfaces natives branchent vos propres objets sur la syntaxe de PHP, si bien que count(), les crochets et foreach fonctionnent dessus comme sur des tableaux. Les closures ont droit à un second regard, avec la syntaxe des callables de première classe apportée par PHP 8.1. Et les attributs mettent des métadonnées directement dans le code, là où un commentaire faisait le travail autrefois.
Choisissez la section qui correspond au casse-tête que vous avez sous les yeux. Chacune tient debout toute seule.
Constantes magiques et Reflection
Votre code sait en général ce qu’il est : vous l’avez écrit. Mais il arrive qu’un programme doive se poser la question pendant qu’il tourne. Un logger veut dire quelle méthode a émis un avertissement. Un outil de test veut la liste des méthodes d’une classe qu’il n’a jamais vue. PHP répond à ces questions avec deux outils de tailles très différentes : une poignée de constantes magiques pour les questions simples, et la Reflection, une API complète, pour les questions détaillées.
Les constantes magiques
Le logger d’abord.
<?php
class Logger
{
public function warn(string $message): void
{
echo __CLASS__ . '::' . __FUNCTION__ . " at line " . __LINE__ . ": {$message}\n";
}
}
(new Logger())->warn('Disk space low');
$ php logger.php
Logger::warn at line 7: Disk space low
La méthode warn() n’écrit jamais son propre nom, et pourtant la sortie affiche Logger::warn et un numéro de ligne. __CLASS__, __FUNCTION__ et __LINE__ sont remplies par PHP avant l’exécution, avec le nom de la classe, le nom de la fonction et la ligne où elles apparaissent. Deux autres font le même travail : __METHOD__ donne les deux noms d’un coup, sous la forme Class::method, et __FILE__ donne le chemin complet du fichier courant.
On les dit magiques parce que leur valeur dépend de l’endroit où vous les écrivez. Essayez : décalez la ligne du echo d’un cran en insérant une ligne vide au-dessus, puis relancez. Le 7 devient un 8.
Il n’y a rien de sorcier là-dessous. L’analyseur remplace chaque constante par une valeur toute simple, donc elles ne coûtent rien et ne peuvent pas se tromper. C’est ce qu’il faut à une ligne de log : d’où vient le message, sans un nom codé en dur qui dérivera le jour où quelqu’un renommera la méthode.
Une constante magique est une étiquette que l’analyseur coud dans votre code. Elle indique toujours l’endroit où l’on se trouve.
La Reflection
Les constantes magiques renseignent le code sur lui-même. La Reflection permet au code d’examiner d’autre code, classe par classe et méthode par méthode, comme des données qu’il interroge à l’exécution.
<?php
class UserRepository
{
public function find(int $id): ?string
{
return "User #{$id}";
}
public function save(string $name): void
{
// ...
}
private function connect(): void
{
// ...
}
}
$reflection = new ReflectionClass(UserRepository::class);
foreach ($reflection->getMethods(ReflectionMethod::IS_PUBLIC) as $method) {
echo $method->getName() . "\n";
}
$ php reflect.php
find
save
ReflectionClass enveloppe une classe et en expose la forme : getMethods(), getProperties(), getConstructor(), et d’autres. Chacune renvoie d’autres objets de réflexion, ReflectionMethod ou ReflectionProperty, que vous interrogez à leur tour sur les paramètres d’une méthode, leurs types, ou le caractère readonly d’une propriété. Passer ReflectionMethod::IS_PUBLIC écarte connect(), l’aide privée, et ne laisse que l’interface publique. Les attributs, plus loin dans ce chapitre, se relisent de la même manière.
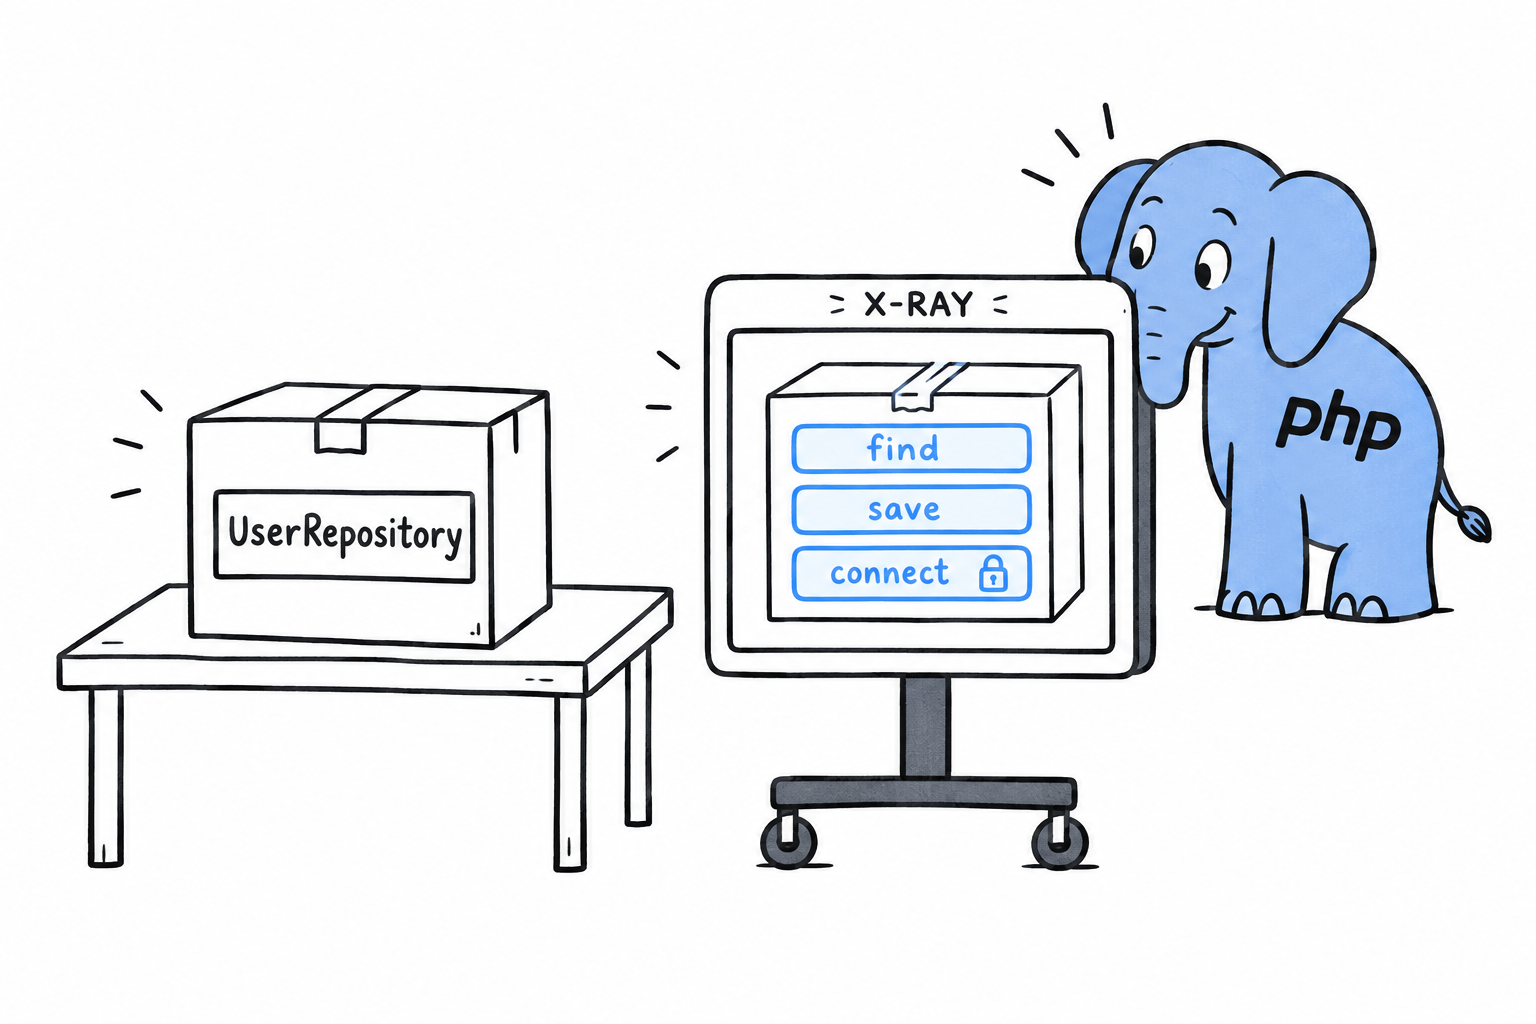
Voyez-la comme une radiographie. L’objet reste fermé, et vous avez pourtant une image complète de ce qu’il y a dedans.
Où vous la croiserez vraiment
Soyez honnête sur la fréquence à laquelle vous écrirez new ReflectionClass(...) vous-même : rarement. La Reflection existe pour que d’autres outils puissent travailler sur des classes qu’ils n’ont jamais vues. Un conteneur d’injection de dépendances lit les paramètres d’un constructeur pour savoir quoi lui passer. PHPUnit s’en sert pour trouver vos méthodes de test. Laravel et Symfony s’y appuient en permanence, sous le capot.
Vous utiliserez la Reflection à travers ces outils bien plus souvent que directement. Mais la prochaine fois qu’un framework fera quelque chose d’apparemment magique avec une classe que vous venez d’écrire, vous saurez ce qui s’est passé. Il a pris une radio.
Interfaces natives : Countable, ArrayAccess, IteratorAggregate
Appelez count() sur un objet que vous avez écrit, et PHP refuse : il compte des tableaux, pas des objets. Écrivez $config['debug'], et l’objet n’a aucune idée de ce que signifient des crochets. Mettez-le dans un foreach, et vous obtenez ses propriétés, pas les choses qu’il contient. Un petit jeu d’interfaces natives règle les trois cas. Implémentez-en une, et la syntaxe de PHP se met à traiter votre objet comme un tableau.
Une interface, comme l’a montré le chapitre 11, est un contrat : implémentez ses méthodes et votre classe peut aller partout où ce contrat est attendu. Ces trois-là viennent de la SPL (Standard PHP Library), et la partie qui attend le contrat, c’est PHP lui-même.
Countable
La plus petite. Implémentez une méthode count(), et la fonction native count() de PHP l’appelle pour vous.
<?php
class Playlist implements Countable
{
private array $tracks = [];
public function add(string $track): void
{
$this->tracks[] = $track;
}
public function count(): int
{
return count($this->tracks);
}
}
$playlist = new Playlist();
$playlist->add('Track One');
$playlist->add('Track Two');
echo count($playlist); // 2
Rien ici ne fait plus que ce que ferait $playlist->count(). Ce qui change, c’est ce que lit l’appelant : count($playlist) dit « cette chose est une collection », et c’est exactement l’impression que vous voulez donner à la prochaine personne qui utilisera votre classe.
ArrayAccess
ArrayAccess est la plus spectaculaire. Implémentez ses quatre méthodes, et les crochets fonctionnent sur votre objet.
<?php
class Config implements ArrayAccess
{
private array $values = [];
public function offsetExists(mixed $offset): bool
{
return isset($this->values[$offset]);
}
public function offsetGet(mixed $offset): mixed
{
return $this->values[$offset] ?? null;
}
public function offsetSet(mixed $offset, mixed $value): void
{
$this->values[$offset] = $value;
}
public function offsetUnset(mixed $offset): void
{
unset($this->values[$offset]);
}
}
$config = new Config();
$config['debug'] = true;
echo $config['debug'] ? "on\n" : "off\n"; // on
echo isset($config['missing']) ? "yes\n" : "no\n"; // no
Chaque méthode répond à une forme de la syntaxe. offsetSet s’exécute pour $config['debug'] = true, offsetGet pour la lecture de $config['debug'], offsetExists pour isset($config[...]), et offsetUnset pour unset($config[...]). En dessous, Config reste un objet ordinaire avec un tableau privé ordinaire. ArrayAccess permet seulement au monde extérieur de s’adresser à lui avec la syntaxe des tableaux, et ça se lit bien pour un objet de configuration ou une enveloppe typée autour d’une collection.
Essayez : faites lever une exception à offsetSet quand $offset n’est pas une chaîne de caractères. Le code appelant ne change pas, et l’objet refuse désormais ce qu’un simple tableau aurait accepté sans broncher.
IteratorAggregate
La troisième fait fonctionner votre objet dans un foreach. IteratorAggregate demande une seule méthode, getIterator(), qui renvoie quelque chose de déjà itérable, en général un Generator du chapitre 15. Vous n’écrivez pas la logique d’itération ; vous la désignez.
<?php
class Playlist implements IteratorAggregate
{
private array $tracks = [];
public function add(string $track): void
{
$this->tracks[] = $track;
}
public function getIterator(): Generator
{
foreach ($this->tracks as $track) {
yield $track;
}
}
}
$playlist = new Playlist();
$playlist->add('Track One');
$playlist->add('Track Two');
foreach ($playlist as $track) {
echo "{$track}\n";
}
$ php playlist.php
Track One
Track Two
Le foreach ne sait pas, et ne cherche pas à savoir, que $playlist n’est pas un tableau. Il a demandé à PHP où étaient les valeurs, et IteratorAggregate a répondu. Il existe aussi une interface de plus bas niveau, Iterator, avec current(), next(), valid() et compagnie, pour le cas rare où vous devez piloter l’état de l’itération à la main. Presque toujours, IteratorAggregate est celle qu’il faut choisir, parce que le générateur tient la comptabilité à votre place.
Réunissez les trois sur une même classe et elle devient indiscernable, du point de vue de l’appelant, d’un tableau, tout en conservant la validation et la structure interne qu’un tableau ne pourrait jamais imposer.
Implémentez l’interface, et la syntaxe suit. En dessous, l’objet garde sa propre structure et ses propres règles.
Syntaxe des callables de première classe et closures avancées
array_map('strlen', ...). Cette chaîne de caractères est la façon de passer une fonction en argument depuis les débuts de PHP, et elle a toujours eu quelque chose de bancal : pour votre éditeur, c’est une chaîne qui se trouve contenir un nom de fonction. PHP 8.1 a donné aux fonctions et aux méthodes un vrai moyen de circuler comme des valeurs. Cette section le montre, avec deux astuces de Closure pour du code plus explicite. Les closures et les fonctions fléchées elles-mêmes sont au chapitre 15.
L’ancienne façon de passer une fonction
Avant PHP 8.1, passer une fonction ou une méthode existante à array_map() voulait dire une chaîne ou un tableau :
<?php
$lengths = array_map('strlen', ['a', 'bb', 'ccc']);
class Greeter
{
public function greet(string $name): string
{
return "Hello, {$name}!";
}
}
$greeter = new Greeter();
$greetCallable = [$greeter, 'greet'];
echo $greetCallable('Sam'), "\n"; // Hello, Sam!
Ça marche, et vous le verrez dans quantité de code existant. Mais $greetCallable n’est qu’un tableau qui contient un objet et une chaîne. Votre éditeur ne peut pas sauter de 'greet' à la méthode, et une faute de frappe dans le nom n’est détectée qu’à la ligne qui l’appelle.
La syntaxe des callables de première classe
Écrivez le nom de la fonction ou de la méthode suivi de (...), trois points littéraux, et PHP vous renvoie une Closure qui pointe dessus.
<?php
$lengths = array_map(strlen(...), ['a', 'bb', 'ccc']);
class Greeter
{
public function greet(string $name): string
{
return "Hello, {$name}!";
}
}
$greeter = new Greeter();
$greetCallable = $greeter->greet(...);
echo $greetCallable('Sam'), "\n"; // Hello, Sam!
Même comportement, une différence qui compte : strlen(...) et $greeter->greet(...) sont de vraies références, et vos outils les comprennent. Le saut vers la définition fonctionne. L’analyse statique vérifie la signature. Renommez greet() et la référence périmée est repérée aussitôt, au lieu d’échouer à l’exécution. Ça se lit mieux, aussi : $greeter->greet(...) dit « la méthode greet, en tant que valeur », et c’est exactement ce qui se passe.
Une chaîne, c’est un nom écrit sur un bout de papier.
strlen(...), c’est une poignée sur la fonction elle-même.
Essayez : écorchez greet dans les deux versions. L’ancienne échoue à l’appel. La nouvelle échoue à la ligne qui crée la closure, avant que quoi que ce soit d’autre puisse mal tourner.
Closure::fromCallable()
Parfois, le callable vient de l’extérieur : une valeur de configuration, une chaîne lue dans un fichier. On vous tend l’une des formes traditionnelles et vous voulez un vrai objet Closure, pour pouvoir appeler dessus des méthodes comme bindTo(). Closure::fromCallable() convertit n’importe quelle forme de callable en Closure.
<?php
$callableFromConfig = 'strtoupper';
$closure = Closure::fromCallable($callableFromConfig);
echo $closure('hello'), "\n"; // HELLO
Dans du code neuf, la syntaxe des callables de première classe couvre la plupart des raisons de s’en servir. Vous verrez encore Closure::fromCallable() dans le code de bibliothèques qui doivent accepter un callable sous n’importe laquelle de ses formes historiques et le normaliser.
Les closures statiques
Une closure définie dans une méthode capture discrètement $this. La plupart du temps, c’est pratique : la closure peut rappeler l’objet qui l’a créée. Parfois, vous voulez la garantie inverse, parce que la closure va être confiée ailleurs et doit rester autonome. Marquez-la static, et elle ne peut plus toucher l’objet où elle est née.
<?php
class Report
{
private string $secret = 'internal data';
public function makeFormatter(): Closure
{
return static function (string $line): string {
return strtoupper($line);
};
}
}
$formatter = (new Report())->makeFormatter();
echo $formatter('quarterly summary'), "\n"; // QUARTERLY SUMMARY
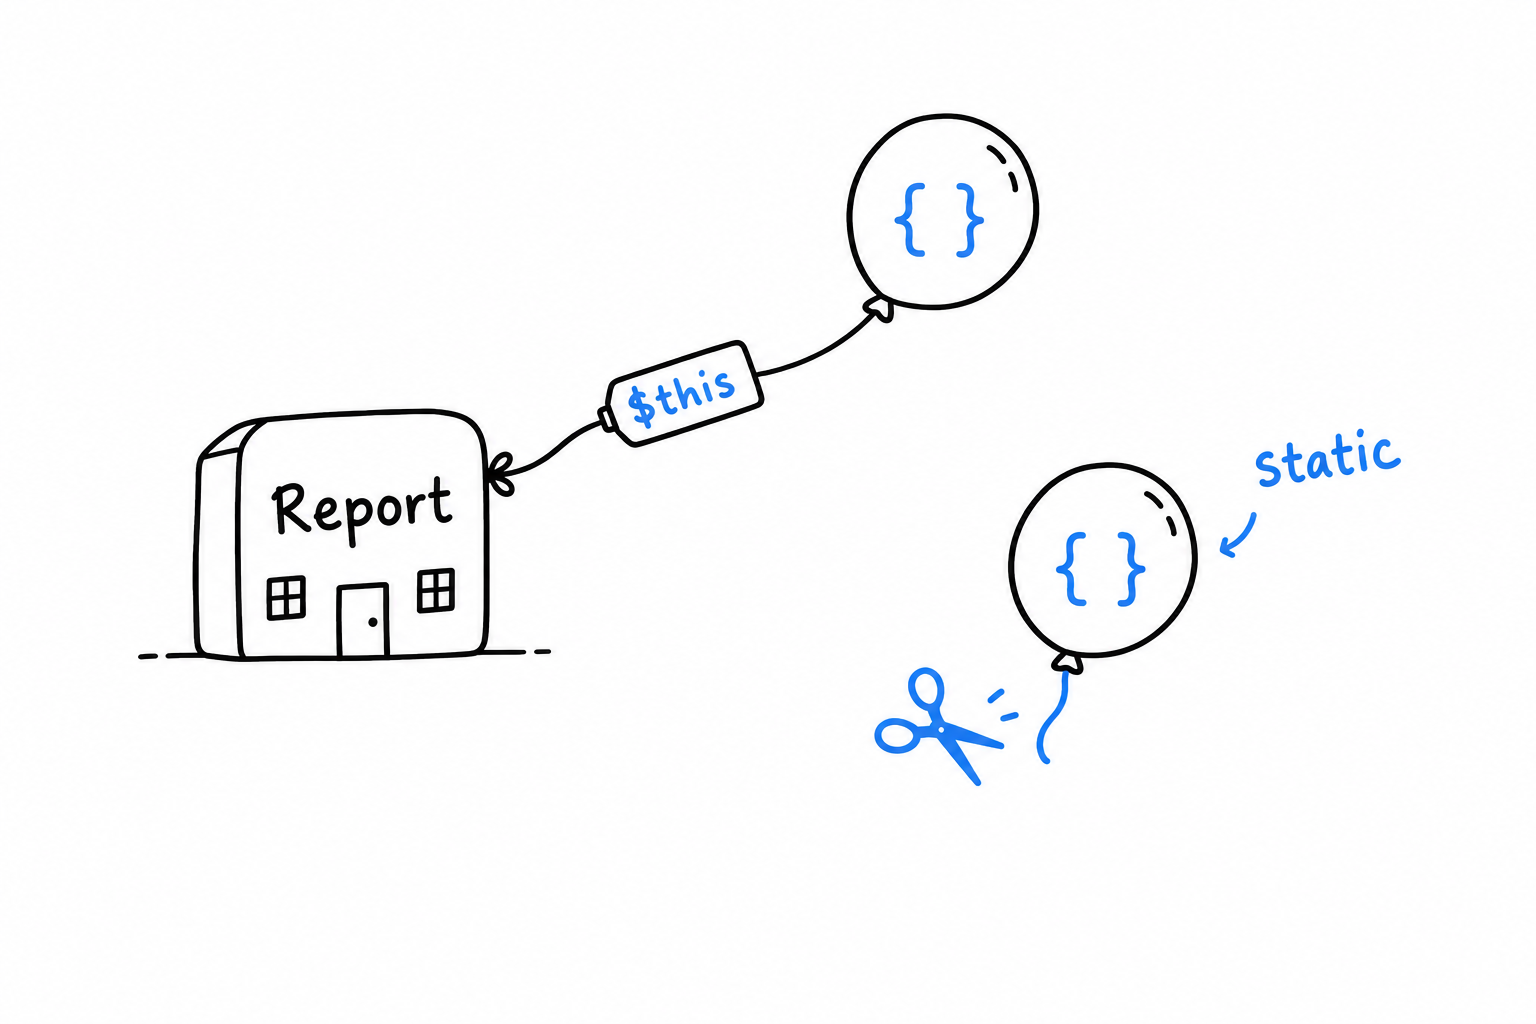
Une closure static function se comporte exactement comme une closure ordinaire, sauf que $this y est indisponible : tenter de l’utiliser est une erreur à la compilation, pas une surprise à l’exécution. Une petite garantie, mais une vraie. Elle dit au lecteur, et à PHP lui-même, que le formateur n’a aucun fil caché vers le Report qui l’a créé.
Attributs
« Cette méthode est un test. » « Cette propriété correspond à une colonne en base. » « Cette route répond à GET /users. » Pendant des années, PHP n’a eu qu’un seul endroit pour ce genre de note : un commentaire au format spécial, un docblock, qu’un framework analysait à l’exécution avec une expression régulière. Ça marchait, et ça restait un peu inconfortable. Le langage ne lisait pas le commentaire, ne le vérifiait pas, et une faute de frappe dedans échouait sans un bruit.
PHP 8 a fait entrer la note dans le langage : un attribut, écrit #[QuelqueChoseCommeCeci] juste au-dessus de ce qu’il décrit.
Définir et attacher un attribut
Un attribut est une classe ordinaire. Ce qui en fait un attribut, c’est le marqueur #[Attribute] de PHP posé au-dessus :
<?php
#[Attribute]
class Route
{
public function __construct(
public readonly string $method,
public readonly string $path,
) {
}
}
Une fois défini, accrochez-le à une méthode avec la syntaxe #[...] :
<?php
class UserController
{
#[Route(method: 'GET', path: '/users')]
public function index(): string
{
return 'List of users';
}
#[Route(method: 'POST', path: '/users')]
public function store(): string
{
return 'User created';
}
}
Lancez ce fichier et il ne se passe rien. #[Route(...)] n’appelle rien par lui-même. C’est une métadonnée inerte, une étiquette pendue à la méthode, qui attend que quelqu’un vienne la lire.
Relire les attributs avec la Reflection
Ce quelqu’un, c’est la Reflection, vue plus tôt dans ce chapitre. ReflectionMethod, comme ReflectionClass et ReflectionProperty, liste les attributs attachés à ce qu’elle reflète, et construit l’objet attribut à la demande.
<?php
$reflection = new ReflectionClass(UserController::class);
foreach ($reflection->getMethods() as $method) {
foreach ($method->getAttributes(Route::class) as $attribute) {
$route = $attribute->newInstance();
echo "{$route->method} {$route->path} -> {$method->getName()}()\n";
}
}
$ php routes.php
GET /users -> index()
POST /users -> store()
getAttributes(Route::class) trouve chaque attribut Route posé sur une méthode. newInstance() le construit, en exécutant le constructeur avec les arguments que vous avez écrits dans #[Route(...)], et renvoie un vrai objet Route avec ses propriétés method et path. C’est ainsi que se construisent les systèmes de routage simples : parcourir les méthodes d’un contrôleur, relever leurs attributs Route, remplir une table de routage avec ce qu’on trouve. Aucun fichier de configuration à part à maintenir en cohérence.
Un attribut est un objet ordinaire, garé à côté de votre code, que la Reflection peut venir ramasser.
Où vous l’avez déjà vu
Si vous avez lu le chapitre 12, ce motif vous est familier. Le #[Test] de PHPUnit marque une méthode comme cas de test de la même façon que #[Route] en marque une ici comme gestionnaire : une classe ordinaire, relue par la Reflection, qui pilote un vrai comportement. Les frameworks s’appuient sur les attributs en permanence. Symfony s’en sert pour les routes et la configuration de l’injection de dépendances, Doctrine pour associer des propriétés à des colonnes en base, PHPUnit pour les métadonnées de test en tout genre.
Vous n’écrirez peut-être pas beaucoup d’attributs à vous. Vous lirez #[...] au-dessus de méthodes et de classes tous les jours dans du PHP moderne, et vous savez maintenant exactement ce qui se passe quand vous en voyez un : un objet ordinaire, qui attend d’être relu par la Reflection.
Projet final : construire une petite application web
Vous avez toutes les pièces. Classes et promotion de constructeur, espaces de noms et Composer, tableaux et collections, exceptions, interfaces : les chapitres précédents vous ont donné le vocabulaire courant du PHP moderne, un mot à la fois. Ce chapitre assemble ces pièces en une seule chose, petite et cohérente : une application web construite avec rien d’autre que PHP.
Pas de framework, et c’est voulu. Vous utiliserez sans doute Laravel ou Symfony au travail, et vous aurez raison. Mais s’en servir avant d’avoir construit quelque chose sans, c’est accepter leurs facilités sur parole. Routeur, contrôleur, vue : ce ne sont que des noms posés sur des motifs qui apparaissent d’eux-mêmes dès qu’on résout les petits problèmes que toute application web rencontre. Construisez-les une fois à la main, à cette échelle, et tout ce qu’un framework fera ensuite se lira comme « ah, c’est le truc que je connais déjà » plutôt que comme de la magie.
La construction se fait en trois temps. D’abord le plus petit routeur possible : un seul fichier, le serveur de développement fourni avec PHP, et quelques if qui décident quoi renvoyer. Ensuite ce fichier grandit jusqu’à prendre une forme MVC, avec de vraies classes de contrôleurs et le plus vieux talent de PHP, le templating, enfin utilisé comme il faut. Pour finir, un regard sur la façon dont la vie d’une requête se termine vraiment, et sur la manière d’exécuter du code de nettoyage à cet instant précis, ce qui ramène au modèle de requête du chapitre 18.
Bien moins de deux cents lignes au total. Ce que vous en garderez dépasse le code : une image nette de ce qui se passe sous les frameworks que vous prendrez en main ensuite.
Un routeur en un seul fichier avec le serveur intégré de PHP
Un navigateur demande /about. Quelque part sur le serveur, un bout de code doit répondre. Lequel ? La partie d’une application web qui transforme une URL en un bout de code s’appelle un routeur, et chaque framework en a un, si gros soit-il. Avant d’utiliser le leur, construisez le plus petit qui puisse fonctionner, pour voir exactement ce qu’il fait.
Le serveur de développement intégré à PHP
Il faut un serveur web pour recevoir la requête, et PHP en cache un dans la commande php elle-même. Ni Apache, ni nginx, rien à installer. Il n’est pas fait pour la production, mais pour développer et apprendre, c’est exactement ce qu’il faut :
$ php -S localhost:8000 router.php
[Thu Aug 20 10:00:00 2026] PHP 8.3.0 Development Server (http://localhost:8000) started
Cette commande lance un serveur sur le port 8000 et fait passer chaque requête entrante par router.php. Aucune correspondance automatique avec un fichier sur le disque. C’est votre script qui décide, pour chaque requête, quoi renvoyer. On voit tout, et c’est précisément ce qu’on veut.
Le routeur lui-même
Créez router.php :
<?php
$uri = parse_url($_SERVER['REQUEST_URI'], PHP_URL_PATH);
$routes = [
'/' => function (): string {
return "Welcome to the home page.\n";
},
'/about' => function (): string {
return "This is a tiny PHP application, built without a framework.\n";
},
];
header('Content-Type: text/plain');
if (isset($routes[$uri])) {
echo $routes[$uri]();
} else {
http_response_code(404);
echo "404 Not Found: {$uri}\n";
}
Lisez-le depuis le haut. $_SERVER['REQUEST_URI'] est l’endroit où PHP range le chemin demandé par le navigateur : /, /about, ce qui a été tapé ou cliqué. parse_url(..., PHP_URL_PATH) en coupe la chaîne de requête éventuelle (?foo=bar), si bien que /about?ref=email et /about tombent sur la même route.
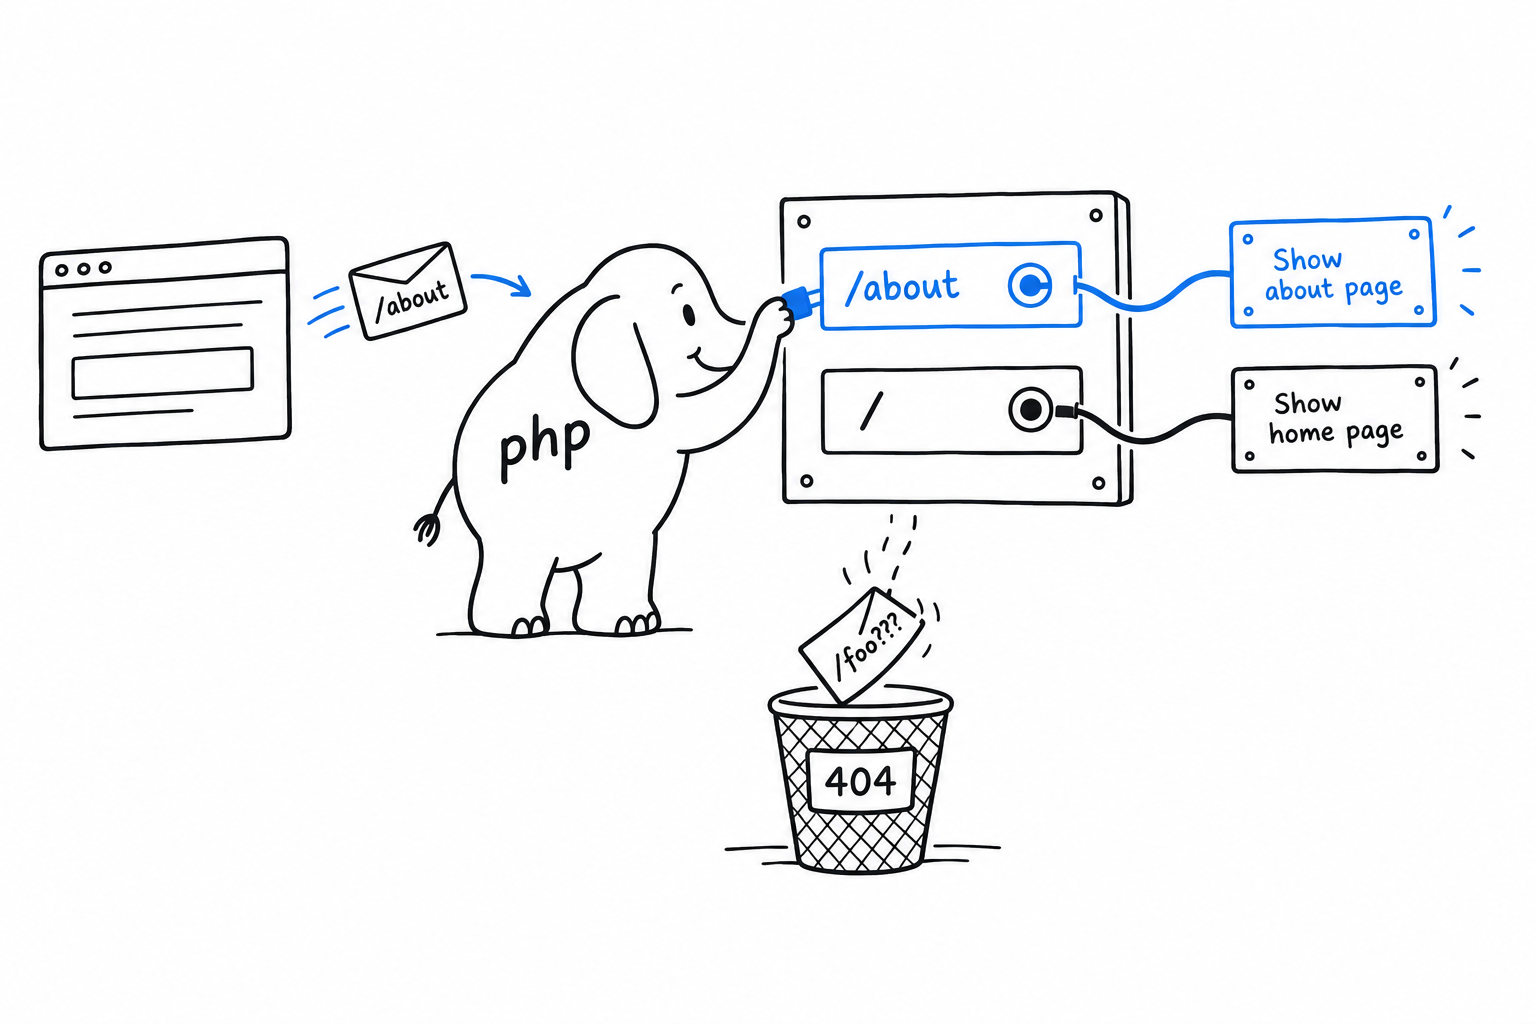
Ensuite, $routes est un tableau associatif, une simple table de correspondance : un chemin à gauche, et à droite une closure qui produit la réponse. Le routeur cherche le chemin dans la table ; si c’est une clé connue, il appelle la closure et affiche ce qu’elle renvoie. Sinon, il répond 404, comme n’importe quel serveur devant une page qui n’existe pas.
Essayez, le serveur toujours lancé dans un autre terminal :
$ curl http://localhost:8000/
Welcome to the home page.
$ curl http://localhost:8000/about
This is a tiny PHP application, built without a framework.
$ curl http://localhost:8000/nonexistent
404 Not Found: /nonexistent
Ajoutez maintenant une route à vous : une clé /contact avec une closure qui renvoie le texte de votre choix. Enregistrez, et demandez-la à curl. Pas besoin de relancer quoi que ce soit, le serveur exécute router.php à neuf à chaque requête.
Ce que ça fait (et ne fait pas)
Ce routeur ignore tout des paramètres de chemin (/users/{id}), des méthodes HTTP (GET contre POST sur le même chemin) et des middlewares. Les vrais routeurs ajoutent tout cela. Mais dans leur structure, ils font ce que font ces quinze lignes : regarder quelque chose dans la requête entrante, et aiguiller vers un bout de code en fonction.
Un routeur, c’est une table de correspondance avec un 404 en bas.
Quinze lignes suffisent pour voir le mécanisme. Elles ne suffisent pas pour grandir : dès que chaque route devra produire du vrai HTML, les closures de ce tableau deviendront un fouillis. La section suivante donne à chaque route un vrai chez-soi.
Structurer une petite application façon MVC
Deux routes, deux closures, un fichier : le routeur de la section précédente fonctionne. Ajoutez dix routes et il cesse d’être lisible, parce que ce que chaque route fait se mélange à la façon dont elle a été trouvée. Les vraies applications séparent les deux. Le découpage classique s’appelle Modèle, Vue, Contrôleur, MVC pour faire court, et même à notre échelle sa forme vaut la peine : un contrôleur décide de ce qui doit se passer pour une requête, et une vue décide de la façon dont le résultat devient du HTML. Pas de modèle pour l’instant, faute de données à conserver. Deux ou trois routes suffisent pour voir le motif.
Les contrôleurs
Un contrôleur, à cette taille, est une classe dont chaque méthode prend en charge une route et renvoie le corps de la réponse sous forme de chaîne de caractères :
<?php
class HomeController
{
public function index(): string
{
return render('home', ['title' => 'Welcome']);
}
}
class AboutController
{
public function show(): string
{
return render('about', [
'title' => 'About',
'description' => 'A tiny PHP application, built without a framework.',
]);
}
}
Regardez ce qui manque. Rien ici ne lit $_SERVER, rien ne sait par quelle URI on est arrivé. C’est l’affaire du routeur. Une méthode de contrôleur n’a qu’un travail : produire une réponse. Elle reste facile à lire, et facile à tester : appelez (new HomeController())->index() et regardez la chaîne qui revient.
Les vues : le premier talent de PHP
render() est l’endroit où vit la couche des vues, et elle s’appuie sur quelque chose que PHP sait faire depuis le premier jour. Sous le langage de programmation, PHP est un langage de templates. C’était sa raison d’être à l’origine, avant qu’il ne grandisse dans toutes les directions. Une vue est un fichier ordinaire avec du HTML dedans et de petits îlots de PHP pour les parties mobiles, le même style <?php ... ?>-dans-du-HTML que les toutes premières pages de ce livre.
Créez views/home.php. À la différence des autres exemples du livre, celui-ci est un fichier HTML avec des îlots de PHP, pas un fichier PHP à part entière, donc il ne commence pas par <?php :
<!DOCTYPE html>
<html>
<head><title><?= htmlspecialchars($title) ?></title></head>
<body>
<h1><?= htmlspecialchars($title) ?></h1>
<p>This page was rendered from views/home.php.</p>
</body>
</html>
Et une petite fonction qui inclut un fichier de vue en lui rendant des données accessibles :
<?php
function render(string $view, array $data = []): string
{
extract($data);
ob_start();
include __DIR__ . "/views/{$view}.php";
return ob_get_clean();
}
Quatre lignes, chacune avec son rôle. extract() transforme chaque clé de $data en variable locale : 'title' => 'Welcome' devient $title, visible dans le fichier inclus. ob_start() et ob_get_clean(), c’est la mise en tampon de la sortie. Sans elles, le HTML du fichier inclus partirait directement vers le navigateur. Avec elles, il est capturé dans un tampon et rendu sous forme de chaîne, que le contrôleur peut retourner comme n’importe quelle autre valeur.
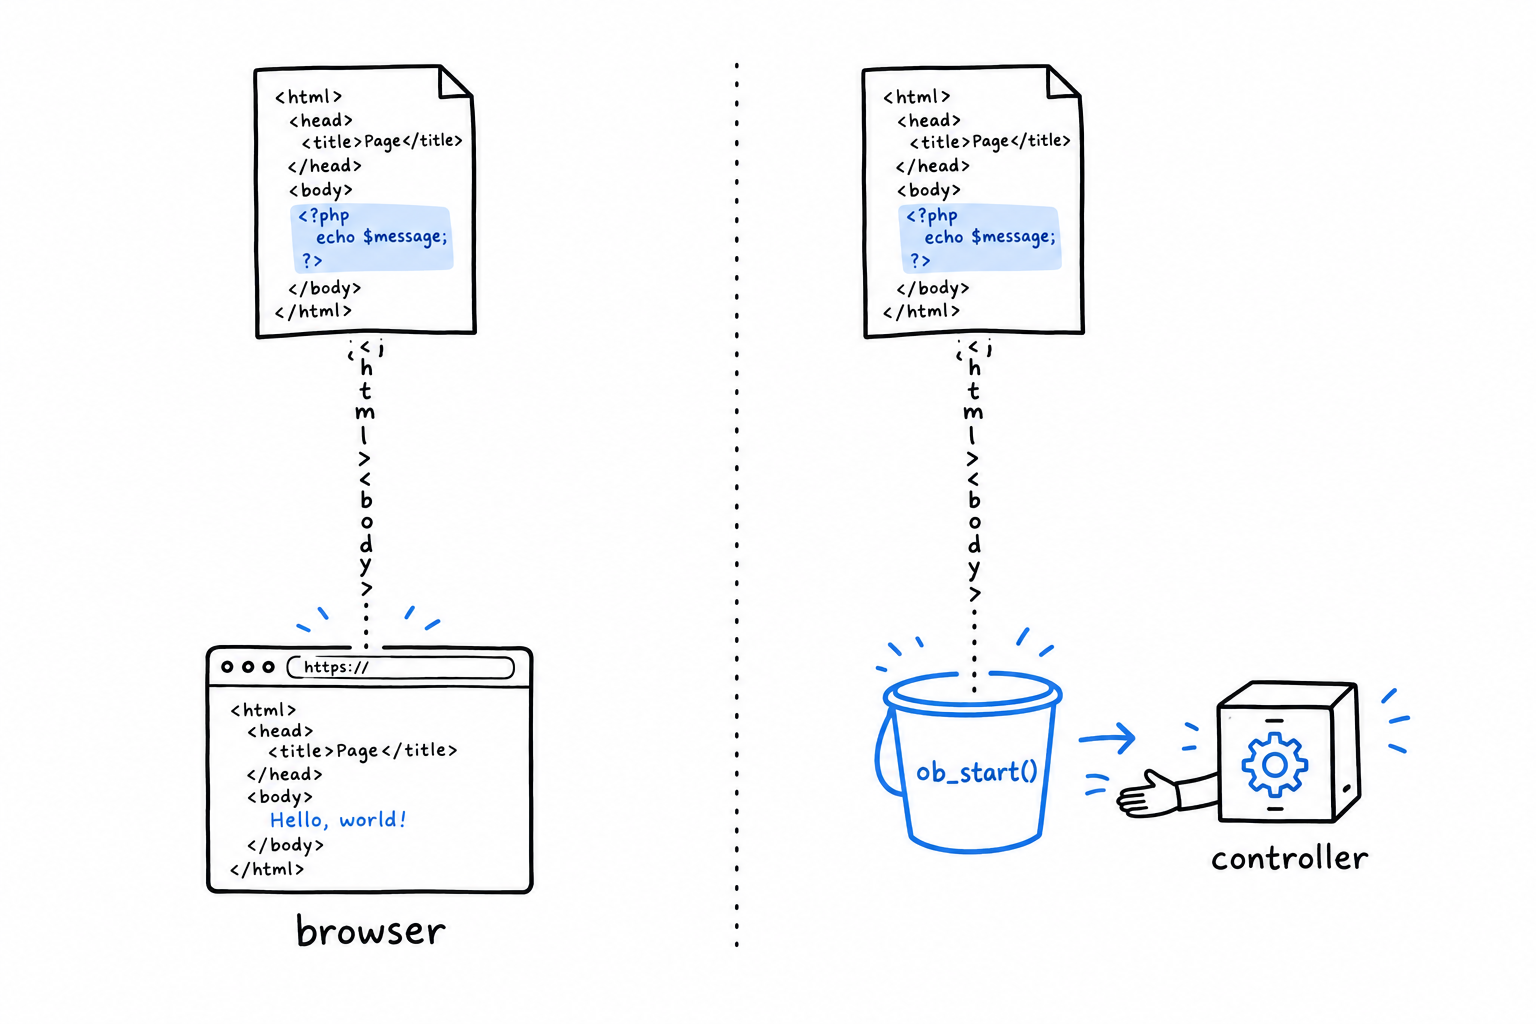
De retour dans la vue, <?= ... ?> est le raccourci de <?php echo ... ?>, et $title passe par htmlspecialchars() avant d’être affiché. C’est cet appel, et lui seul, qui empêche un texte venu d’un utilisateur d’être interprété comme du HTML. Faites-en un réflexe.
Relier le routeur aux contrôleurs
Modifiez router.php pour qu’il aiguille vers des méthodes de contrôleurs au lieu de closures :
<?php
require __DIR__ . '/render.php';
require __DIR__ . '/controllers.php';
$uri = parse_url($_SERVER['REQUEST_URI'], PHP_URL_PATH);
$routes = [
'/' => [HomeController::class, 'index'],
'/about' => [AboutController::class, 'show'],
];
if (isset($routes[$uri])) {
[$class, $method] = $routes[$uri];
echo (new $class())->{$method}();
} else {
http_response_code(404);
echo "404 Not Found: {$uri}";
}
$routes associe maintenant chaque chemin à une paire [classe, méthode] plutôt qu’à une closure. La paire est déstructurée sur place avec [$class, $method] = $routes[$uri], la syntaxe du chapitre 19 ; new $class() construit le contrôleur, et ->{$method}() appelle la méthode dessus.
Suivez une requête d’un bout à l’autre.
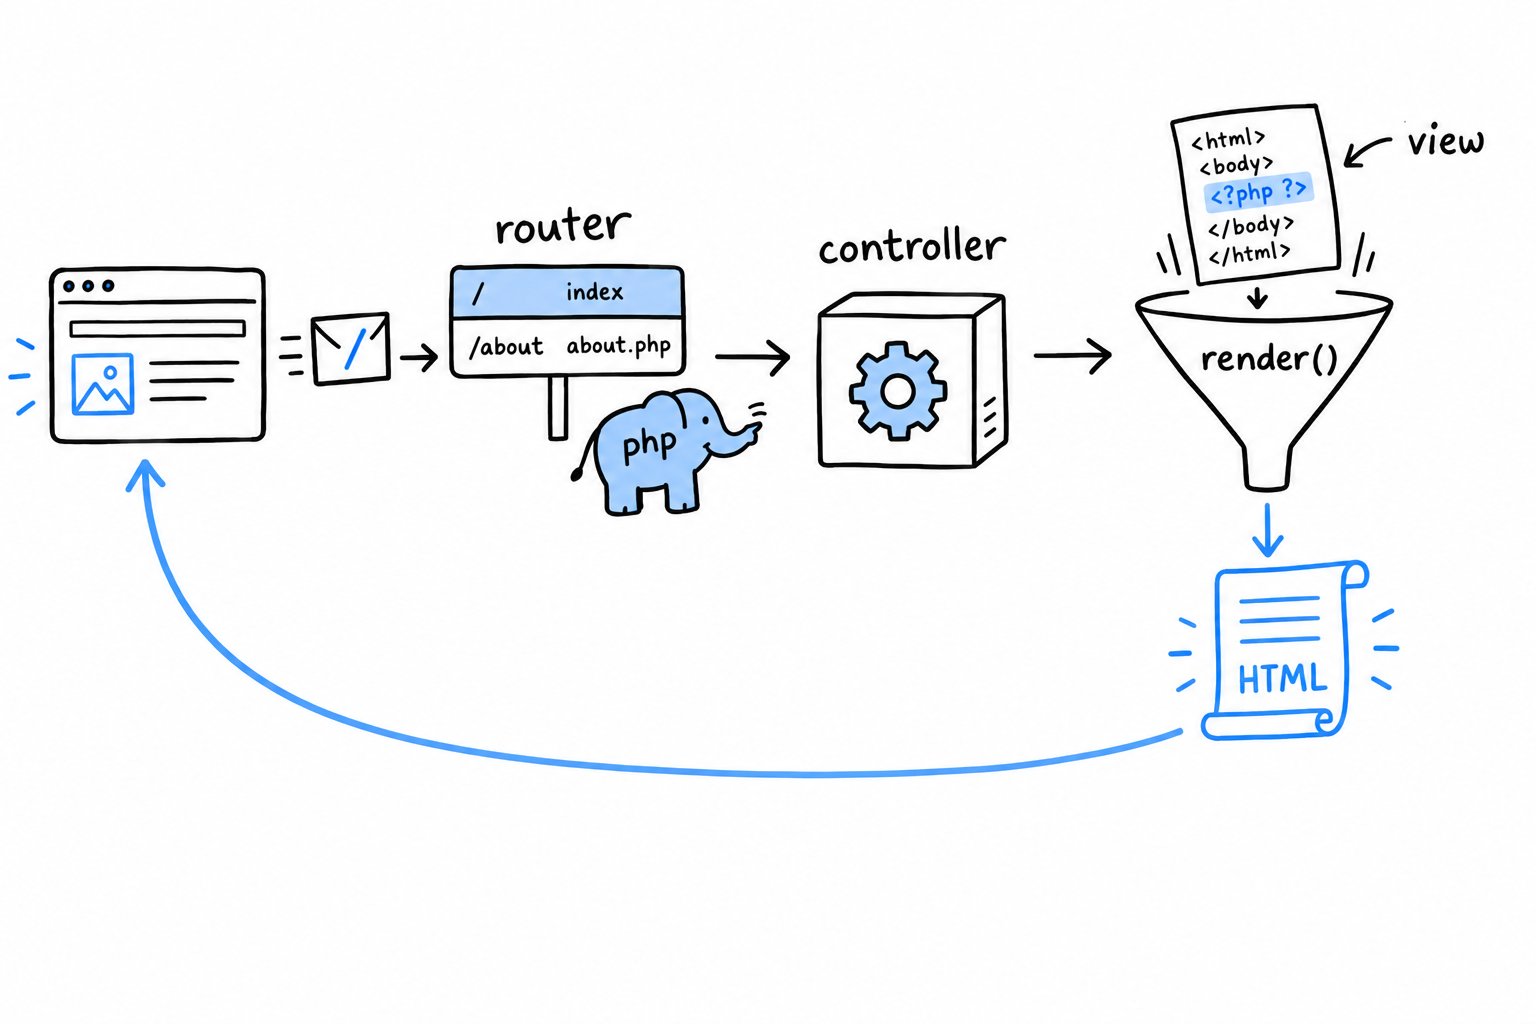
Le navigateur demande /. Le routeur trouve HomeController et index dans sa table, construit le contrôleur, appelle la méthode. La méthode appelle render('home', ...), qui inclut views/home.php en capturant sa sortie et renvoie le HTML sous forme de chaîne. La chaîne repart vers le routeur, qui l’affiche. Réponse envoyée.
Cet aller-retour, c’est ce sur quoi repose le routeur de tous les frameworks : regarder la requête, trouver la classe et la méthode qui en ont la charge, les appeler, renvoyer ce qu’elles donnent. La mécanique est petite, et c’est toute l’idée.
Essayez : /about a un contrôleur mais pas de vue. Écrivez views/about.php sur le modèle de home.php, avec $description dedans, et demandez /about à curl.
Gérer la fin du script et le nettoyage
Tout script PHP se termine. La plupart du temps, il se termine en exécutant sa dernière ligne. Parfois, il se termine sur une erreur fatale que personne n’avait prévue. Dans les deux cas, il y a souvent quelque chose dont vous voulez être sûr en sortant : fermer un fichier, noter dans un journal que la requête est finie, envoyer une écriture en attente à la base de données. try/finally, vu au chapitre 9, couvre les cas ordinaires. Il ne couvre pas la vraie erreur fatale, celle qui arrête l’exécution net, sans exception à attraper. Pour celle-là, PHP vous donne une prise sur le tout dernier instant de la vie du script.
register_shutdown_function()
<?php
register_shutdown_function(function (): void {
echo "Cleaning up before the script ends.\n";
});
echo "Doing regular work.\n";
// Simulate something going badly wrong.
strlen(); // fatal error: too few arguments
$ php shutdown_demo.php
Doing regular work.
Cleaning up before the script ends.
Fatal error: Uncaught ArgumentCountError: strlen() expects exactly 1 argument, 0 given...
Regardez l’ordre de cette sortie : le message de nettoyage arrive avant l’erreur fatale. La fonction de shutdown s’exécute à la toute fin de la requête, quelle que soit la façon dont le script y est arrivé : après un retour normal, après une exception non attrapée, après la plupart des erreurs fatales. Vous enregistrez le callback une fois, vers le haut de votre application (en vrai, dans le code d’amorçage d’un framework), et PHP promet de l’exécuter en sortant. C’est ce que PHP a de plus proche de « quoi qu’il arrive, exécute ceci en dernier ».
Essayez : remplacez la ligne strlen(); par exit;, puis par throw new RuntimeException('boom');. La ligne de nettoyage apparaît à chaque fois.
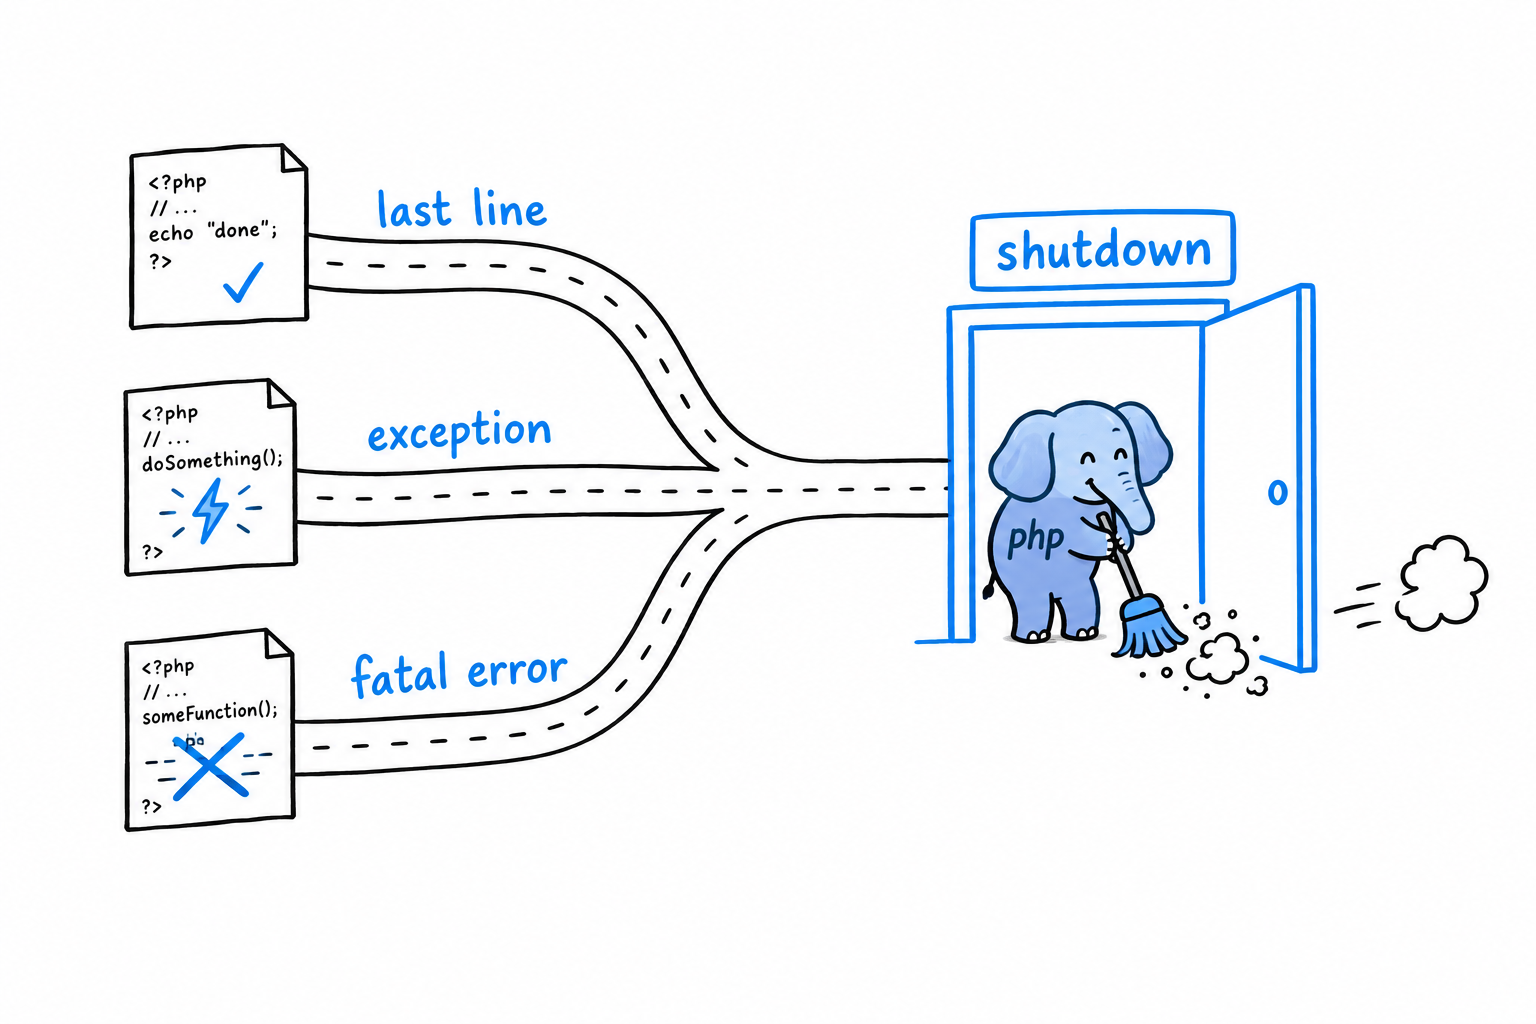
Là où la vie d’un script se termine vraiment
C’est le modèle de requête sans partage du chapitre 18, vu depuis la fin. Dans le cycle de vie traditionnel de PHP, la « fin » d’un script est un instant précis : la réponse a été envoyée, et le processus (ou le thread) qui a pris en charge cette requête est sur le point d’être recyclé ou démonté pour la suivante. Tout ce que le script a alloué (variables, objets, descripteurs de fichiers gérés par PHP lui-même) est nettoyé dans ce démontage, fonctions de shutdown comprises. Il n’y a pas de processus qui dure et dans lequel la mémoire pourrait fuir, comme peut le faire un serveur Node.js qui tourne depuis des semaines. Chaque requête part d’une page blanche, et le désordre de chaque requête, nettoyé ou non, meurt avec elle.
C’est aussi pour cela que register_shutdown_function() veut dire plus, en PHP, que « s’exécute à la fin ». Ce n’est pas une tâche de fond, et ce n’est pas remis à plus tard comme l’est une tâche mise en file d’attente au chapitre 18. Elle s’exécute de manière synchrone, en ligne, avant que l’histoire de cette requête précise ne soit close. Voilà ce qui en fait le bon endroit pour « noter que cette requête s’est terminée » ou « libérer le verrou que cette requête tenait », et le mauvais endroit pour tout ce qui devrait se passer indépendamment de cette requête.
Une fonction de shutdown, c’est la dernière chose que fait cette requête. Pas quelque chose qui se passe plus tard.
Où vous en êtes
Regardez ce que ce projet a utilisé : un routeur fait d’un tableau et d’une poignée de if, des contrôleurs qui sont de simples classes avec des méthodes, une couche de vues dans le même style PHP-dans-du-HTML que la première page du livre, et une fonction de shutdown qui boucle le cycle de vie d’une requête. Rien de tout cela n’a demandé de framework. Tout cela est, en miniature, ce qu’un framework fournit à grande échelle.
Vous avez commencé ce livre avec echo "Hello, world!\n";, à peu près le plus petit programme qui existe. Vous le terminez en assemblant des classes, des espaces de noms, des interfaces, la gestion des erreurs et le cycle de vie d’une requête en quelque chose qui sert des pages web. La syntaxe entre les deux n’a jamais été le sujet. Le sujet, c’était le discernement qui fait prendre la bonne pièce au bon moment, et ce discernement est la seule chose qu’aucun livre ne peut finir pour vous. Il vient en écrivant plus de PHP que vous n’en avez écrit jusqu’ici.
Allez en écrire.
Et maintenant ?
Vous avez ouvert ce livre en faisant afficher une phrase à PHP. Vous le refermez avec une application web construite à partir de rien : un routeur, des contrôleurs, des vues, une base de données derrière, des tests autour. C’est parler le langage couramment, et ce n’est pas rien.
Ce n’est pas non plus tout le métier. L’essentiel de ce qui reste n’est pas le langage PHP, mais PHP en situation : les outils qui portent votre code de votre ordinateur jusqu’à un serveur, les habitudes qui gardent une base de code d’équipe saine, les autres systèmes avec lesquels vos programmes dialoguent, et les gens qui ont construit tout cela.
Ce qui suit est une carte, pas un tutoriel, dans l’esprit du tour d’horizon que le chapitre 18 a consacré à la concurrence. Pour chaque destination, vous en saurez assez pour la reconnaître par son nom, savoir à quoi elle sert, et savoir quoi chercher le jour où vous en aurez besoin. Rien de tout cela n’est nécessaire pour écrire du bon PHP. Tout devient utile dès que votre logiciel grossit, dure, ou gagne un deuxième contributeur, autrement dit, tôt ou tard, presque tout.
Il y a cinq destinations. Les frameworks et l’outillage, c’est la version toute prête de ce que le chapitre 21 a construit à la main, et la chaîne d’outils autour. L’architecture et le processus, c’est organiser le code, et les habitudes d’équipe qui rendent ses évolutions sûres. La sécurité et la performance durcissent ce que le chapitre 10 a commencé et le gardent rapide quand le vrai trafic arrive. Au-delà de PHP regarde les autres langages, les autres technologies, et le moteur sur lequel PHP lui-même tourne. La communauté, ce sont les gens qui ont bâti tout ce qui précède, et la façon de les trouver.
Lisez celle qui correspond à ce que vous allez faire ensuite. Aucune ne suppose que vous ayez lu les autres.
Les frameworks et l’outillage autour
Les frameworks
Le chapitre 21 vous a fait écrire un routeur, des contrôleurs et une couche de vues à la main, exprès, pour que rien de tout cela ne ressemble jamais à de la magie. Un framework, c’est la même silhouette, déjà construite, éprouvée par des milliers de projets, avec un écosystème de paquets assemblé autour. En choisir un n’est pas un aveu d’échec. C’est s’épargner un travail que d’autres ont déjà bien fait.
Deux frameworks dominent le monde PHP, et ils ne font pas le même pari.
Laravel arrive avec tout inclus. Un ORM (Eloquent), un moteur de templates (Blade), un outil en ligne de commande (Artisan), des files d’attente, une authentification prête à l’emploi, et bien d’autres choses, le tout conçu pour fonctionner ensemble dès l’installation. C’est aujourd’hui la porte d’entrée la plus courante pour un nouveau projet PHP.
Symfony est construit composant par composant. Ses briques (le routage, l’injection de dépendances, l’abstraction HTTP) s’utilisent chacune séparément, et il préfère l’explicite à la convention. C’est souvent le choix des bases de code plus grosses et plus durables, et certaines de ses briques font tourner discrètement d’autres projets, Laravel compris.
Des frameworks plus petits, comme Slim ou Mezzio, existent pour les cas où un framework complet est trop pour le projet, une API sans aucune vue, par exemple. Choisissez d’après ce dont le projet et l’équipe ont vraiment besoin, pas d’après le nom qui fait le plus de bruit en ligne. Comme vous avez construit les pièces vous-même, aucun ne devrait vous paraître opaque : ouvrez un contrôleur Laravel ou une route Symfony et vous en reconnaîtrez la forme.
Un framework, c’est le chapitre 21, fait avant vous par mille personnes.
L’outillage
L’annexe D a présenté les outils que vous lancez pendant que vous écrivez du PHP : Composer, PHPUnit, l’analyse statique, un débogueur. La couche suivante s’occupe de ce qui se passe une fois le code écrit : l’amener sans casse de votre machine jusqu’en production, et le garder en bonne santé une fois là-bas.
L’intégration continue (GitHub Actions, GitLab CI) lance votre suite de tests, PHPStan et votre vérificateur de style à chaque push, si bien qu’une modification cassée est repérée avant qu’un humain ait à s’en apercevoir. Les conteneurs (Docker) emballent PHP, ses extensions et ses dépendances dans quelque chose qui tourne à l’identique sur votre portable, en CI et en production, ce qui met fin à la conversation « ça marche sur ma machine ». Les outils de déploiement (Deployer, ou des plateformes gérées comme Laravel Forge et Platform.sh) automatisent « mettre le nouveau code sur le serveur correctement », une tâche qui, à la main, compte plus d’étapes qu’elle ne devrait.
Deux outils vont un cran plus loin. Rector refactorise le code mécaniquement, y compris pour faire monter toute une base de code d’une version de PHP à l’autre en bloc plutôt que fichier par fichier, ce qui compte dès que les questions de compatibilité de l’annexe E cessent d’être théoriques. Infection teste vos tests. Il glisse volontairement de petits bugs dans votre code et vérifie si la suite du chapitre 12 s’en aperçoit, une question plus pointue que « est-ce que les tests passent ».
Aucune de ces idées n’est propre à PHP. Ce qui est propre à PHP, c’est à quel point elles s’y emboîtent bien : l’écosystème dispose d’un outillage mûr, ennuyeux et bien documenté pour chacune d’elles, et l’ennui est un vrai avantage face à des écosystèmes plus clinquants dont l’outillage est plus mince en dessous.
L’architecture et le processus de développement
L’architecture
Passé une poignée de fichiers, « où vit ce bout de code, et pourquoi là » cesse d’être évident. Cela devient une discipline à part entière. Vous en avez déjà pratiqué la plus petite forme : le patron Stratégie du chapitre 17 a sorti un comportement variable derrière une interface, si bien que la classe qui s’en servait n’avait jamais besoin de savoir quelle version elle recevait. L’architecture, c’est ce même réflexe, appliqué à toute une base de code au lieu d’une seule classe.
Quelques noms valent la peine d’être reconnus.
L’architecture en couches sépare les responsabilités comme l’ont fait le routeur, les contrôleurs et les vues du chapitre 21, en plus formel : des couches explicites (présentation, logique métier, persistance), et des règles sur qui a le droit de dépendre de qui.
Le Domain-Driven Design, DDD pour les intimes, nomme les classes et les méthodes d’après les concepts que le métier emploie vraiment, plutôt que d’après l’arborescence du framework, pour que le code se lise comme le problème qu’il résout.
L’architecture hexagonale, aussi appelée ports et adaptateurs, garde votre logique centrale dans l’ignorance de la base de données et du framework qui l’entourent, de sorte qu’on peut la tester et raisonner dessus sans que ni l’un ni l’autre ne soit dans la pièce.
Monolithe contre microservices est le débat que vous entendrez le plus souvent. Un monolithe bien organisé reste le bon choix bien plus longtemps que la sagesse d’internet ne le suggère. Découper un système en services résout des problèmes d’organisation (beaucoup d’équipes qui livrent indépendamment), pas des problèmes techniques, et cela en apporte de nouveaux, bien réels : coordonner à travers un réseau au lieu d’un seul processus, le modèle sans état partagé du chapitre 18 répété à une tout autre échelle.
Aucun de ces noms n’est une règle à appliquer partout. C’est du vocabulaire. Le jour où la structure d’une base de code commence à faire mal, vous aurez un mot à chercher.
Les noms d’architecture sont du vocabulaire, pas des ordres.
Le cycle de vie du logiciel
L’architecture organise le code. Le reste des pratiques autour d’un projet organise les gens qui modifient ce code, et le chemin qu’une modification parcourt depuis l’idée jusqu’à quelque chose qui tourne en production sans danger.
Les branches et la revue de code donnent à une équipe une façon commune de proposer un changement et de le faire regarder par quelqu’un d’autre avant qu’il ne soit fusionné, ce qui attrape les problèmes qu’une suite de tests ne voit pas. Le versionnage donne un sens aux publications : le même schéma MAJEUR.MINEUR.CORRECTIF que l’annexe E a utilisé pour les promesses de compatibilité de PHP s’applique à tout paquet que vous publiez selon le chapitre 16. Les environnements gardent le local, la préproduction et la production raisonnablement semblables, bâtis sur les variables d’environnement du chapitre 14 plutôt que sur des différences codées en dur. Le suivi des tickets et les changelogs conservent une trace de ce qui a changé et pourquoi, en marge de l’historique des commits, qu’un collègue (ou vous, dans six mois) pourra vraiment lire.
Rien de tout cela n’est propre à PHP non plus. Ce qui mérite d’être dit, c’est que PHP rend cette discipline particulièrement facile à sauter. Pas de compilation, pas d’attente de build : on modifie, on recharge, c’est bon. On peut vivre longtemps sans elle et ne rien sentir de travers, jusqu’au jour où le projet a assez d’historique et assez de contributeurs pour que l’avoir sautée finisse par coûter quelque chose.
Sécurité et performance
La sécurité
Le chapitre 10 a traité le XSS et l’injection SQL correctement, et a nommé le CSRF sans s’en défendre. C’est le début de la sécurité d’une application web, pas le tout. Quelques directions de plus méritent qu’on sache qu’elles existent.
L’authentification et l’autorisation répondent à deux questions distinctes : qui fait cette requête, et qu’a-t-il le droit de faire. password_hash() et password_verify() sont la façon intégrée à PHP, et correctement salée, de stocker des mots de passe. Les sessions suivent un utilisateur connecté d’une requête à l’autre, malgré le modèle sans état partagé du chapitre 18. OAuth couvre le « se connecter avec un compte d’ailleurs ».
Une base de code n’est jamais plus sûre que les paquets qu’elle embarque, et le chapitre 16 vous a appris à en embarquer beaucoup. composer audit compare les paquets installés à une base de vulnérabilités connues, et Roave Security Advisories empêche carrément d’installer une version de paquet avec une faille connue.
Le Top 10 de l’OWASP est une liste standard, régulièrement mise à jour, des vulnérabilités les plus courantes des applications web, XSS et injection SQL comprises. Lisez-le une fois, comme une carte de ce contre quoi se défendre au-delà de ce que ce livre a couvert.
Les secrets sont la dernière direction : ne jamais commiter un identifiant dans un dépôt. Les variables d’environnement, le mécanisme du chapitre 14, sont le plancher. Un coffre à secrets dédié (Vault, ou le gestionnaire de secrets d’un fournisseur de cloud) est le plafond pour tout ce qui manipule de vraies données d’utilisateurs.
Performance et observabilité
Par défaut, PHP compile votre code source en bytecode à chaque requête, puis jette le résultat. Opcache conserve ce bytecode compilé d’une requête à l’autre. L’activer en production n’est pas tant une option qu’une évidence.
Les couches de cache comme Redis et Memcached vous donnent un endroit où ranger des données coûteuses à recalculer ou à aller rechercher. Le modèle sans état partagé du chapitre 18 signifie que rien ne survit entre deux requêtes si vous ne le déposez pas quelque part exprès, la raison même pour laquelle le chapitre 10 a eu besoin d’une base de données.
Profiler en production demande d’autres outils. Le profileur de Xdebug du chapitre 13 est fait pour le développement, bien trop lent pour rester actif sous du vrai trafic. La production s’appuie sur des instruments plus légers : Blackfire, ou des produits généralistes de supervision applicative comme Datadog et New Relic.
Savoir après coup ce qu’une requête a fait compte davantage en PHP que dans un serveur qui tourne en continu, précisément parce que l’état de chaque requête disparaît dès qu’elle se termine. Les logs structurés, les métriques par requête et le traçage distribué sont ce qui vous permet de reconstituer les faits une fois que « j’ajoute un var_dump() et je relance » n’est plus une option.
Les deux directions partagent un même fil. Le livre d’or du chapitre 10 et le projet final du chapitre 21 ont été construits pour enseigner correctement le modèle sous-jacent. Aucun des deux n’a été bâti pour survivre à un internet hostile ou à un trafic sérieux, et c’est très bien ainsi. C’est à cela que sert cette section.
Au-delà de PHP : autres langages, autres technologies, et le moteur lui-même
Parler à d’autres langages
Les vrais systèmes sont rarement écrits dans un seul langage, et la façon courante de les mélanger n’est pas de les lier ensemble mais de les faire dialoguer par une API. Chaque côté expose une interface neutre, en HTTP ou en gRPC, que n’importe quel langage peut appeler. Un backend PHP et un service écrit en Go ou en Rust se parlent ainsi à longueur de journée, sans qu’aucun des deux sache dans quoi l’autre est écrit.
Deux routes plus directes existent. FFI (Foreign Function Interface, depuis PHP 7.4) appelle directement une bibliothèque C compilée depuis PHP, sans écrire une extension complète. C’est étroit, utile quand ça s’applique, et bon à connaître. À l’autre bout de l’échelle d’effort, proc_open() du chapitre 18 lance tout simplement un programme écrit dans autre chose et relit ce qu’il affiche.
Parler à d’autres technologies
Le chapitre 10 a utilisé SQLite parce qu’il ne demandait aucun serveur à part. La plupart du PHP en production parle plutôt à MySQL, MariaDB ou PostgreSQL, par la même interface PDO et un DSN différent, chacun avec les particularités de son dialecte SQL, qu’il vaut mieux connaître.
La file d’attente du chapitre 18 grandit en logiciel dédié, comme RabbitMQ ou Amazon SQS, pour le travail en arrière-plan qui doit survivre à un plantage ou se répartir sur plusieurs workers de manière fiable. Les moteurs de recherche (Elasticsearch, Meilisearch) prennent le relais le jour où une requête LIKE '%...%' ne suffit plus : la recherche plein texte et à facettes réclame une infrastructure faite pour cela. Les services cloud (le stockage d’objets comme S3 et ses nombreux équivalents compatibles, les bases de données gérées, les files gérées) sont en grande partie les mêmes idées, exploitées et dimensionnées par quelqu’un d’autre.
Étendre le moteur lui-même
Les pilotes PDO et Xdebug que vous avez déjà utilisés sont des extensions PHP : du code écrit en C sur l’API du Zend Engine, installé via PECL. Zephir est un langage de plus haut niveau qui se compile en une vraie extension, pour les équipes qui veulent ce niveau de performance sans écrire du C brut à la main.
Cette couche mérite d’être connue et mérite rarement d’être utilisée. Presque tout ce dont une application a besoin se fait en PHP ordinaire, côté utilisateur. Écrire une extension, c’est une décision pour le jour où c’est PHP lui-même qui bloque, pas l’application posée dessus, et on se retrouve rarement là.
La communauté PHP
Tout ce qui se trouve dans ce chapitre, et l’essentiel de ce livre, existe parce que d’autres ont fait leur travail en public : des extensions, des frameworks, des standards, des RFC. Trouver ces gens n’est pas tant une étape suivante qu’un raccourci à travers toutes les autres.
L’entrée la plus proche est un groupe d’utilisateurs : des rencontres locales, souvent mensuelles, généralement recensées sur des sites comme php.ug. Peu d’efforts, et la façon la plus rapide de croiser d’autres développeurs PHP en personne et d’entendre les problèmes qu’ils résolvent vraiment.
Viennent ensuite les conférences. PHP UK, phpDay, SymfonyCon, Laracon et bien d’autres, partout dans le monde. Les conférences elles-mêmes comptent moins que les conversations de couloir entre deux sessions. Dans un cas comme dans l’autre, elles rappellent que le langage a un présent bien vivant, et pas seulement le passé que l’avant-propos a regardé en face.
Certaines de ces personnes écrivent les standards que vous utilisez sans y penser. Le PHP-FIG, le Framework Interop Group, est derrière les PSR sur lesquelles ce livre s’est appuyé en silence tout du long : l’autoloading PSR-4 du chapitre 7, le style PSR-12 de l’annexe D. Ses propositions et ses réunions sont publiques.
D’autres font évoluer PHP lui-même. L’annexe G a décrit le processus des RFC. Les discussions derrière chaque RFC, sur internals@lists.php.net, sont ouvertes à la lecture et, un jour, ouvertes à votre participation.
Et vous pouvez contribuer. Au code source ou à la documentation de PHP, ou à n’importe lequel des paquets open source sur lesquels reposent les projets de cette communauté, dont un grand nombre vivent sur Packagist, connu depuis le chapitre 16. Corriger une faute dans une page de documentation est une première contribution petite, légitime et sincèrement bienvenue, et une bonne façon de découvrir comment s’organise une base de code bien plus vaste que toutes celles de ce livre.
La façon la plus rapide de dépasser ce livre est de parler à ceux qui l’ont déjà dépassé. À chaque destination de ce chapitre, quelqu’un se tient déjà, heureux d’expliquer ce qu’il y a trouvé. Allez lui demander.
Annexes
Les chapitres qui précèdent sont faits pour être lus. Cette partie est faite pour être consultée. Personne ne connaît par cœur la liste complète des mots réservés de PHP, et personne n’a à la connaître : c’est à ça que servent les annexes.
Elles sont au nombre de huit. A liste les mots réservés que vous ne pouvez pas utiliser comme identifiants. B est une table de référence des opérateurs et des symboles. C rassemble en un seul endroit les interfaces SPL et les méthodes magiques dispersées dans les chapitres précédents. D fait le tour des outils à installer une fois les bases acquises. E traite des versions de PHP et de la rétrocompatibilité. F et G sont plus courtes encore : l’état des traductions, et un aperçu de la façon dont PHP lui-même se décide. H relie chaque fonctionnalité abordée dans ce livre à son entrée dans le PHP Dictionary en ligne.
Parcourez-les maintenant si vous voulez, mais elles vous serviront surtout le jour où, en plein projet, vous ne saurez plus si c’est ??= ou ?=.
A - Mots réservés
Les mots qui suivent sont réservés par PHP. Vous ne pouvez utiliser aucun d’eux comme nom de variable, de fonction, de classe, de constante ou d’espace de noms : l’analyseur syntaxique se les est déjà appropriés pour autre chose.
Structures de contrôle
if · else · elseif · endif · while · endwhile · do · for · endfor · foreach · endforeach · as · switch · endswitch · case · default · match · break · continue · goto · return · yield
Classes
class · interface · trait · enum · extends · implements · new · clone · instanceof · abstract · final · public · protected · private · readonly · static · const · var · function · fn · use
Gestion des erreurs
try · catch · finally · throw
Espaces de noms et inclusions
namespace · use · require · require_once · include · include_once
Autres
echo · print · declare · enddeclare · global · list · array · isset · unset · empty · exit · die · and · or · xor · not · int · float · bool · string · null · true · false · void · mixed · never · self · parent
Le dernier groupe, celui des noms de types (int, string, null, true, false et les autres), mérite une remarque : ces mots ne sont devenus réservés que progressivement, au fur et à mesure que PHP en a fait de vraies déclarations de type. Du code ancien utilise parfois String ou Int comme nom de classe, du temps où c’était encore permis. Ça ne l’est plus.
use apparaît dans deux groupes parce qu’il fait deux travaux sans rapport : importer des noms depuis un espace de noms (chapitre 7) et capturer des variables dans une closure (chapitre 15). Même mot, même réservation, contexte différent.
Aucun de ces mots ne peut être détourné, même si le nom irait parfaitement à votre code. Essayez de nommer une variable $class : celle-là passe, en fait, car les mots réservés ne bloquent que les identifiants nus, pas les noms de variables derrière le $. Essayez de nommer une fonction list() ou une classe Match, et PHP vous arrêtera à l’analyse du fichier, pas à l’exécution. Mieux vaut là qu’en production.
B - Opérateurs et symboles
Une table de référence, groupée par ce que les opérateurs font plutôt que par ordre alphabétique. L’ordre alphabétique est parfait pour un dictionnaire et désastreux pour retenir quoi que ce soit.
Arithmétique
| Opérateur | Signification |
|---|---|
+ | Addition |
- | Soustraction |
* | Multiplication |
/ | Division |
% | Modulo (reste de la division) |
** | Puissance |
Affectation
| Opérateur | Signification |
|---|---|
= | Affectation |
+= -= *= /= | Opération arithmétique, puis affectation |
.= | Concaténation, puis affectation |
%= **= | Modulo ou puissance, puis affectation |
Chaque opérateur d’affectation combinée est un raccourci : $x += 1 est exactement $x = $x + 1, en plus court et, une fois l’habitude prise, plus lisible d’un coup d’œil.
Comparaison
| Opérateur | Signification |
|---|---|
== | Égal, après conversion de type |
=== | Identique : même type et même valeur, sans conversion |
!= <> | Différent |
!== | Non identique |
< > <= >= | Inférieur, supérieur, et leurs variantes « ou égal » |
<=> | Vaisseau spatial |
L’opérateur vaisseau spatial (<=>) compare deux valeurs et renvoie -1, 0 ou 1, pour inférieur, égal ou supérieur. C’est exactement la réponse à trois issues qu’attendent les fonctions de tri :
<?php
$numbers = [5, 3, 8, 1];
usort($numbers, fn($a, $b) => $a <=> $b);
Avant son arrivée, cette comparaison prenait trois lignes de if. Maintenant, un seul opérateur fait ce qu’il annonce.
Préférez === à == par défaut, pour les raisons données au chapitre 3.
Logique
| Opérateur | Signification |
|---|---|
&& | Et |
|| | Ou |
! | Non |
and or xor | Formes en toutes lettres du et, du ou et du ou exclusif |
and et or font le même travail que && et ||, mais avec une priorité bien plus basse, assez basse pour perdre face à =. Ceci compile, et ne fait pas ce qu’on croit :
<?php
$result = false or true;
var_dump($result); // bool(false)
= est prioritaire sur or, donc cette ligne se lit en réalité ($result = false) or true : $result reçoit false, et le or true est jeté comme une expression sans effet. Remplacez par || et tout rentre dans l’ordre. Tenez-vous-en à && et ||. Laissez and, or et xor de côté, sauf si vous avez appris par cœur leur table de priorité, ce qui ne vaut pas la peine.
Chaînes de caractères
| Opérateur | Signification |
|---|---|
. | Concaténation |
.= | Concaténation et affectation |
Tableaux
| Opérateur | Signification |
|---|---|
+ | Union : en cas de conflit, les clés du tableau de gauche gagnent |
... | Décomposition : déverse les éléments d’un tableau dans un autre, ou dans un appel de fonction |
Le + des tableaux n’est pas une fusion. Le chapitre 8 explique la différence entre + et array_merge(), qui traitent les clés en double de façon opposée.
Autour de null
| Opérateur | Signification |
|---|---|
?? | Coalescence : la partie droite, seulement si la partie gauche est null ou non définie |
??= | Affectation par coalescence |
?-> | Accès nullsafe à une méthode ou une propriété |
<?php
$name = $user->name ?? 'Anonymous'; // fall back if null
$config['retries'] ??= 3; // set only if not already set
$city = $user?->address?->city; // null, not a fatal error, if either is null
Les trois sont traités en détail au chapitre 6.
Autres symboles
| Symbole | Signification |
|---|---|
$ | Marque un nom de variable |
-> | Accède à une propriété ou une méthode d’une instance |
:: | Accède à une propriété statique, une méthode statique, une constante de classe, ou au parent depuis l’intérieur d’une classe |
#[...] | Attribut : métadonnée structurée attachée à une classe, une méthode ou une propriété |
Les attributs sont le plus récent des quatre, et le chapitre 20 leur est consacré.
C - Interfaces natives et méthodes magiques
Deux tables de référence : les interfaces SPL qui branchent vos objets sur les mécanismes intégrés du langage, et les méthodes magiques qui permettent à vos objets de s’insérer dans un comportement que PHP gérerait sinon tout seul.
Interfaces natives
| Interface | Ce que son implémentation vous apporte |
|---|---|
Countable | Vos objets fonctionnent avec count() |
ArrayAccess | Vos objets acceptent la syntaxe $obj[$key] : lecture, écriture, isset et unset |
Iterator | Vos objets se parcourent directement dans foreach, avec un contrôle total sur l’itération |
IteratorAggregate | Vos objets se parcourent dans foreach en déléguant à un autre itérateur, souvent un Generator |
Stringable | Vos objets s’utilisent partout où une chaîne de caractères est attendue |
Stringable fait bande à part : elle a été ajoutée en PHP 8 et vous avez rarement besoin de l’implémenter vous-même, car toute classe qui définit __toString() est automatiquement considérée comme l’implémentant. Elle existe surtout pour qu’une déclaration de type puisse dire « n’importe quoi d’affichable » sans énumérer toutes les classes qui se trouvent avoir une méthode __toString().
Des exemples complets des cinq, y compris ce qu’Iterator exige de vous et qu’IteratorAggregate ne demande pas, sont au chapitre 20.
Méthodes magiques
| Méthode | Appelée quand |
|---|---|
__construct | Un objet est créé |
__destruct | Un objet est sur le point d’être détruit |
__get | On lit une propriété inaccessible ou non définie |
__set | On écrit dans une propriété inaccessible ou non définie |
__call | On appelle une méthode d’instance inaccessible ou non définie |
__callStatic | On appelle une méthode statique inaccessible ou non définie |
__toString | L’objet est utilisé dans un contexte de chaîne de caractères |
__invoke | L’objet est appelé comme s’il était une fonction |
__clone | L’objet est dupliqué avec clone |
« Magique » est le mot de PHP pour les méthodes que le langage appelle à votre place, par convention de nommage, plutôt que vous directement. Utiles pour construire des propriétés chargées à la demande ou des proxys fluides, elles glissent facilement vers un code que personne ne peut suivre en le lisant. Le chapitre 17 les traite en entier, compromis compris.
D - Outils de développement utiles
Ce livre a déjà traité deux de ces outils en bonne et due forme. Les autres sont ceux à installer ensuite : pas une documentation exhaustive de chacun, juste de quoi savoir à quoi il sert et pourquoi les développeurs PHP en activité s’en donnent la peine.
Composer
Traité à partir du chapitre 7, puis en profondeur au chapitre 16. Gestion des dépendances et autoloading. Vous n’écrirez pas de PHP professionnellement sans lui et, arrivé à ce point du livre, vous ne l’avez d’ailleurs jamais fait.
PHPUnit
Traité au chapitre 12. Le framework de test standard. Si un projet PHP a des tests, ce sont très probablement des tests PHPUnit.
PHPStan et Psalm
Des outils d’analyse statique : ils lisent votre code sans l’exécuter et vous disent où il est faux, ou du moins où il est suspect. Tous deux comprennent le système de types de PHP plus strictement que PHP lui-même à l’exécution. Ils repèrent l’appel d’une méthode qui n’existe pas, un null passé là où le type dit qu’il ne peut pas l’être, un type de retour qui a discrètement cessé de correspondre à ce que la fonction renvoie. C’est exactement le territoire qu’effleure le chapitre 11 avec les génériques en docblock : le système de types de PHP ne sait pas exprimer « un tableau d’objets User », mais une annotation en docblock, lue par PHPStan ou Psalm, permet de vérifier cette promesse à votre place.
Aucun des deux n’est livré avec PHP. Les deux s’installent via Composer, tournent en intégration continue, et méritent d’être ajoutés à un projet dès le premier jour plutôt qu’après la mise en production des bugs qu’ils auraient attrapés.
$ composer require --dev phpstan/phpstan
$ vendor/bin/phpstan analyse src
PHP-CS-Fixer et PHP_CodeSniffer
Du contrôle de style : la question n’est pas « est-ce correct » mais « est-ce formaté comme l’équipe a décidé de formater ». Tous deux savent vérifier une base de code contre PSR-12 (le guide de style standard de PHP) et, plus utile encore, tous deux savent corriger les écarts automatiquement au lieu de simplement les lister.
$ vendor/bin/php-cs-fixer fix src
Choisissez-en un, branchez-le dans votre éditeur ou dans un hook de pre-commit, et arrêtez les débats de style en revue de code : laissez l’outil se disputer à votre place.
Xdebug
Un débogueur pas à pas et un profileur pour PHP. Au lieu de semer des var_dump() dans votre code et de le relancer, Xdebug vous laisse suspendre l’exécution sur un point d’arrêt, inspecter chaque variable en portée, et avancer ligne par ligne, depuis votre éditeur, en temps réel. Il profile aussi, en vous montrant exactement où une requête lente a passé son temps. Traité en détail, installation comprise, au chapitre 13.
Éditeurs et IDE
PHP n’impose aucun éditeur, mais deux valent la peine d’être connus :
PhpStorm : un IDE conçu pour PHP, avec une compréhension profonde et intégrée du langage : refactoring, navigation, et une analyse statique en ligne qui rivalise avec PHPStan sans quitter l’éditeur. Commercial, gratuit pour les étudiants et les mainteneurs de projets open source.
VS Code, avec les extensions PHP (Intelephense ou le pack d’extensions PHP officiel) : gratuit, généraliste, et parfaitement capable une fois configuré. C’est vers lui que se tournent la plupart des développeurs PHP qui n’utilisent pas PhpStorm.
L’un comme l’autre est un bon choix. Ce qui compte, c’est d’en choisir un et de l’apprendre correctement, plutôt que de se battre avec un éditeur à moitié configuré en plus d’apprendre le langage.
E - Versions de PHP et rétrocompatibilité
Rythme des sorties
PHP publie une nouvelle version mineure à peu près une fois par an. Chaque version reçoit environ deux ans de maintenance active (nouvelles fonctionnalités, corrections de bugs, correctifs de sécurité), puis à peu près un an de maintenance limitée à la sécurité avant d’atteindre sa fin de vie. Passé ce point, la faire tourner en production revient à faire tourner un logiciel sans correctifs, ni plus ni moins.
Vérifiez ce que vous utilisez :
$ php -v
PHP 8.3.0 (cli) (built: ...)
Ou depuis l’intérieur d’un script :
<?php
echo phpversion(); // "8.3.0"
Une brève histoire
Le passage de PHP 5 à PHP 7 a été un bond énorme : un moteur réécrit, des performances à peu près doublées, et l’arrivée des déclarations de types scalaires. Le passage de PHP 7 à PHP 8 a été plus modeste en performances brutes mais plus dense en fonctionnalités : le compilateur JIT, les types union, les enums, les attributs, les arguments nommés, l’opérateur nullsafe, la promotion de propriétés dans le constructeur, match. L’essentiel de ce sur quoi ce livre s’appuie (les enums au chapitre 6, les attributs au chapitre 20, la promotion de propriétés au chapitre 5) n’existait pas avant PHP 8. C’est précisément pour cela que ce livre vise PHP 8.1 et suivants.
Fixer une version minimale
Dites à Composer, et à quiconque installe votre paquet, ce dont il a vraiment besoin :
{
"require": {
"php": ">=8.1"
}
}
Ce n’est pas une formalité. Sans cette ligne, Composer laissera volontiers votre paquet s’installer sur une version de PHP qui n’a pas les fonctionnalités que vous utilisez, et l’échec surviendra à l’exécution plutôt qu’à l’installation, ce qui est un bien pire endroit pour le découvrir.
N’ayez pas peur de mettre à jour
PHP prend la rétrocompatibilité au sérieux à l’intérieur d’une version majeure. Du code écrit pour PHP 8.0 tourne, à peu de choses près, sur PHP 8.3. Les avertissements de dépréciation apparaissent en général une ou deux versions avant qu’une chose soit réellement retirée, ce qui vous laisse un vrai préavis plutôt qu’une surprise. Mettre à jour est rarement l’épreuve que la vieille réputation de PHP laisse craindre. Le plus grand risque, en pratique, c’est de rester sur une version qui n’est plus maintenue et de perdre en silence les correctifs de sécurité.
F - Traductions du livre
Ce livre a été écrit en anglais. Vous en lisez la version française. Il n’existe pas d’autre traduction pour le moment.
Si cela change, elles seront listées sur cette page. Si vous avez envie d’en produire une, la conversation vaut la peine d’être ouverte, mais il n’y a rien d’autre à relier aujourd’hui, et cette page ne prétendra pas le contraire.
G - Comment PHP se fabrique (le processus des RFC)
À un moment, en parcourant les enums, match, les attributs et les propriétés readonly, une question finit par venir : qui a décidé que PHP fonctionnerait comme ça ? La réponse est publique, documentée, et plus intéressante que « une entreprise en a décidé ».
Le langage évolue par RFC (Request for Comments), proposées et discutées sur la liste de diffusion internals@lists.php.net. N’importe qui peut en écrire une. Le processus, dans les grandes lignes :
- Quelqu’un rédige une RFC décrivant un changement (une nouvelle syntaxe, une nouvelle fonction, une modification d’un comportement existant), avec sa motivation et, le plus souvent, une implémentation qui fonctionne.
- Elle est publiée sur la liste et discutée en public, souvent pendant des semaines, parfois des mois. La discussion n’est pas une formalité : des RFC sont largement remaniées, ou abandonnées, à cause d’elle.
- Une fois la discussion apaisée, elle passe au vote des membres votants de PHP : des contributeurs établis du cœur du langage, pas le grand public.
- La plupart des RFC qui touchent au langage exigent une majorité des deux tiers. Certains changements plus étroits se contentent d’une majorité simple ; la page décrivant le processus précise quel seuil s’applique à quelle catégorie de changement.
Chaque RFC terminée vit sur wiki.php.net/rfc, décompte des votes inclus. Enums, match, attributs, propriétés readonly : tout ce sur quoi ce livre s’est appuyé et qui n’existait pas avant PHP 8 est passé par exactement ce chemin, en général après un vrai désaccord public sur le bien-fondé de l’idée.
Ça vaut la lecture si vous êtes curieux, et ça vaut d’être gardé en tête la prochaine fois qu’un bout de syntaxe PHP vous semblera arbitraire. Quelqu’un a dû le défendre, en public, contre des gens qui défendaient l’inverse.
H - Fonctionnalités PHP couvertes
Chaque chapitre de ce livre introduit un morceau de PHP : un mot-clé, un opérateur, une interface native, un mécanisme du langage. Cette annexe les rassemble en une seule liste, chacun relié à son entrée dans le PHP Dictionary, une référence indépendante et en croissance constante des termes, mots-clés, fonctions et du jargon de PHP. Servez-vous-en comme d’un glossaire : quand un terme d’un chapitre précédent revient et que vous voulez la version courte, sans avoir à retrouver le chapitre qui l’a introduit.
Quelques éléments ci-dessous n’ont pas encore d’entrée dans le dictionnaire. Ils sont listés quand même, tels quels, sans lien.
Syntaxe et bases
- Balise d’ouverture
<?php: fait passer l’analyseur du mode HTML au mode PHP. - Balise courte d’affichage
<?= ?>: raccourci qui combine<?phpet unechoimmédiat. echoetprint: les constructions d’affichage, traitées au chapitre 1.- Interpolation de chaînes : insérer des variables directement dans une chaîne entre guillemets doubles.
- Commentaires et docblocks :
//,#,/* */, et la forme structurée/** */que les outils lisent, au chapitre 3.
Types et comparaison
- Conversion implicite de type : la conversion automatique entre types que PHP effectue selon le contexte.
- Transtypage : la conversion explicite avec
(int),(string)et les autres. - Booléen,
gettype(),var_dump(): le système de types scalaires et comment l’inspecter, au chapitre 3. declare(strict_types=1): désactive la coercition implicite des scalaires pour un fichier.- Opérateur d’identité
===, opérateur d’égalité==, comparaison souple : les deux familles de comparaison et là où elles divergent. - Opérateur vaisseau spatial
<=>: comparaison à trois issues, renvoie-1,0ou1. - Types union : un type de paramètre ou de retour exprimé comme
int|string. TypeError: levée quand une valeur ne respecte pas une déclaration de type.- Tableau : l’unique type composé de PHP, à la fois liste et dictionnaire, au chapitre 8.
array_key_exists()etisset(): vérifier la présence d’une clé, ou la présence d’une valeur non nulle.
Structures de contrôle
if/elseif/elseet les structures conditionnelles en général.while,do-while,for,foreach: les boucles, au chapitre 3.breaketcontinue: sortir d’une boucle ou passer au tour suivant, avec leur argument numérique facultatif pour les boucles imbriquées.switchetmatch: les deux constructions de branchement par comparaison, l’une instruction, l’autre expression, traitées ensemble au chapitre 6 puis comme syntaxe de motifs au chapitre 19.list()/ déstructuration de tableau et la déstructuration en général : décomposer un tableau en variables séparées en une seule étape, au chapitre 19.
Fonctions et closures
- Déclarations de fonctions, types de retour et valeurs par défaut des paramètres.
void: un type de retour qui déclare qu’une fonction ne renvoie rien d’utile.- Arguments nommés : appeler une fonction par le nom des paramètres plutôt que par leur position.
- Passage par référence et passage par valeur : si une fonction peut ou non modifier la variable de l’appelant.
- Fonctions anonymes et closures : les fonctions comme valeurs, avec capture de variables via
use, au chapitre 15. - Fonctions fléchées (
fn) : des closures à une seule expression, avec capture implicite de la portée englobante. - Syntaxe des callables de première classe
foo(...): transformer la référence à une fonction ou une méthode nommée en véritableClosure. - Générateurs et
yield: des fonctions qui produisent leurs valeurs paresseusement, une à la fois, au chapitre 15.
Classes et objets
- Déclarations de classes,
new,instanceof,clone: le vocabulaire de base de la création d’objets. - Visibilité (
public,protected,private) : contrôler l’accès aux propriétés et aux méthodes. - Promotion de propriétés dans le constructeur et propriétés
readonly: construction raccourcie et propriétés à écriture unique, au chapitre 5. - Propriétés typées : déclarer le type d’une propriété dès le départ.
- Propriétés et méthodes
static, variables statiques et liaison statique tardive : les différents travaux, sans rapport entre eux, du mot-cléstatic. - Héritage,
extendsetparent::: bâtir une classe sur une autre, au chapitre 17. - Classes abstraites et méthodes abstraites : des classes de base qu’on ne peut pas instancier seules.
- Interfaces et traits : contrat partagé contre implémentation partagée, au chapitre 11.
- Constructeur (
__construct), destructeur (__destruct) et les autres méthodes magiques :__toString(),__get()/__set(),__call(), traitées au chapitre 17. - Génériques, via les docblocks : PHP n’a pas de génériques natifs, alors les outils d’analyse statique lisent le type dans un commentaire, comme l’explique le chapitre 11.
Enums
- Enums : cas purs et cas adossés à une valeur, au chapitre 6.
Espaces de noms et autoloading
- Espaces de noms et imports
use: organiser et importer des noms, au chapitre 7. - Autoloading : charger les fichiers de classes à la demande plutôt qu’avec une pile de
require. - PSR-4 : le standard d’autoloading que Composer implémente, traité au chapitre 7. Pas encore dans le dictionnaire, seulement mentionné en passant.
Gestion des erreurs
Exception,Error,Throwable: les deux hiérarchies parallèles de ce qui peut être levé en PHP, au chapitre 9.try/catch/finallyetDivisionByZeroError: attraper et traiter un échec.RuntimeException: l’une des sous-classes d’exception fournies par PHP, utilisée comme base dans le projet en ligne de commande à partir du chapitre 14.- Classes d’exception personnalisées (
extends Exception) : un idiome courant, mais pas encore d’entrée dédiée dans le dictionnaire.
Web et bases de données
- Superglobales,
$_GET,$_POSTet$_SERVER: lire les données d’une requête web, au chapitre 10. htmlspecialchars()et XSS : échapper la sortie pour empêcher le balisage d’un attaquant de s’exécuter dans le navigateur de quelqu’un d’autre, au chapitre 10.- CSRF : les requêtes intersites forgées, nommées mais pas contrées dans ce livre, au chapitre 10.
- PDO,
PDOExceptionet SQLite3 : une façon uniforme, dans un simple fichier, de parler à une base de données, au chapitre 10. - Requêtes préparées et injection SQL : séparer la structure d’une requête de ses valeurs pour empêcher un attaquant de la réécrire.
Débogage
var_dump(),print_r()etvar_export(): afficher la structure d’une valeur (et, pourvar_dump(), son type) quand on traque un bug, au chapitre 13.- Xdebug : un débogueur pas à pas et un profileur, qui suspend l’exécution sur un point d’arrêt au lieu de deviner où afficher, au chapitre 13.
- Profilage : mesurer où un script passe vraiment son temps, l’un des autres métiers de Xdebug.
Concurrence
pcntl: l’extension derrière la création et le contrôle de processus séparés au niveau du système.
Reflection et attributs
- Reflection : inspecter classes, méthodes, propriétés et attributs à l’exécution, au chapitre 20.
- Constantes magiques (
__CLASS__,__FUNCTION__,__METHOD__,__LINE__,__FILE__) : des constantes résolues à la compilation qui décrivent l’emplacement du code lui-même. - Attributs
#[...]: des métadonnées structurées attachées au code et relues via Reflection, au chapitre 20.
Interfaces natives
Countable: fait fonctionnercount()sur un objet à vous.ArrayAccess: autorise l’accès entre crochets sur un objet à vous.IteratoretIteratorAggregate: les deux façons de rendre un objet parcourable parforeach, au chapitre 20.
En vrac
global: ramener une variable depuis la portée globale.- Copie à l’écriture : pourquoi passer un tableau par valeur ne coûte rien tant que personne n’écrit dedans, au chapitre 4.
- Ramasse-miettes : comment PHP récupère la mémoire des objets que plus personne ne référence.
assert(): une vérification de bon sens en phase de développement, au chapitre 12.- PHPUnit : le framework de test utilisé dans toute la seconde moitié du livre.
getenv()et$_ENV: lire les variables d’environnement, au chapitre 14.fwrite(STDERR, ...): écrire sur la sortie d’erreur plutôt que sur la sortie standard.- Mise en tampon de la sortie : capturer la sortie générée dans un tampon au lieu de l’envoyer immédiatement.
register_shutdown_function(): un callback que PHP garantit d’exécuter à la fin d’un script, au chapitre 21.$thisetSTDIN: tous deux utilisés en permanence à partir du chapitre 2, aucun n’a encore son entrée dans le dictionnaire.random_int(): la fonction de PHP pour tirer un entier aléatoire de qualité cryptographique, pas encore listée non plus.
Les trous méritent autant d’attention que les liens. Quelques éléments sur lesquels ce livre s’appuie lourdement, $this, STDIN, PSR-4, les classes d’exception personnalisées, n’ont pas encore d’entrée dans le dictionnaire. Si vous vous surprenez à en expliquer un à quelqu’un, cette explication est déjà l’essentiel d’une entrée de dictionnaire.