Écrire sur la sortie d’erreur
Depuis la première section, phpgrep affiche tout de la même façon. Résultats, message d’usage, texte d’erreur : tout passe par echo, tout atterrit sur le même flux. C’était un problème discret depuis le début, et c’est ici qu’il mord.
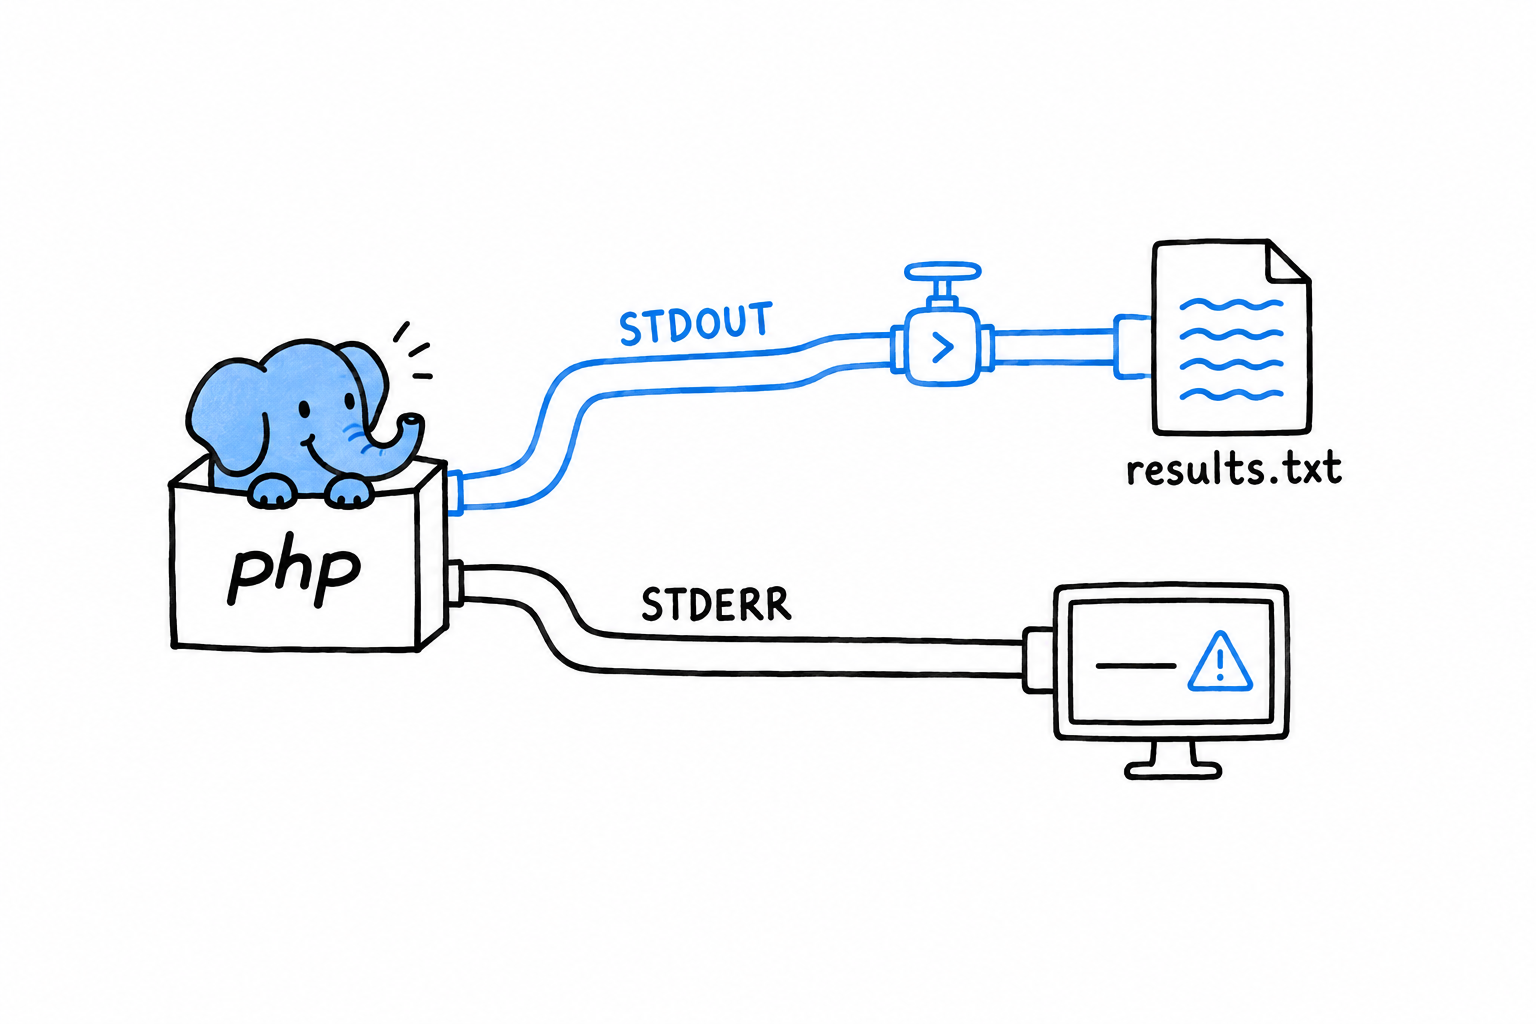
Tout processus a deux flux de sortie, pas un. La sortie standard (STDOUT) est pour les résultats du programme. La sortie d’erreur (STDERR) est pour les diagnostics, les avertissements et les messages d’erreur. echo écrit toujours sur la première. Les erreurs de phpgrep se sont donc retrouvées juste à côté de ses résultats, ce qui ne pose aucun problème tant que vous ne lisez que le terminal. Ça en pose un dès que quelqu’un envoie la sortie de phpgrep ailleurs, ce qui est toute la raison d’être des outils en ligne de commande.
Regardez-le se tromper
$ php phpgrep.php apple missing.txt > results.txt
$ cat results.txt
Error: Cannot read file: missing.txt
Le message d’erreur a atterri dans results.txt. Ce qui lira ce fichier ensuite (un autre script, un rapport, un collègue persuadé qu’il ne contient que des résultats) a maintenant une ligne d’erreur mêlée à ses données, sans rien qui la distingue d’un vrai résultat. Les deux flux existent précisément pour empêcher ce mélange.
Corriger avec fwrite(STDERR, ...)
PHP expose la sortie d’erreur sous la constante STDERR, et fwrite() y écrit directement, sans passer par echo :
<?php
// phpgrep.php
declare(strict_types=1);

require __DIR__ . '/src/GrepOptions.php';
require __DIR__ . '/src/FileNotFoundException.php';
require __DIR__ . '/src/search.php';

function main(array $argv): int
{
    if (count($argv) < 3) {
        fwrite(STDERR, "Usage: php phpgrep.php <query> <filename>\n");
        return 1;
    }

    $options = GrepOptions::fromArgv($argv);

    try {
        $matches = search($options);
    } catch (FileNotFoundException $e) {
        fwrite(STDERR, "Error: {$e->getMessage()}\n");
        return 1;
    }

    foreach ($matches as $line) {
        echo $line . "\n";
    }

    return 0;
}

exit(main($argv));
Deux lignes ont changé, echo est devenu fwrite(STDERR, ...) sur les deux chemins d’erreur, et le comportement vu de l’extérieur n’a plus rien à voir :
$ php phpgrep.php apple missing.txt > results.txt
Error: Cannot read file: missing.txt
$ cat results.txt
$
L’erreur s’affiche toujours immédiatement sur votre terminal. STDERR n’est pas caché, c’est un flux différent, que la redirection de STDOUT par > ne touche pas. Et results.txt est maintenant vide, exactement comme il se doit : aucun résultat, puisque la recherche n’a jamais eu lieu, et aucun texte d’erreur qui se fait passer pour un résultat. Essayez avec un fichier qui contient des correspondances, et la séparation tient : les résultats vont dans results.txt, les erreurs restent à l’écran, et les deux ne se mélangent jamais.
Les résultats vont sur
STDOUT. Tout le reste va surSTDERR.
Les codes de sortie, encore une fois
main() renvoie toujours un int, et exit(main($argv)) en bas du fichier reste le seul endroit où le processus se termine. Cette discipline d’il y a deux sections rend maintenant deux services. C’est elle qui a permis à SearchTest d’appeler search() sans lancer de processus, et c’est elle qui fait de la valeur de retour de main() le vrai code de sortie : 1 sur chacun des chemins d’erreur, 0 quand elle arrive au bout après avoir affiché ce qu’elle a trouvé. N’avoir rien affiché du tout est un succès pour un outil de recherche, pas un échec. Un script shell ou un pipeline d’intégration continue peut enchaîner phpgrep avec d’autres commandes et se fier à ce code, comme il se fie à tout outil Unix bien élevé, sans analyser la sortie de phpgrep pour savoir si ça a marché.
Voilà phpgrep, pour l’instant. Il accepte ses arguments proprement, lit un fichier et y cherche, échoue fort et précisément quand il ne peut pas, s’appuie sur des tests de sa vraie logique, respecte une variable d’environnement, et garde résultats et erreurs sur des flux séparés. Un petit programme, avec très peu de choses à se faire pardonner.
Il reste une amélioration. Le chapitre 15 introduit les générateurs, et revient sur ce projet précis pour une dernière passe.