Les bases du développement web
Ouvrez un navigateur, tapez une adresse, appuyez sur Entrée. Quelque part, un script PHP se réveille, lit ce que votre navigateur a demandé, construit une page et la renvoie. Jusqu’ici, tous les programmes de ce livre tournaient dans un terminal : vous tapiez quelque chose, la réponse s’affichait sur la ligne suivante. Sur le web, ce que vous tapez est une requête HTTP, et la réponse est une page HTML. Le langage est le même. Seules l’entrée et la sortie changent.
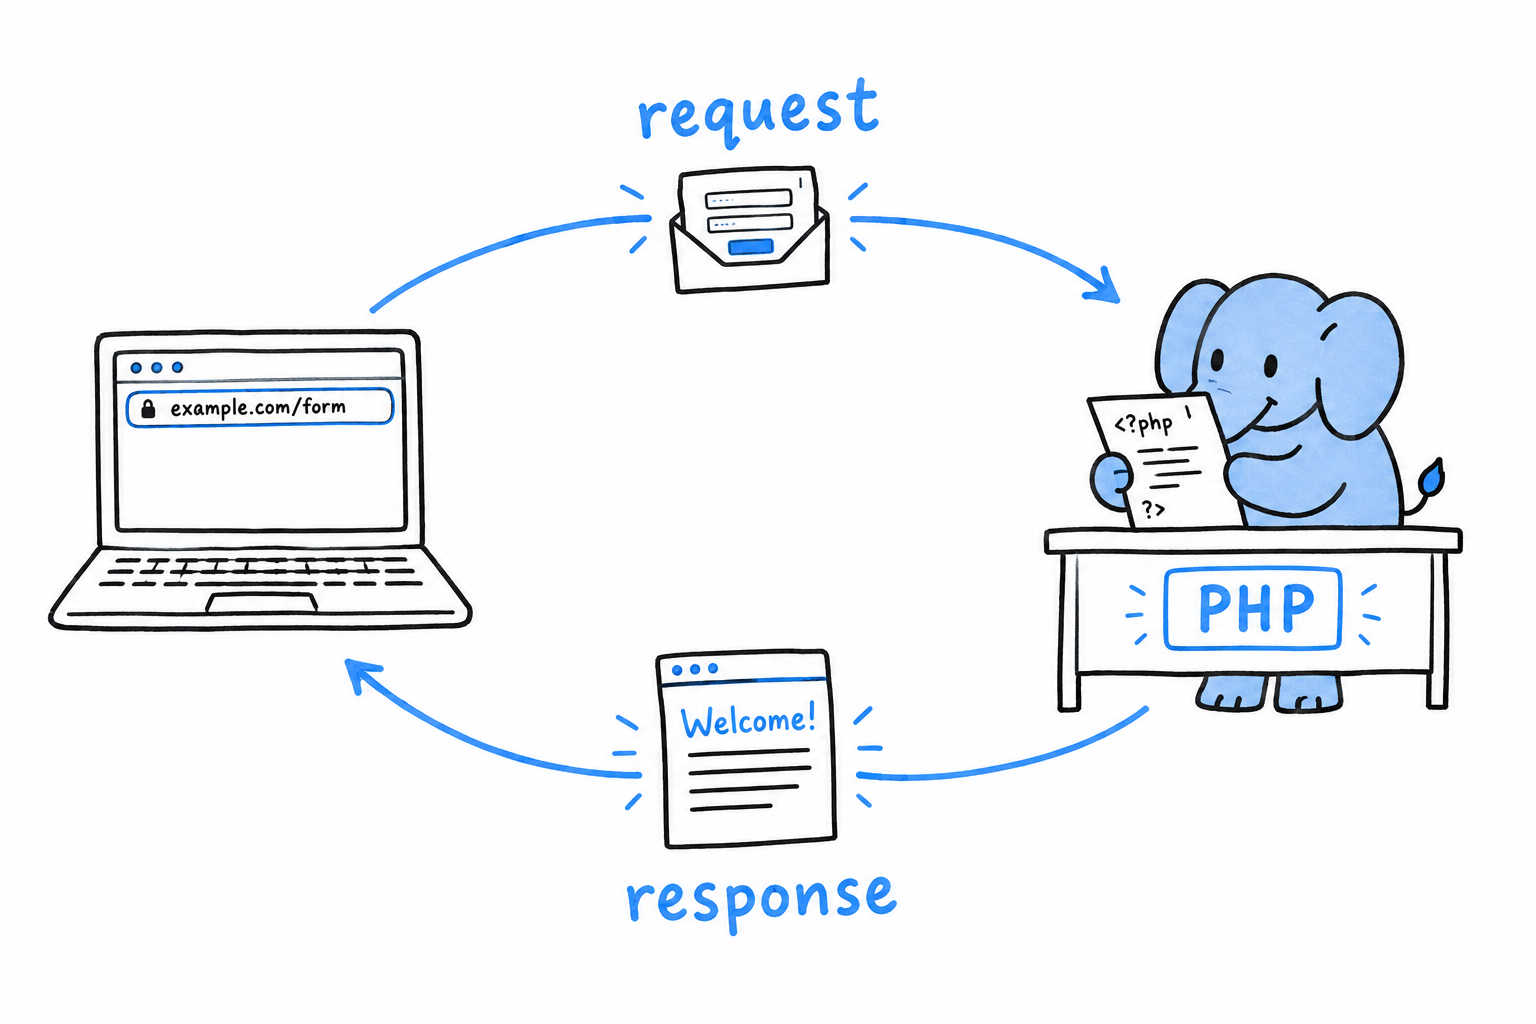
Ce chapitre construit un livre d’or : une page avec un formulaire, un nom et un message, et un script qui lit ce qui a été envoyé, le vérifie, le range, puis affiche tout ce que les visiteurs ont écrit jusque-là. Trois sections, trois couches. D’abord, faire entrer les données du formulaire dans votre script, par les tableaux que PHP remplit pour vous avant même que votre code démarre. Ensuite, s’assurer que ce que vous renvoyez ne permet pas à un visiteur d’en attaquer un autre. Enfin, conserver les messages d’une requête à l’autre, dans une vraie base de données, au lieu de les perdre dès que la réponse est partie.
Rien de tout cela n’aura l’air impressionnant, et c’est voulu. Pas de framework JavaScript, pas de framework CSS, pas d’étape de build : un seul <form> HTML, quelques lignes de style, PHP pour le reste, servi par php -S, le serveur de développement intégré que le projet final du livre utilise lui aussi. La leçon porte sur ce que PHP fait d’une requête, pas sur la configuration d’un bundler.
Tout ce qui suit resservira dans le projet final : lire $_SERVER, échapper la sortie avant qu’elle n’atteigne le HTML, stocker des données sans danger. C’est la matière ordinaire du PHP sur le web, et elle mérite d’être vue pour elle-même, dans la plus petite forme qui ait un sens, avant qu’un routeur et une hiérarchie de classes ne poussent autour.